

Que vous développiez une application naissante ou que vous gériez déjà un service à fort trafic, vous pouvez bénéficier des insights et des recommandations de ce guide pour évoluer en douceur avec FCM. Ces concepts et pratiques peuvent vous aider à éviter les impacts négatifs lorsque vous devez envoyer de grands volumes de messages.
Termes et concepts clés
Demande de message : demande de message FCM. Utilisé de manière interchangeable avec "demande", "message" ou "requête".
Requêtes par seconde (RPS) : métrique décrivant le taux de requêtes entrantes vers FCM. Utilisée de manière interchangeable avec "Requêtes par seconde" (RPS).
Jetons de quota, buckets de jetons et recharges : lorsque vous envoyez des messages à l'API FCM HTTP v1, chaque requête consomme un jeton de quota attribué dans un intervalle de temps donné. Cette fenêtre, appelée "token bucket", se remplit à la fin de la période. Par exemple, l'API HTTP v1 alloue 600 000 jetons de quota pour chaque bucket de jetons d'une minute, qui se remplit à la fin de chaque fenêtre d'une minute.
Limitation côté serveur : lorsque le volume de trafic dépasse la capacité du service FCM, les requêtes dépassant la capacité de diffusion sont rejetées pour limiter le débit d'entrée. Des réponses d'erreur 429 avec des en-têtes retry-after peuvent être renvoyées pour indiquer que vous devez attendre une certaine période avant de relancer la requête.
Limitation côté client : lorsque les clients constatent des échecs de requêtes, une latence élevée ou des erreurs 429, ils doivent limiter volontairement le débit du flux de sortie pour éviter d'aggraver la congestion.
Intervalle exponentiel entre les tentatives : lorsque vous relancez des erreurs, ajoutez des délais qui augmentent de manière exponentielle. Par exemple : 1 s, 2 s, 4 s, 8 s, 16 s, 32 s, etc.
Instabilité : évitez de relancer les requêtes à des intervalles exacts. Avec la gigue, vous faites varier les délais avant nouvelle tentative via un processus aléatoire pour les répartir uniformément dans le temps (par exemple : 0,9 s, 2,3 s, 4,1 s, 8,5 s, 17,9 s, 34,7 s).
Amplification des nouvelles tentatives : lorsque les requêtes ayant échoué sont relancées sans intervalle exponentiel entre les tentatives/gigue, elles s'accumulent souvent et s'ajoutent à la charge de trafic en cours, ce qui peut "amplifier" et aggraver les problèmes de congestion du trafic.
Le problème : les pics de trafic
FCM traite des millions de requêtes par seconde (RPS). Les pics de trafic sont la principale cause de congestion systémique, de problèmes de latence et de pannes.
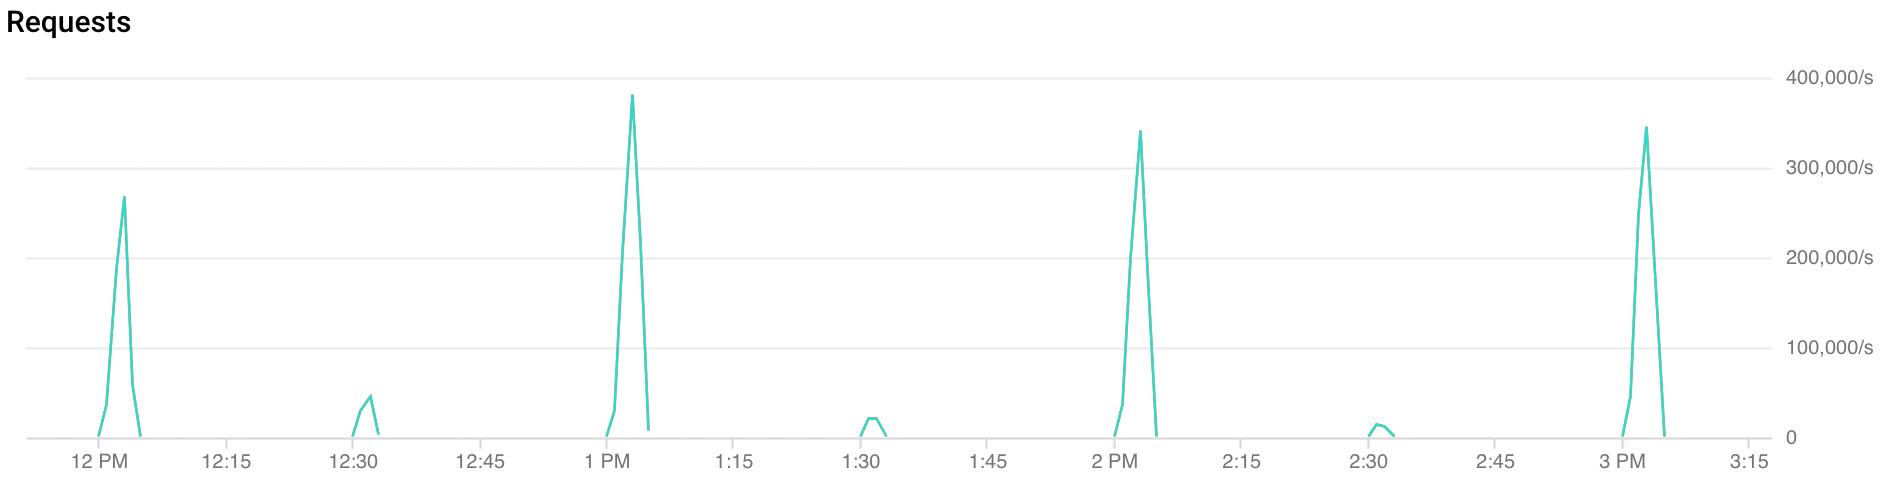
Qu'est-ce qu'un pic de trafic ?
Il existe plusieurs types de pics de trafic.
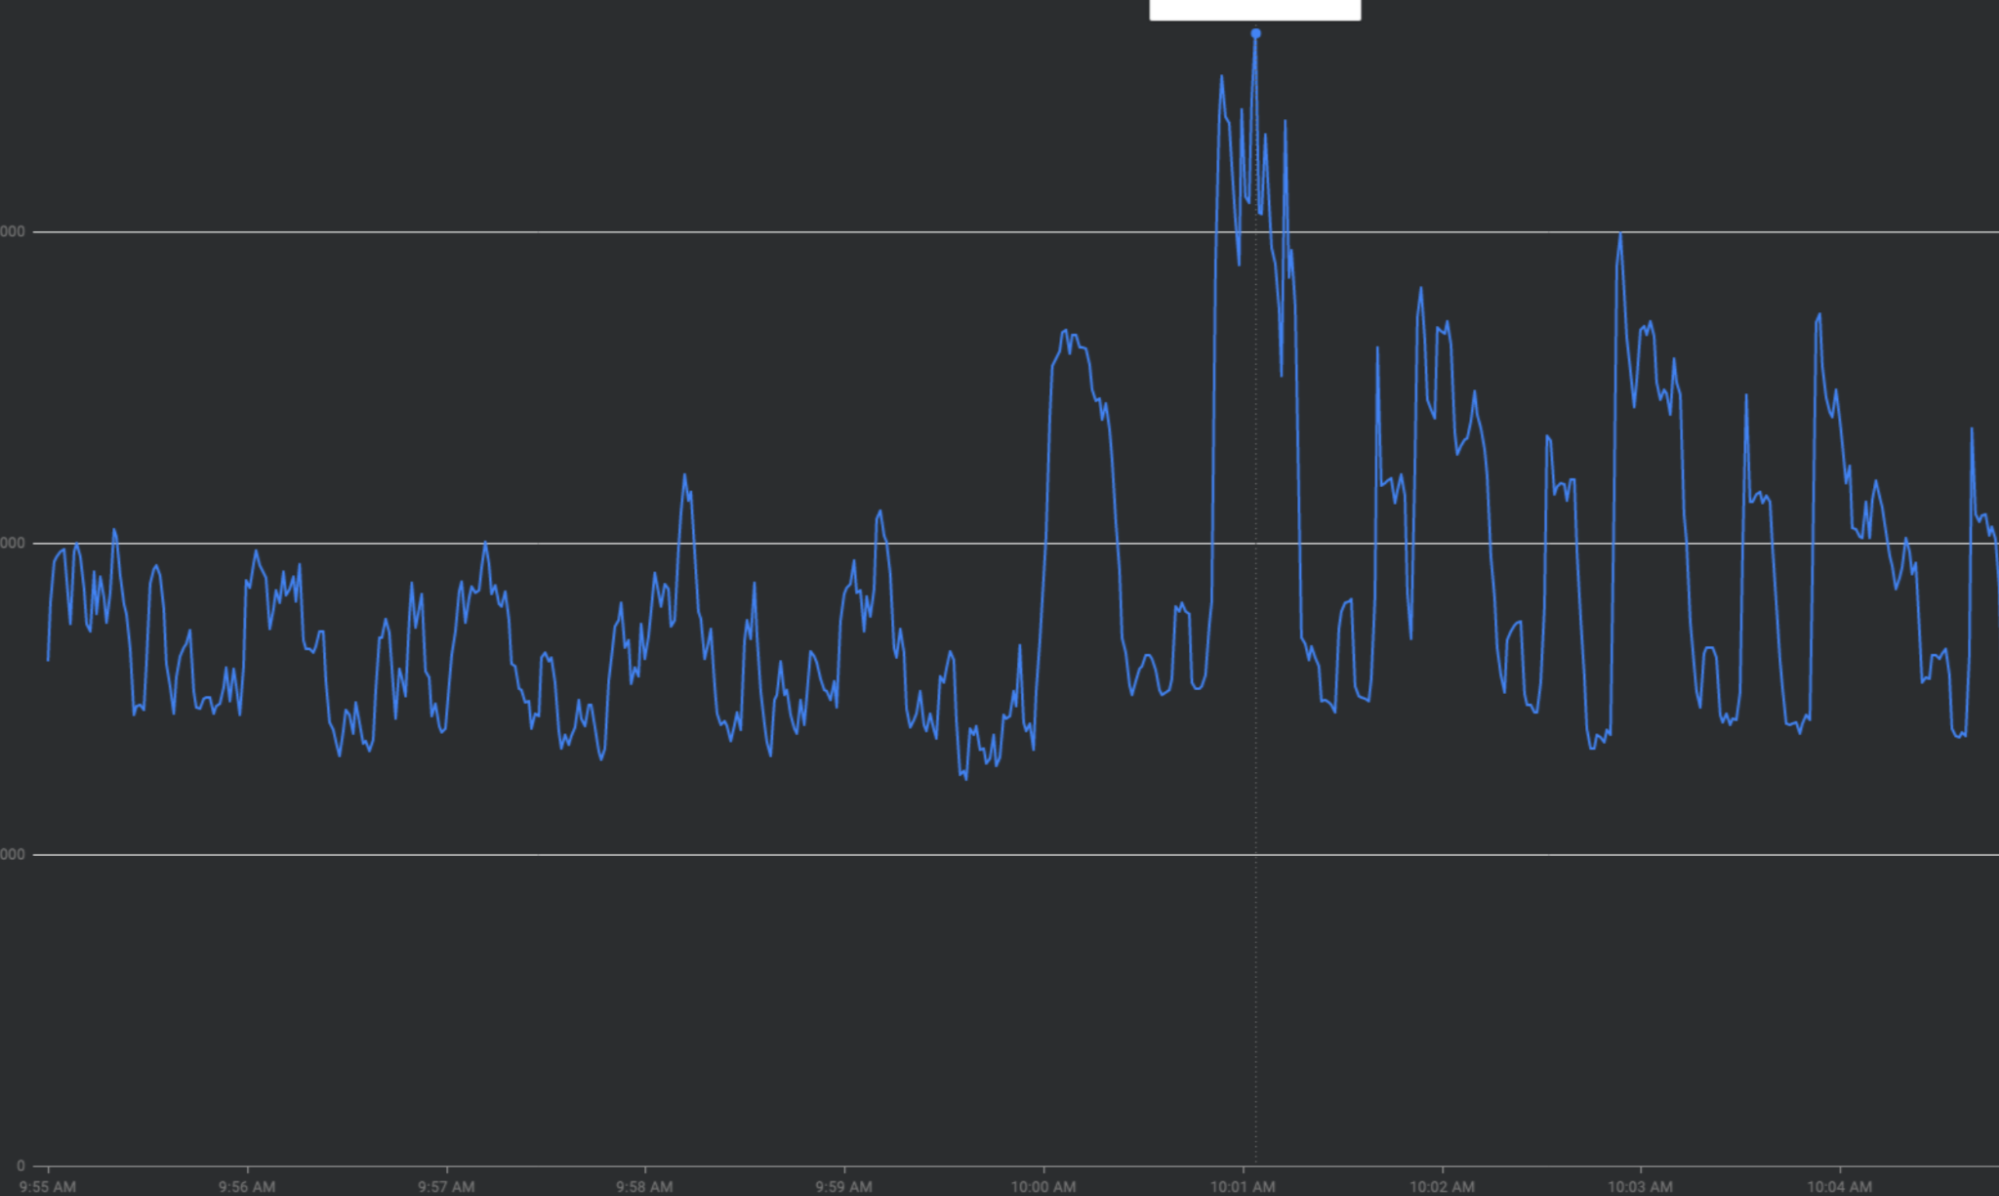
Pics de trafic à chaque heure : FCM reçoit plus du double de trafic pendant les 30 premières secondes à deux minutes de chaque heure. Des pics similaires, bien que moins importants, sont également observés à la demi-heure et au quart d'heure (exemples : 00:15, 00:30, 00:45).
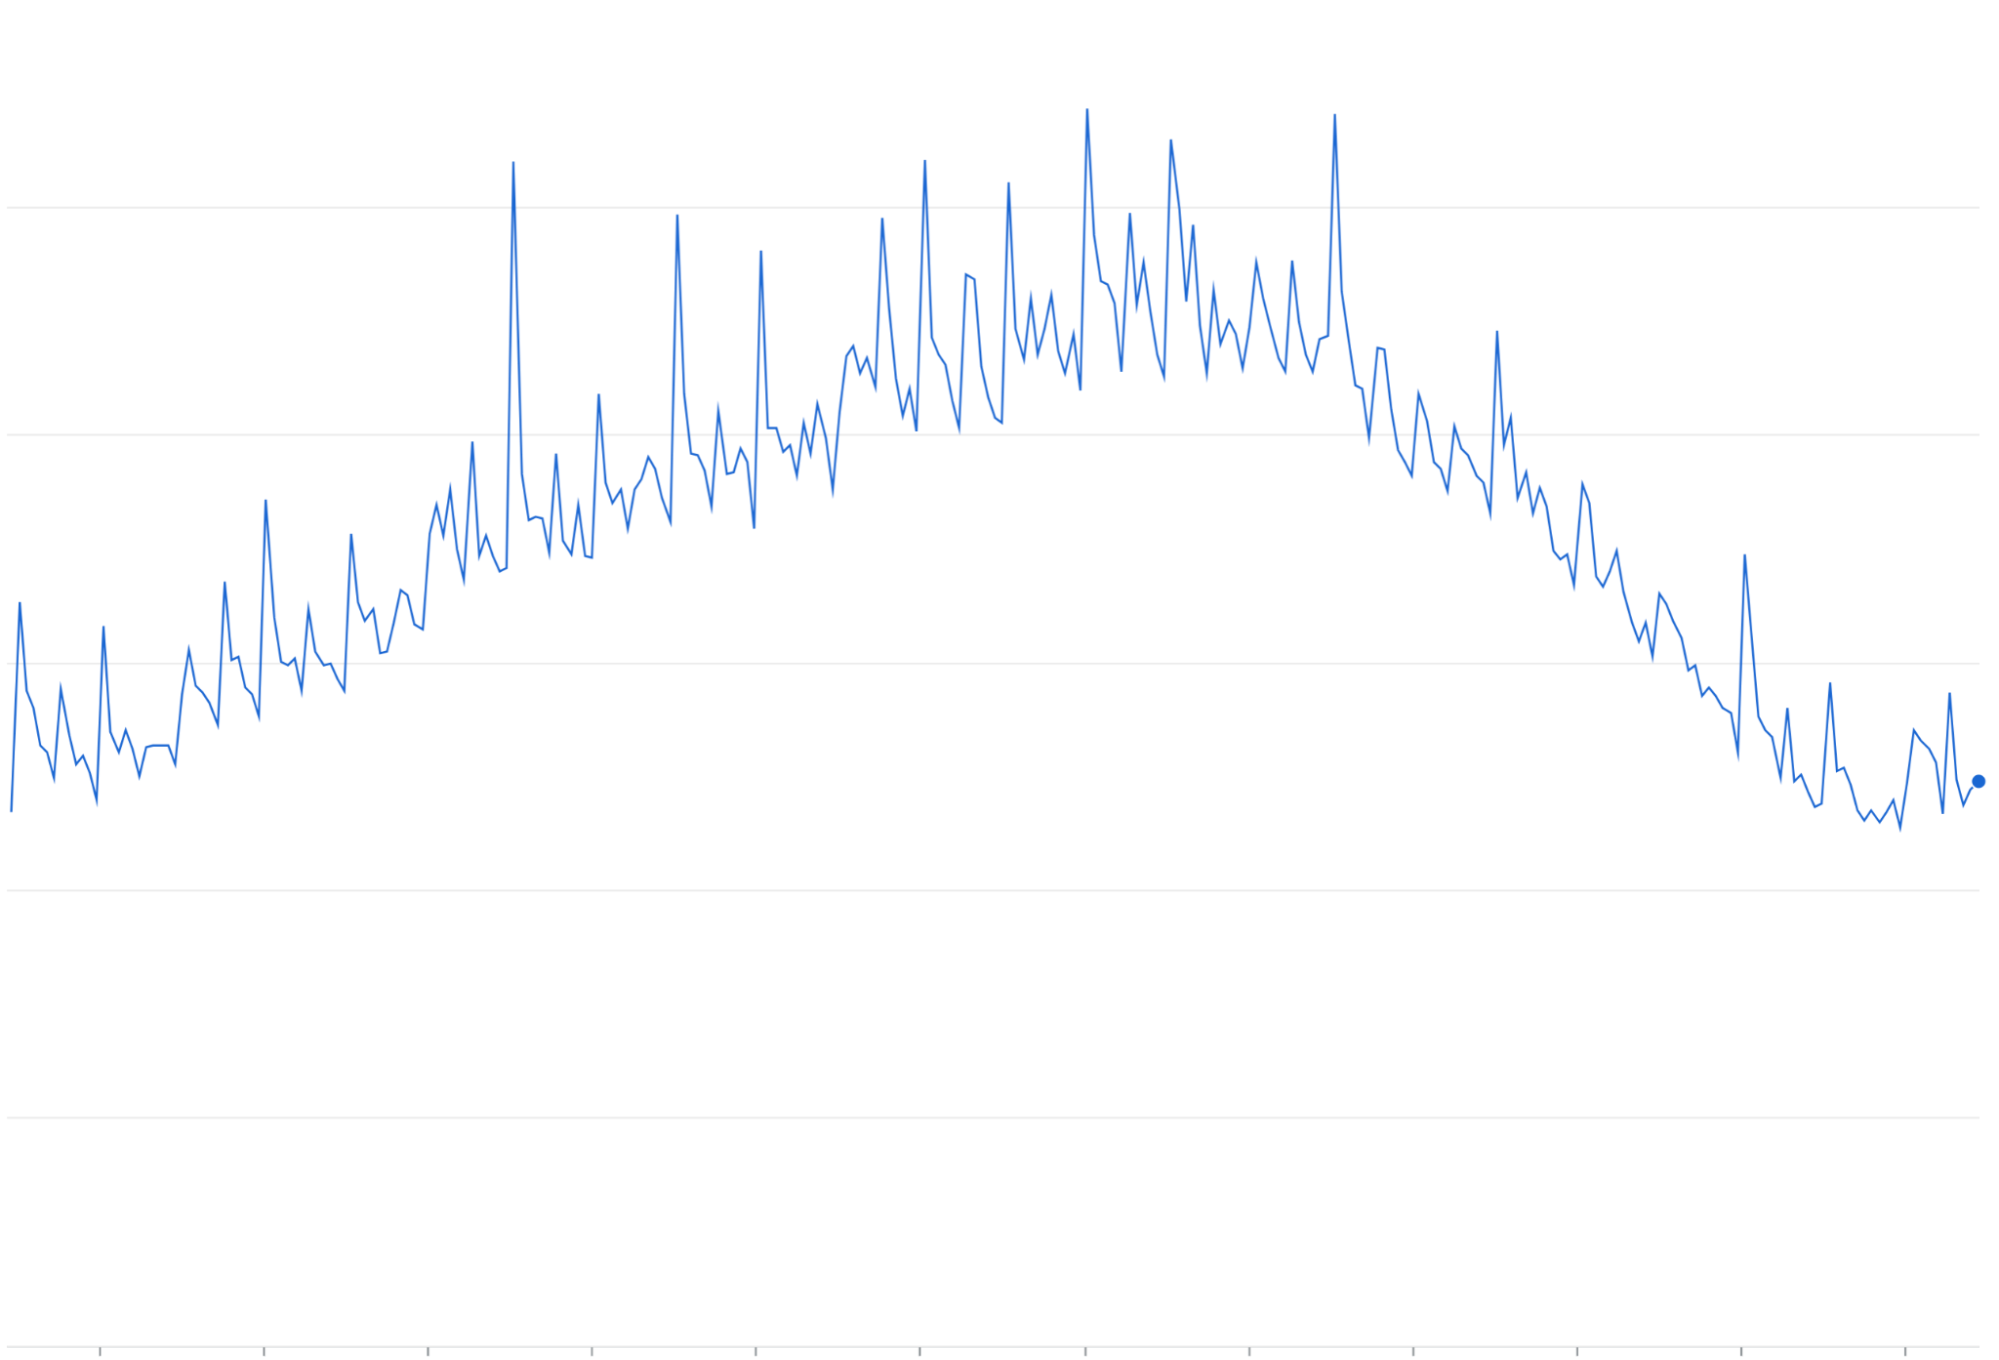
Amplification des nouvelles tentatives : les nouvelles tentatives de requêtes ayant échoué ou ayant expiré sans intervalle exponentiel entre les tentatives peuvent s'accumuler dans des vagues de trafic répétées en plus des pics de trafic existants.
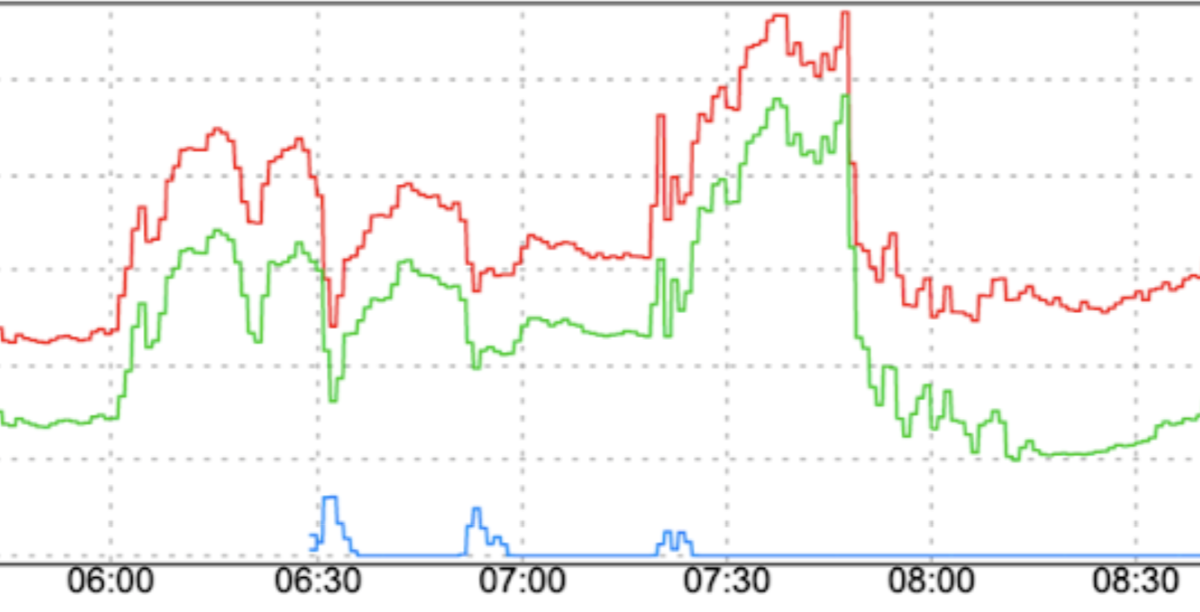
Changements brusques de modèle de trafic : diriger un nouveau trafic vers FCM ou déplacer le trafic vers FCM entre les régions sans facteurs de lissage tels qu'une augmentation progressive peut entraîner des pics.
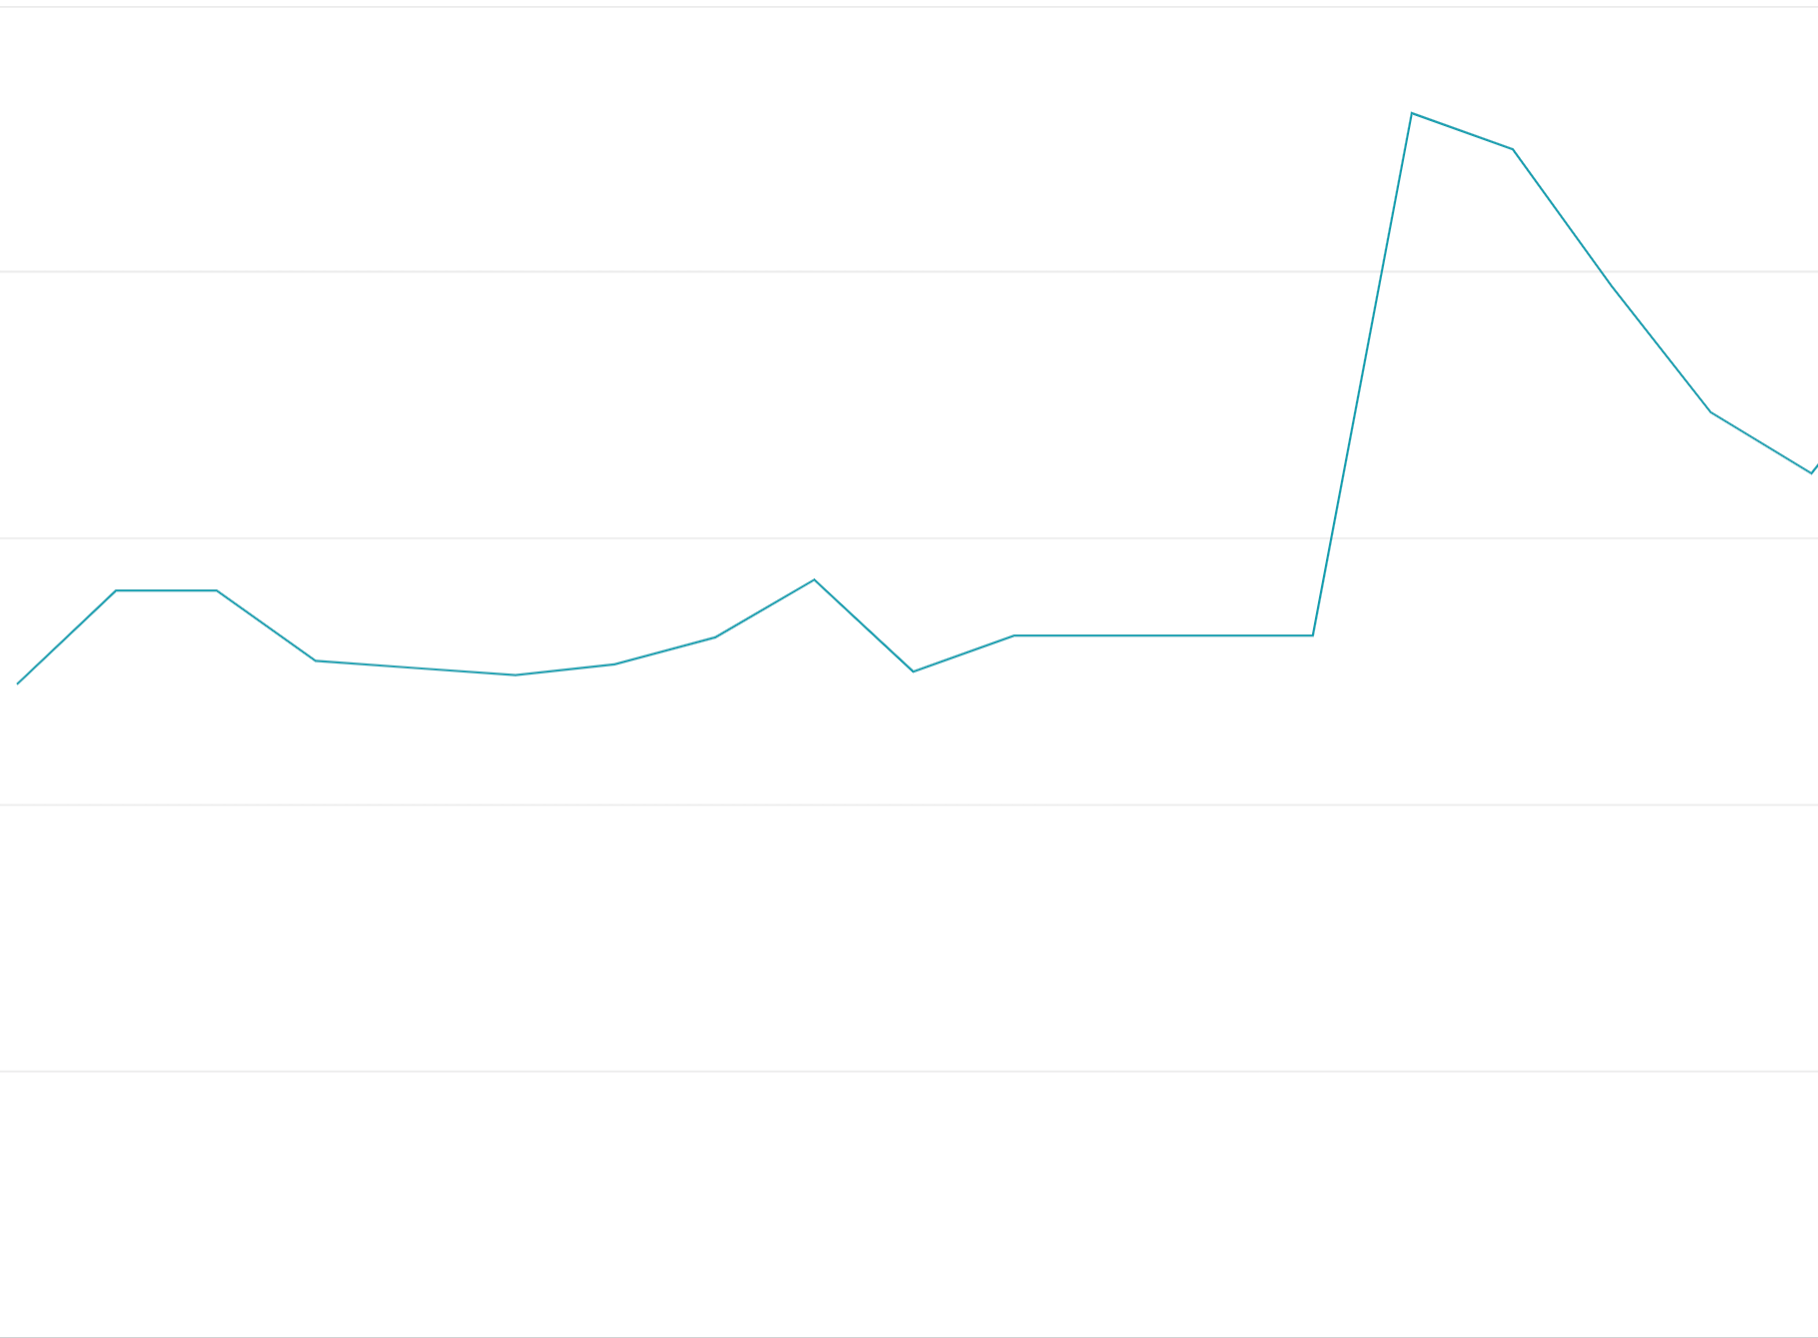
Utilisation des jetons de quota en amont : l'épuisement de tous les jetons de quota au début des fenêtres de quota au lieu de répartir les requêtes de manière uniforme sur les fenêtres de quota crée des oscillations ponctuelles difficiles et coûteuses à équilibrer.
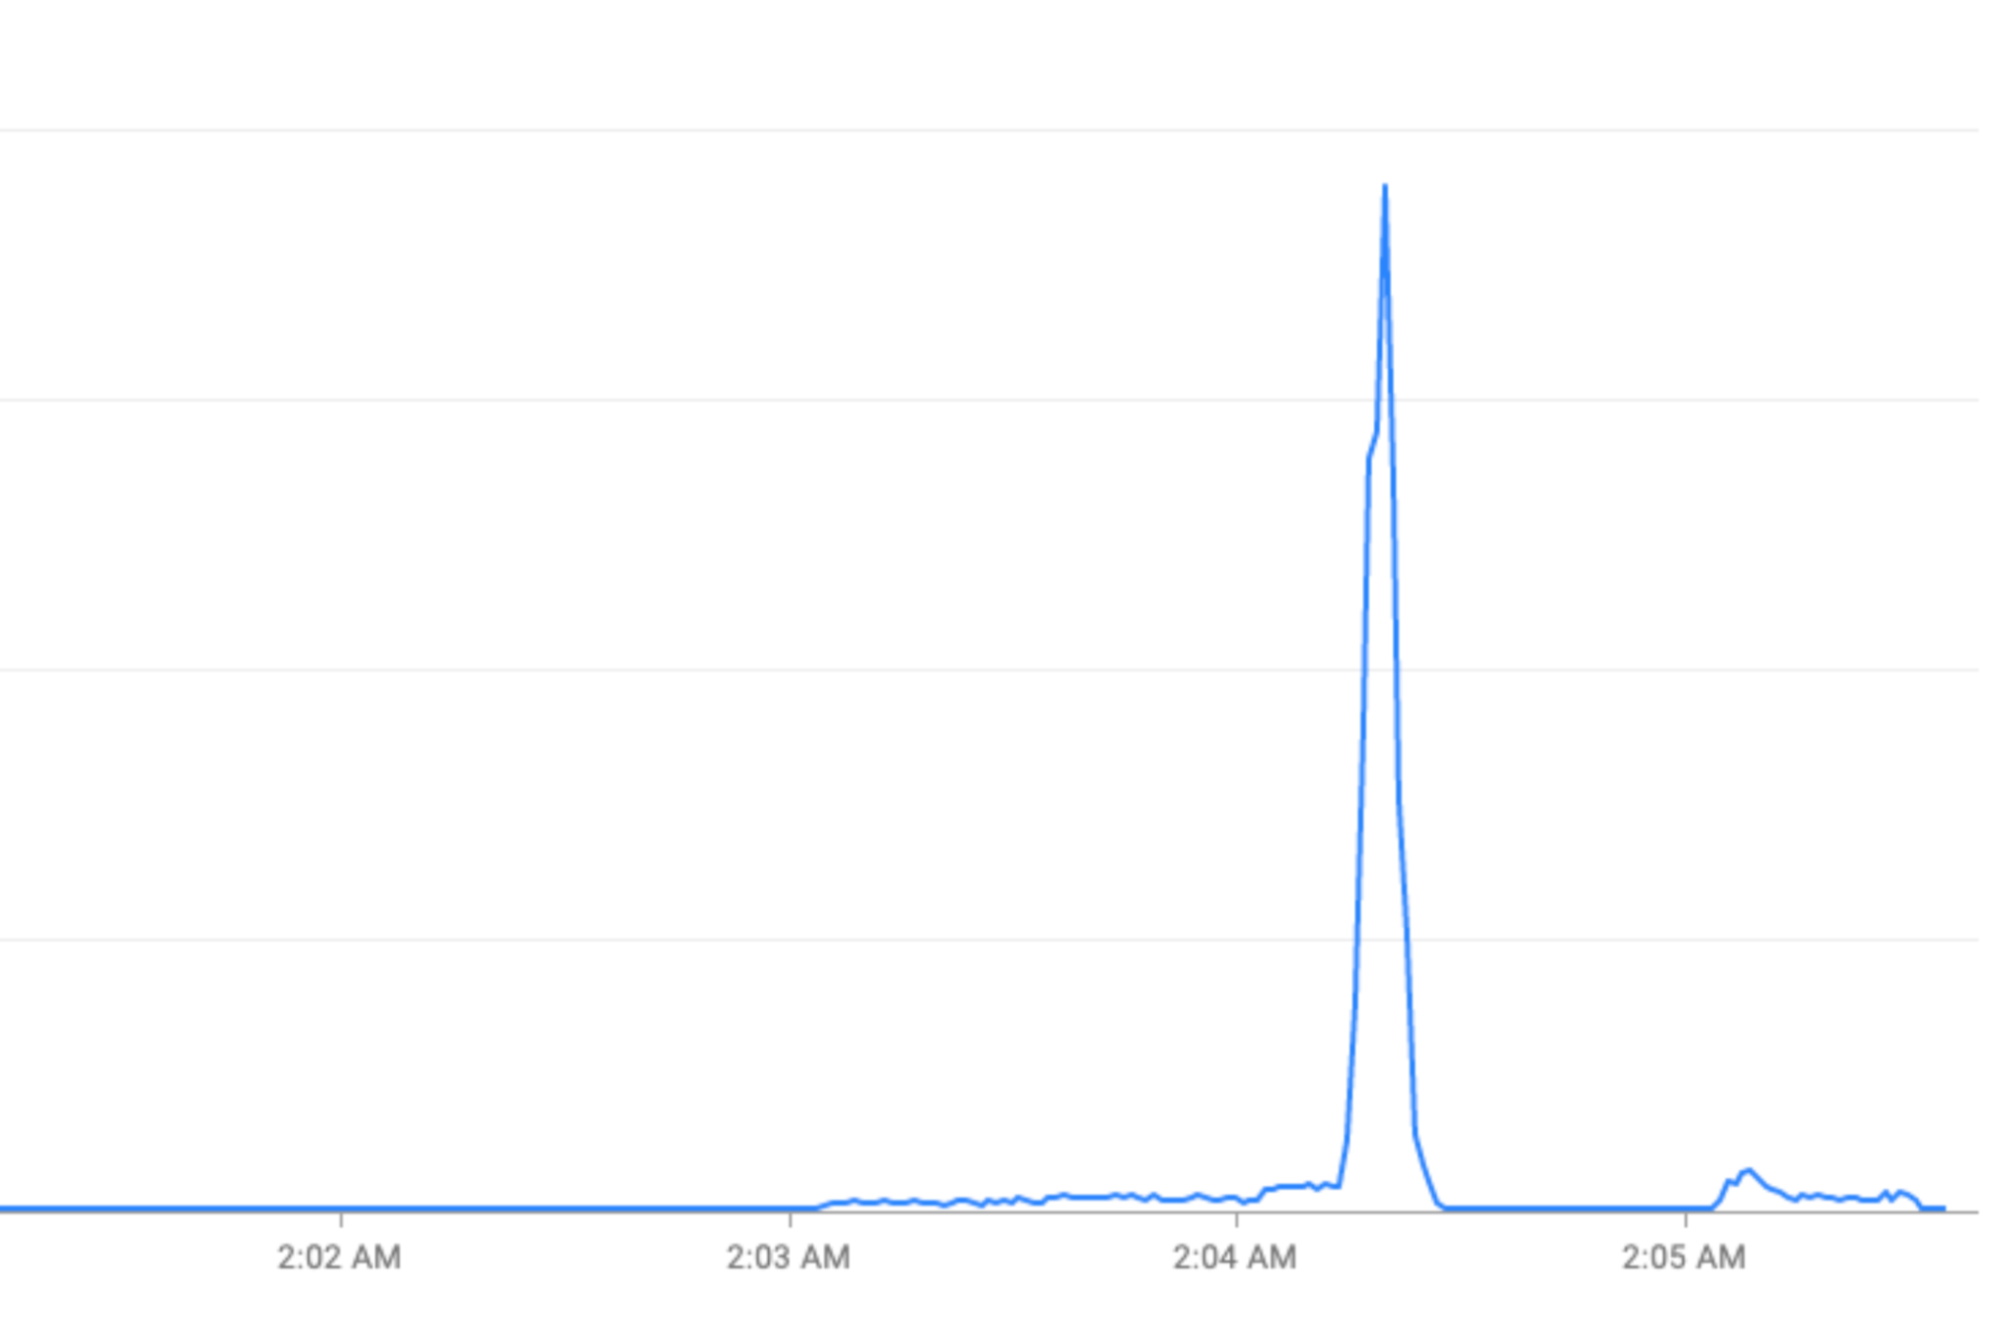
Événements spéciaux : pics de trafic pendant les fêtes (Nouvel An) ou les événements sportifs (Coupe du monde de la FIFA).
Remédier aux pics de trafic en "aplatissant la courbe"
Cette section décrit les stratégies permettant de lisser les pics de trafic dans la mesure du possible, c'est-à-dire les stratégies permettant d'"aplatir la courbe".
Utilisez FCM uniquement pour les cas d'utilisation appropriés.
Dans certains cas d'utilisation, l'utilisation de FCM pour envoyer une notification n'est pas nécessaire ni appropriée.
Par exemple, pour les notifications d'événements d'agenda, vous pouvez planifier une tâche locale dans votre application pour afficher une notification aux moments appropriés au lieu de l'envoyer depuis le serveur de votre application. Limitez les messages FCM aux synchronisations d'agenda.
Éviter les pics
Un anti-modèle de scaling consiste à envoyer des notifications FCM aussi rapidement que les systèmes le permettent, au lieu d'appliquer une limitation côté serveur. Réfléchissez aux éléments suivants :
- Tous vos clients doivent-ils recevoir la même notification dans un délai d'une minute ? Par exemple, un intervalle de livraison de cinq minutes répondrait-il toujours aux besoins de votre entreprise ?
- Vos clients peuvent-ils être segmentés en fonction de leur priorité pour lisser les pics ?
- Vos notifications peuvent-elles être planifiées à l'avance ?
Dans la mesure du possible : évitez les stratégies qui entraînent l'épuisement immédiat de votre quota d'envoi FCM, puis la répétition de ce schéma dès que votre bucket de jetons se remplit. Ce modèle d'accès crée des problèmes d'équilibrage de charge pour FCM et ses systèmes dépendants. Augmentez le trafic aussi progressivement que possible. Au minimum, passez de 0 au nombre maximal de RPS sur une période de 60 secondes. Privilégiez des fenêtres plus longues pour un RPS plus élevé.
Évitez les pics de trafic à l'heure pile
Dans la mesure du possible : évitez d'envoyer des messages dans un intervalle de deux minutes autour des repères :00, :15, :30 et :45.
Implémenter la limitation côté serveur
Implémentez une limitation côté serveur pour surveiller et gérer le flux de trafic vers FCM.
Gérer les nouvelles tentatives
Bien que FCM s'efforce d'être hautement disponible, certaines requêtes peuvent parfois expirer ou échouer. Bien que les raisons varient, les bonnes pratiques suivantes optimisent le comportement des nouvelles tentatives pour distribuer les messages dès que possible, tout en minimisant l'impact sur la congestion du trafic.
Délais avant expiration
Définissez un délai avant expiration d'au moins 10 secondes sur les requêtes d'envoi avant de réessayer. La plupart des appels de procédure à distance internes de FCM utilisent un délai avant expiration de 10 secondes.
Erreurs
- Pour les erreurs 400, 401, 403 et 404 : abandonnez et ne réessayez pas.
- Pour les erreurs 429 : réessayez après avoir attendu la durée définie dans l'en-tête retry-after. Si aucun en-tête retry-after n'est défini, la valeur par défaut est de 60 secondes.
- Pour les erreurs 500 : réessayez avec un intervalle exponentiel entre les tentatives.
Intervalle exponentiel entre les tentatives
Pour éviter l'amplification des nouvelles tentatives, implémentez un intervalle exponentiel entre les tentatives avec gigue pour les requêtes de nouvelle tentative. Par exemple, le SDK Admin Firebase implémente l'intervalle exponentiel entre les tentatives.
Voici d'autres paramètres recommandés :
- Intervalle minimal : ne relancez pas immédiatement une requête ayant échoué avec FCM. Attendez au moins 10 secondes avant de relancer une requête ayant échoué.
- Intervalle maximal : définissez un intervalle maximal pour supprimer les requêtes qui ne sont plus d'actualité, au lieu de réessayer indéfiniment.
Si une requête est relancée en continu avec un intervalle exponentiel entre les tentatives et qu'elle échoue toujours 60 minutes plus tard, elle est soit classée par erreur comme une erreur pouvant être relancée, soit FCM subit une panne où les nouvelles tentatives peuvent aggraver la situation par inadvertance.
Créer des plans de déploiement et de rollback, et apporter des modifications progressives
Lorsque vous apportez des modifications de trafic à grande échelle, par exemple en augmentant le trafic vers FCM ou en déplaçant le trafic entre des régions ou des réseaux, la conception d'un plan de déploiement/restauration et la mise en œuvre de modifications progressives protègent vos utilisateurs, votre service et FCM.
- Un plan de déploiement permet d'aligner les attentes des parties prenantes. Dans certains cas (décrits ci-dessous), vous pouvez partager votre plan de déploiement à l'avance avec l'équipe FCM pour éviter les mauvaises surprises.
- Un plan de rollback vous permet de prendre en compte les imprévus et de préparer des mécanismes pour récupérer rapidement et en toute sécurité après des défaillances inattendues.
- L'apport de changements progressifs comporte deux aspects :
- Augmentations progressives : les étapes doivent être de 1% -> 5% -> 10% -> 25% -> 50% -> 75% -> 100% ou plus précises. Observez le comportement du système sous charge à chaque étape pendant une journée à une semaine. Cela vous permet de repérer les problèmes potentiels avant la prochaine "étape".
- Augmentation progressive du trafic : lorsque vous augmentez le trafic, lissez-le sur une période d'au moins une heure. Cela permet à l'infrastructure d'équilibrage de charge de FCM d'adapter votre nouveau trafic de manière appropriée, tout en minimisant le risque de hotspots et de congestion.
Voici un scénario hypothétique de migration de 500 000 RPS à l'échelle mondiale de l'ancienne API HTTP FCM vers l'API HTTP v1 FCM :
| Semaine | Step | Stratégie d'activation progressive |
|---|---|---|
| 0 | Activation progressive à 1 % | Augmentez progressivement le nombre de RPS de 0 à 5 000 vers FCM HTTP v1 sur une heure. |
| 1 | Activation progressive à 5 % | Augmentez progressivement le trafic de 5 000 à 25 000 RPS sur deux heures. |
| 2 | Activation progressive à 10 % | Augmentez progressivement le trafic de 25 000 à 50 000 RPS sur deux heures. |
| 3 | Activation progressive à 25 % | Augmentation de 50 000 à 125 000 RPS sur trois heures |
| 4 | Activation progressive à 50 % | Augmentation de 125 000 à 250 000 RPS sur six heures |
| 5 | Activation progressive à 75 % | Augmentation de 250 000 à 375 000 RPS sur six heures |
| 6 | Activation progressive à 100 % | Augmentation de 375 000 à 500 000 RPS sur six heures |
Exemple de plan de rollback :
- Si la latence du 95e centile dépasse 500 ms ou si le taux d'erreur dépasse 1% pendant plus d'une heure à n'importe quelle étape, utilisez la configuration dynamique pour revenir immédiatement à l'étape précédente.
- Continuez à effectuer des rollbacks vers les étapes précédentes jusqu'à ce que la latence et le taux d'erreur reviennent à des niveaux nominaux.
Quand contacter FCM
Contactez FCM via l'assistance Firebase si l'un des cas suivants s'applique :
- Les quotas par défaut ne répondent plus à votre cas d'utilisation
- Vous modifiez vos modèles d'envoi sur une période de trois mois à une échelle de 100 000 RPS au niveau mondial ou de 30 000 RPS au niveau continental.