

無論是剛起步的應用程式,還是高流量的服務,都能參考本指南的深入分析和建議,瞭解如何透過 FCM 順利擴充。這些概念和做法可協助您避免在需要傳送大量郵件時產生負面影響。
重要詞彙與概念
訊息要求:FCM 訊息要求,與「要求」、「訊息」或「查詢」交替使用。
每秒要求數 (RPS):描述傳入 FCM 的要求速率指標,與每秒查詢次數 (QPS) 互換使用。
配額權杖、權杖 bucket 和補充:向 FCM HTTP v1 API 傳送訊息時,每項要求都會在指定時間範圍內,消耗分配的配額權杖。這個視窗稱為「權杖 bucket」,會在時間範圍結束時重新填滿。舉例來說,HTTP v1 API 會為每個 1 分鐘權杖 bucket 分配 60 萬個配額權杖,並在每 1 分鐘時間範圍結束時補滿。
伺服器端節流:流量超過 FCM 服務容量時,系統會拒絕超出服務容量的要求,限制輸入流量。系統可能會傳回含有 retry-after 標頭的 429 錯誤回應,表示您應等待一段時間,再重試要求。
用戶端節流:當用戶端發現要求失敗、延遲時間過長或 429 錯誤時,應主動限制輸出流量,避免壅塞情形惡化。
指數輪詢:重試錯誤時,請以指數方式增加延遲時間。例如:1 秒、2 秒、4 秒、8 秒、16 秒、32 秒等。
抖動:避免以固定間隔重試要求。使用抖動時,您會透過隨機程序改變重試延遲時間,以便在一段時間內均勻分配 (例如:0.9 秒、2.3 秒、4.1 秒、8.5 秒、17.9 秒、34.7 秒)。
重試放大:如果重試失敗的要求時,未採用指數輪詢/抖動,這些要求通常會累積並增加持續的流量負載,可能「放大」並加劇流量壅塞問題。
問題:流量高峰
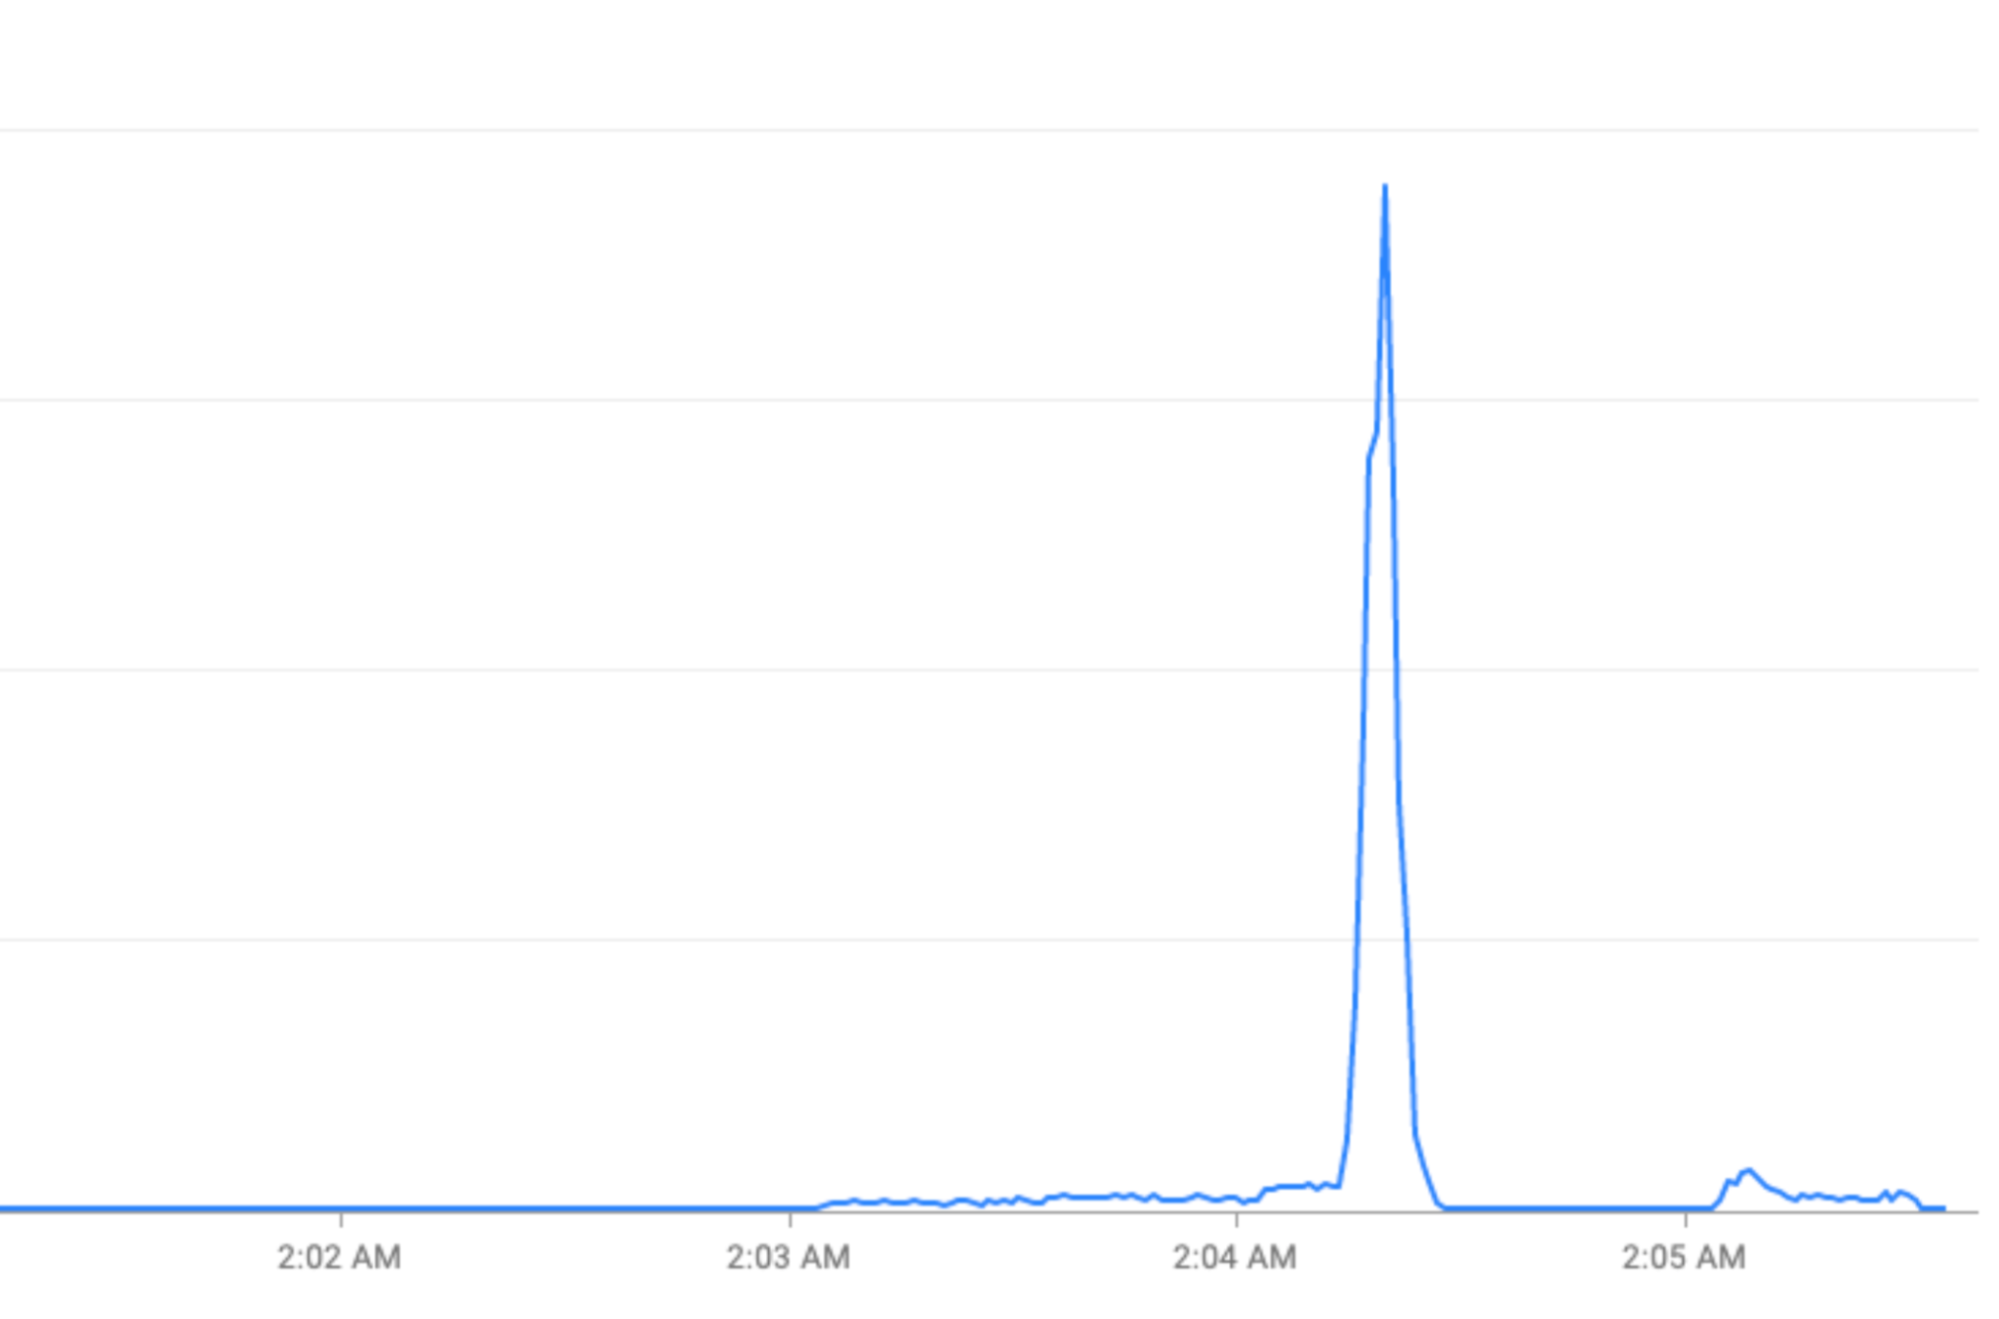
FCM 每秒可處理數百萬個要求 (RPS)。流量暴增是造成系統壅塞、延遲問題和服務中斷的最大原因。
什麼是流量激增?
流量激增有幾種不同類型。
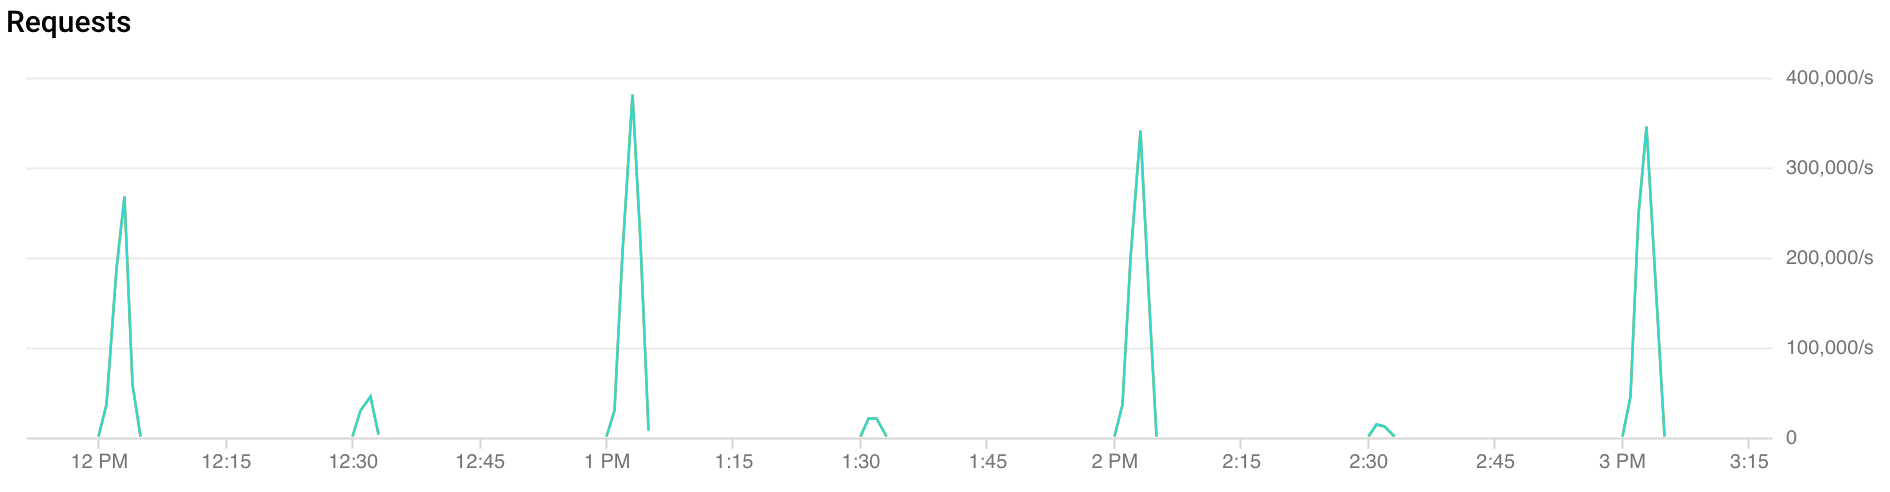
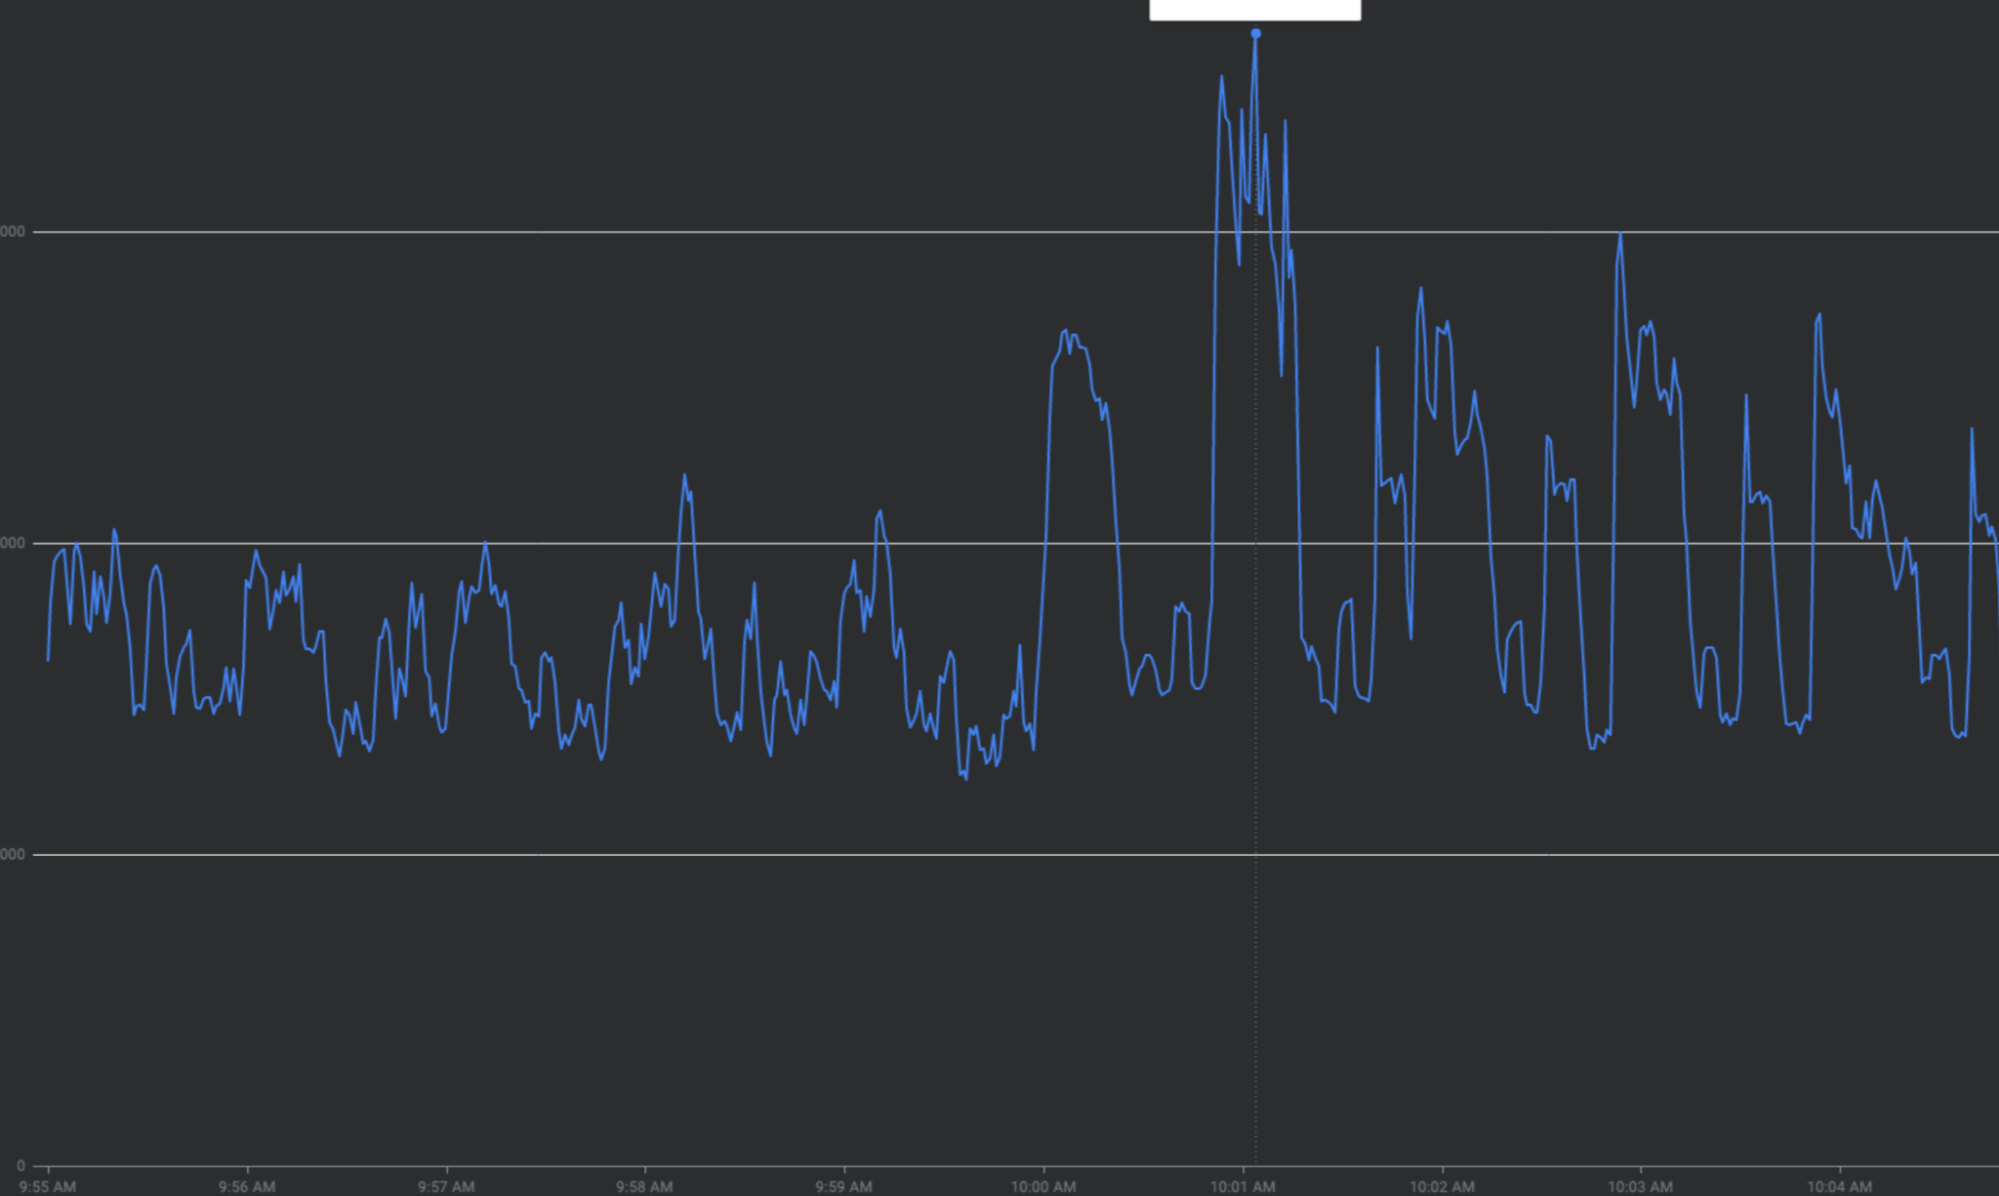
整點流量高峰:FCM 在每小時的前 30 秒到 2 分鐘內,收到的流量會增加一倍以上。在半小時和 15 分鐘的時間點 (例如 00:15、00:30、00:45),也會觀察到類似但較小的尖峰
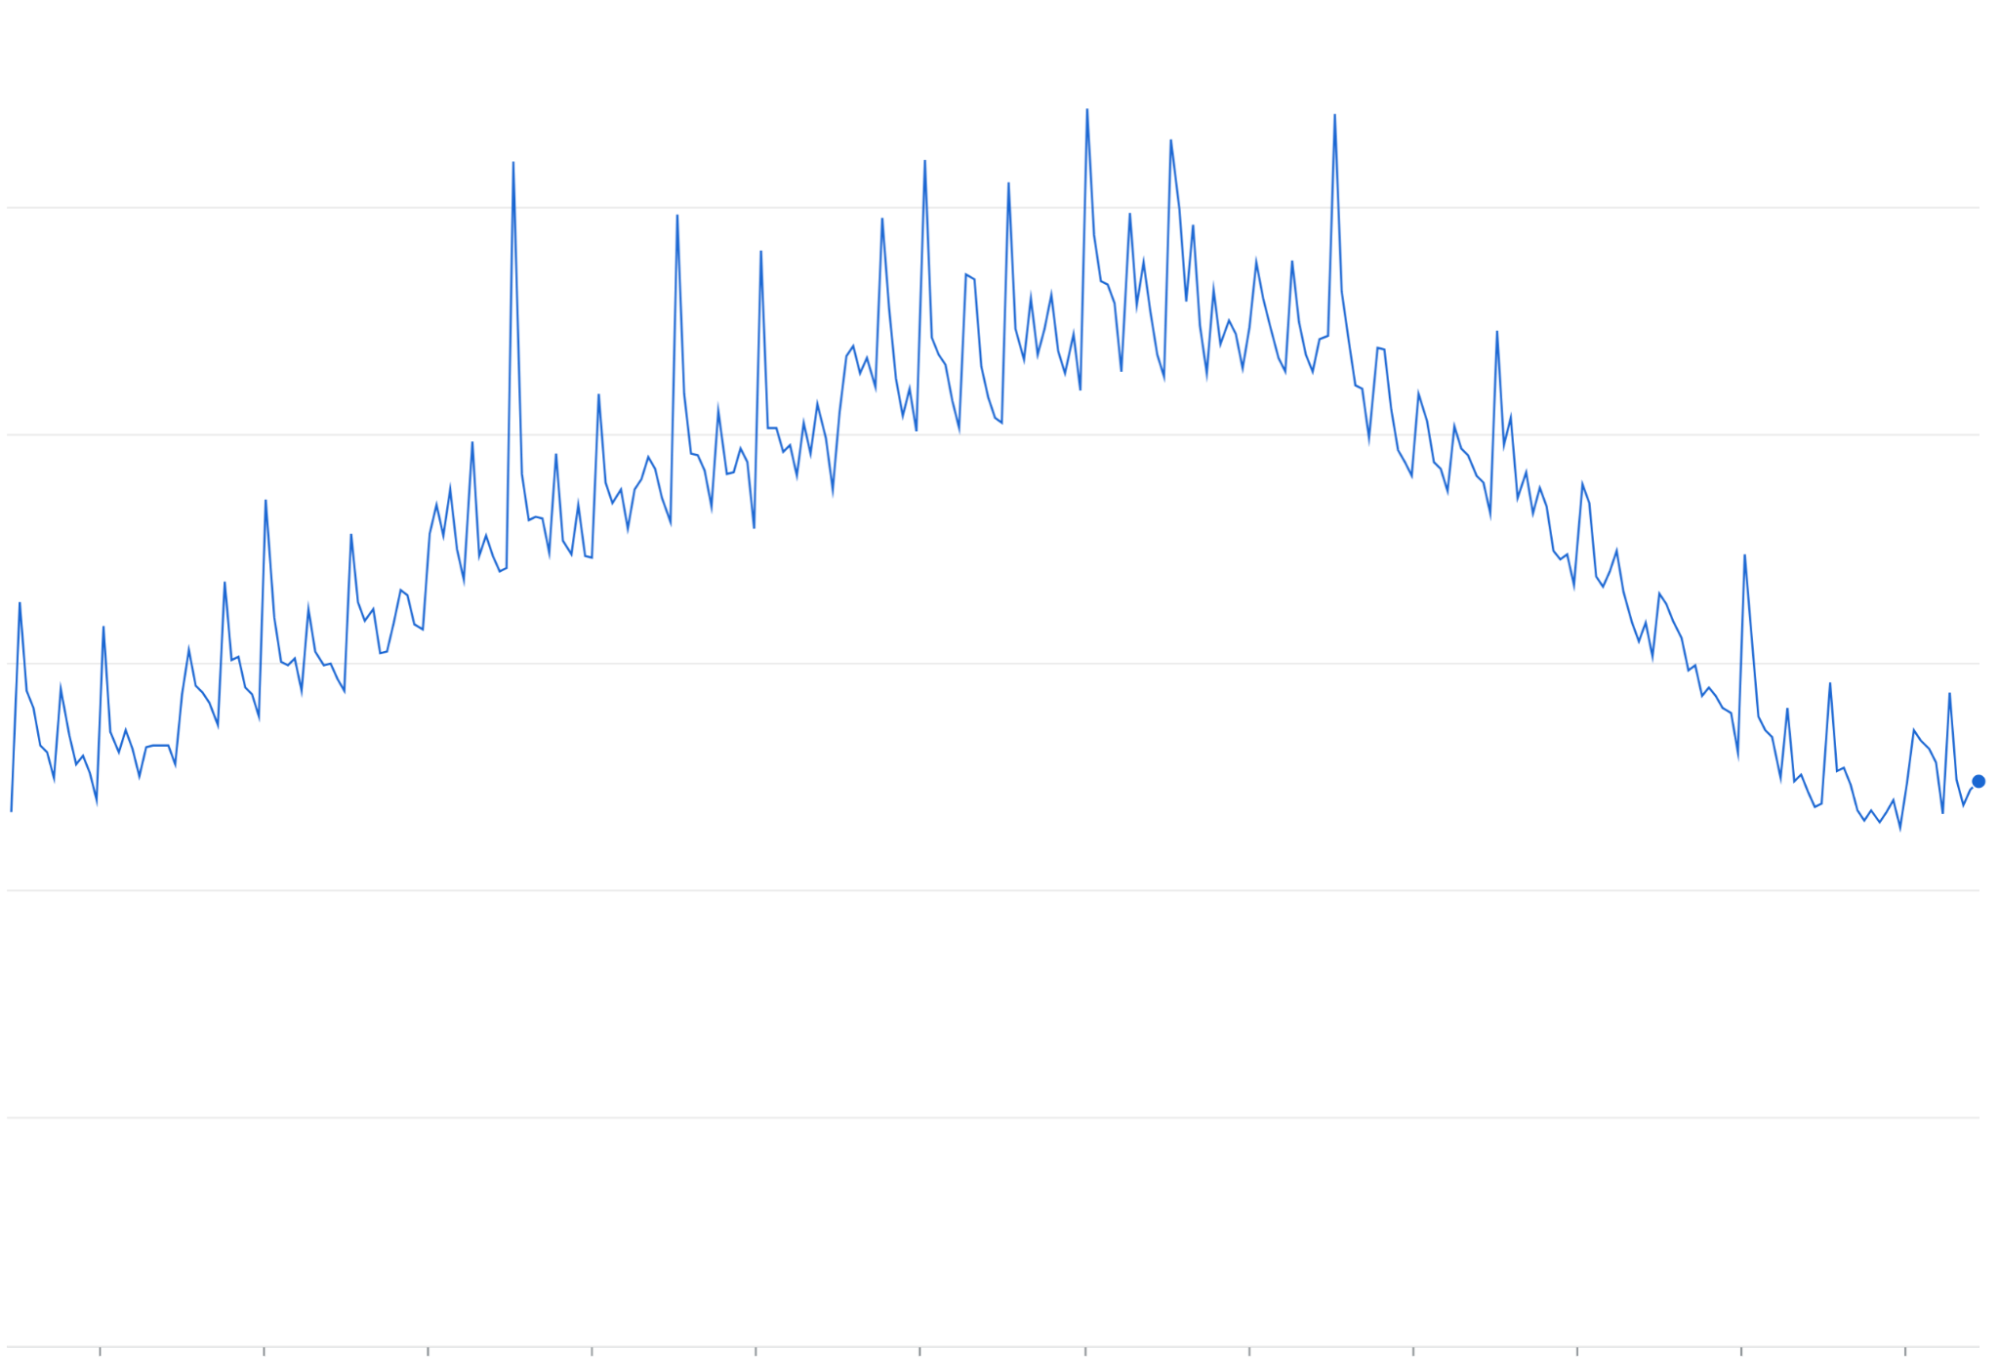
重試放大:重試失敗或逾時的要求時,如果沒有指數輪詢,可能會在現有流量高峰上累積重複的流量波。
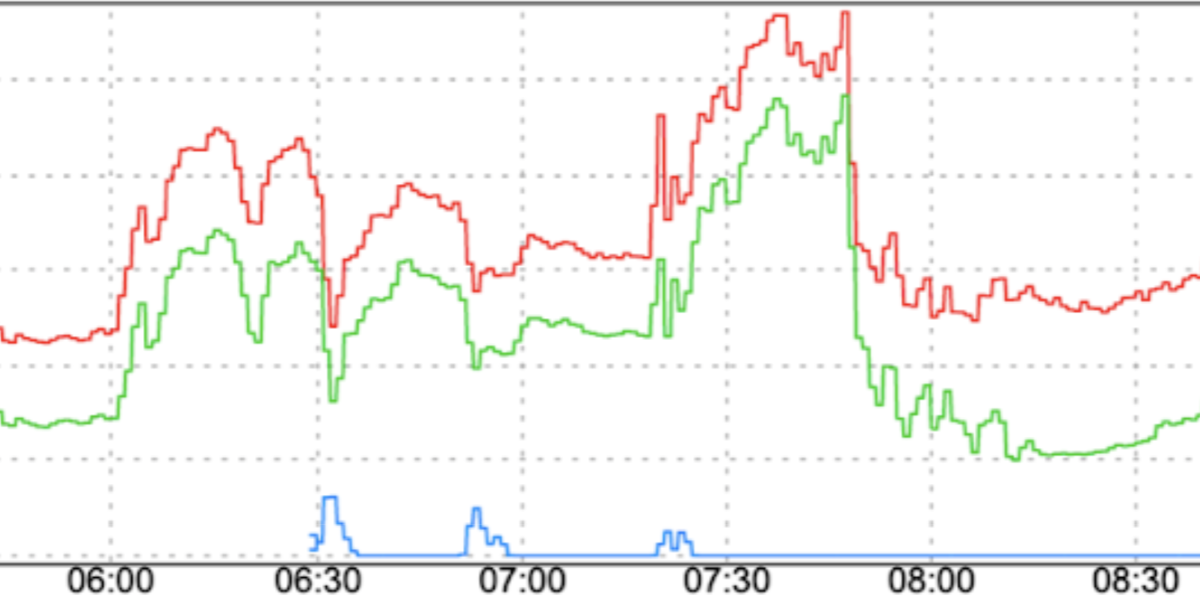
流量模式突然改變:將新流量導向 FCM,或跨區域將流量移至 FCM,但未採取漸進式增加等平滑因素,可能會導致流量激增。
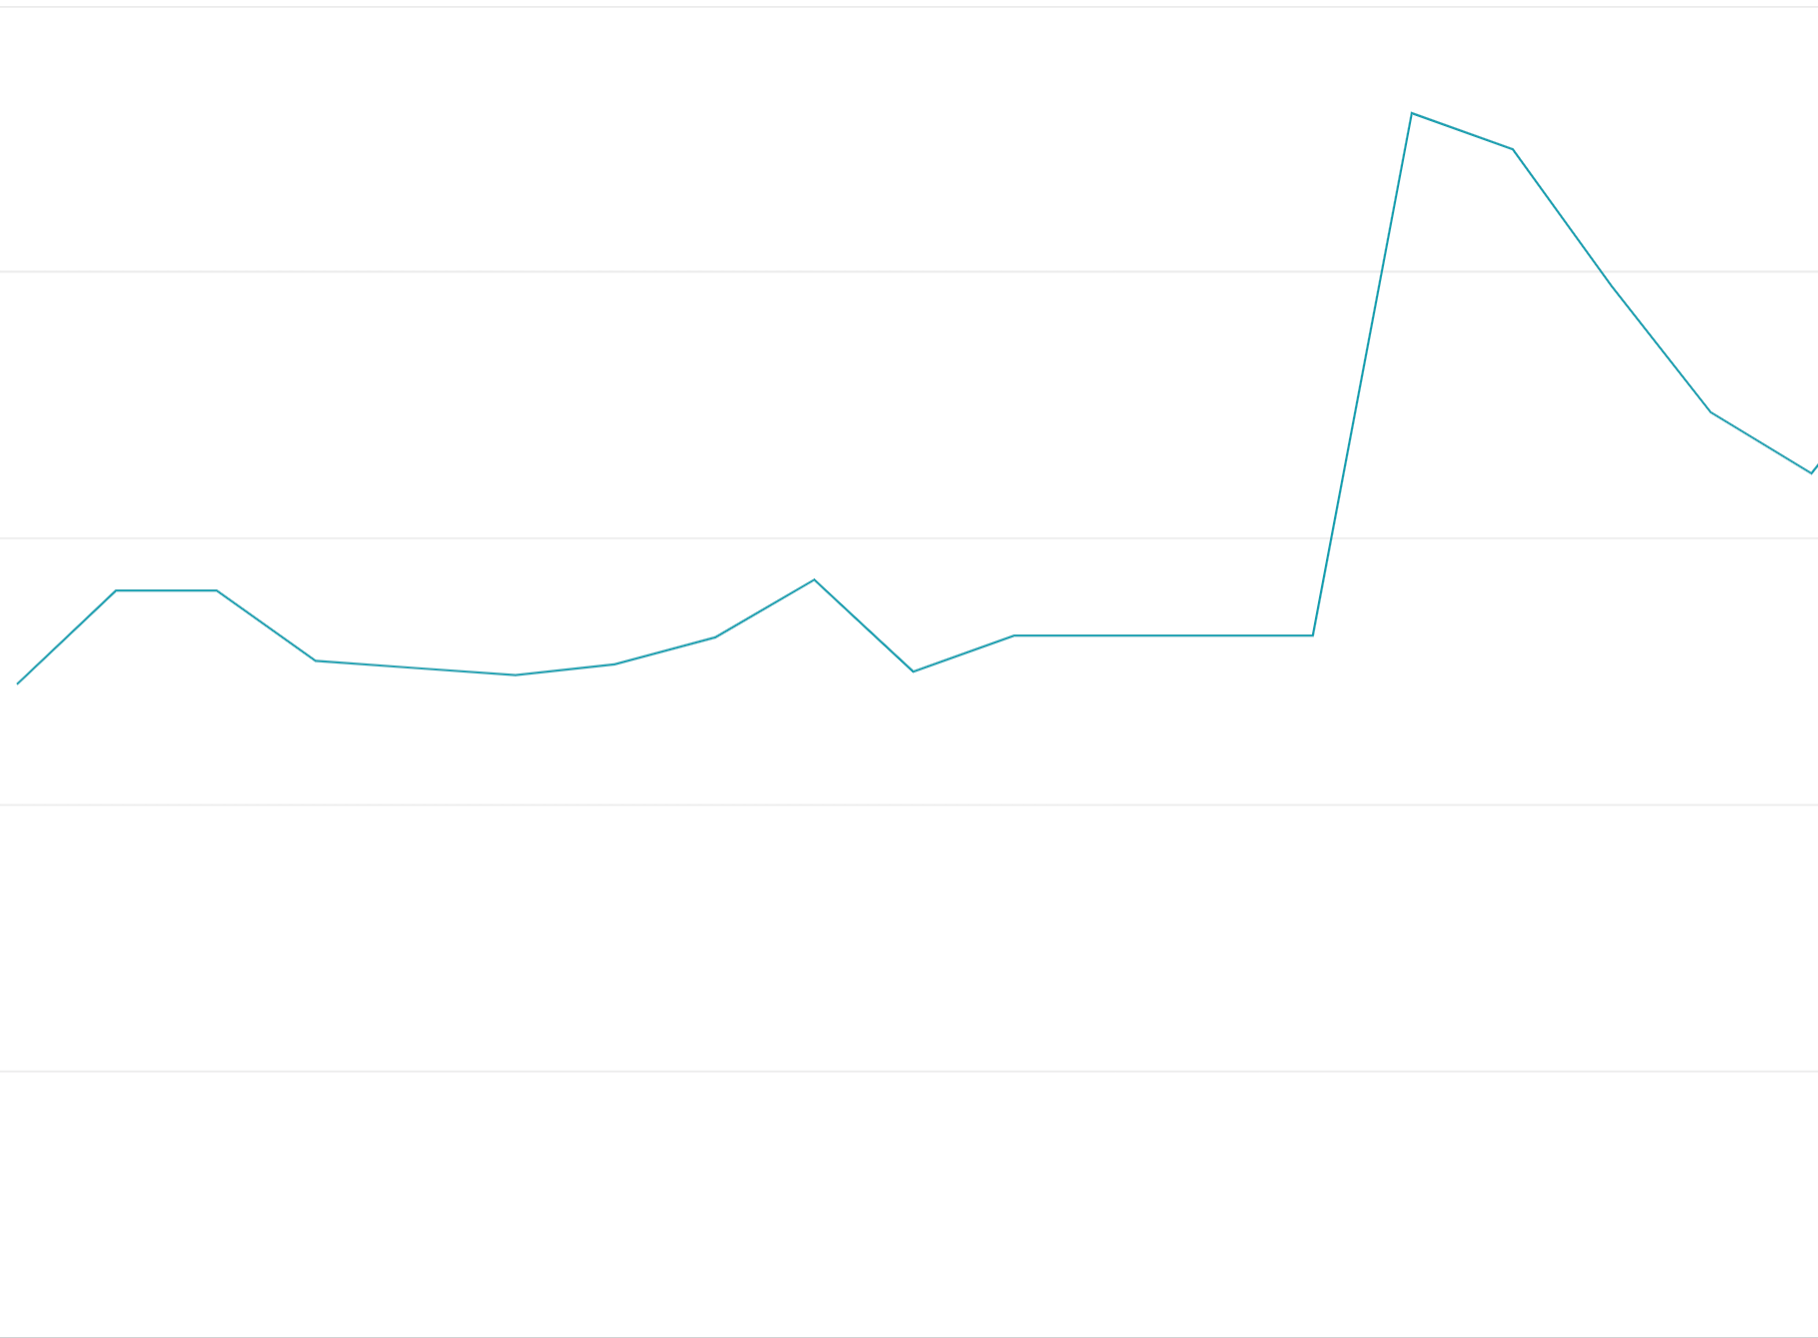
預先載入配額權杖用量:在配額時間範圍開始時用盡所有配額權杖,而不是在配額時間範圍內平均分配要求,會產生開關振盪,難以進行負載平衡,且成本高昂。
特殊活動:節慶 (跨年夜) 或體育賽事 (世界盃足球賽) 期間的流量高峰。
「拉平曲線」來因應流量高峰
本節說明盡可能平緩流量高峰的策略,也就是「拉平曲線」的策略。
僅在適當情況下使用 FCM
在某些情況下,不一定要使用 FCM 傳送通知,或是不適合使用。
舉例來說,如果是日曆活動通知,您可以在應用程式中排定本機工作,在適當時間顯示通知,而不是從應用程式伺服器傳送通知。限制 FCM 訊息,僅用於日曆同步。
避免尖峰
其中一個擴充反模式,是以系統允許的最快速度傳送 FCM 通知,而非套用伺服器端節流。請考量下列事項:
- 所有客戶是否都需要在 1 分鐘內收到相同通知?舉例來說,5 分鐘的傳送時間範圍是否仍符合您的業務需求?
- 是否可以根據優先順序區隔客戶,以因應尖峰時段?
- 可以預先排定通知時間嗎?
盡可能避免會立即耗盡 FCM 傳送配額的策略,以免在權杖 bucket 重新填滿後又重複同樣的模式。這種存取模式會造成 FCM 及其依附系統的負載平衡問題。盡可能逐步提高流量。至少在 60 秒的時間範圍內,將 RPS 從 0 提高至最大值。如要提高 RPS,建議延長時間範圍。
避開「整點」流量
盡可能避免在每小時的 :00、:15、:30 和 :45 分鐘標記前後 2 分鐘內傳送訊息。
實作伺服器端節流
實作伺服器端節流機制,監控及管理傳送至 FCM 的流量。
處理重試
雖然 FCM 致力於提供高可用性,但有時部分要求會逾時或失敗。雖然原因不盡相同,但下列最佳做法可最佳化重試行為,盡快傳送訊息,同時盡量減少對流量擁塞的影響。
逾時
請將傳送要求的逾時時間設為至少 10 秒,再重試。FCM 的內部遠端程序呼叫大多會在 10 秒後逾時。
錯誤
- 400、401、403、404 錯誤:中止,不要重試。
- 如果是 429 錯誤:請等待 retry-after 標頭中設定的時間長度,然後再重試。如未設定 retry-after 標頭,預設值為 60 秒。
- 500 錯誤:以指數輪詢方式重試。
指數輪詢
為避免重試放大,請實作指數輪詢和抖動,重試要求。舉例來說,Firebase Admin SDK 會實作指數輪詢。
以下是其他建議設定:
- 最短間隔:請勿立即使用 FCM 重試失敗的要求。請等待至少 10 秒,再重試失敗的要求。
- 間隔上限:設定間隔上限,捨棄不再及時的要求,而非無限期重試。
如果要求持續以指數輪詢方式重試,且在 60 分鐘後仍失敗,則可能是誤歸類為可重試錯誤,或 FCM 發生中斷,重試可能會不小心使情況惡化。
制定推出和復原計畫,並逐步進行變更
進行大規模流量變更時 (例如增加 FCM 流量,或跨區域/網路轉移流量),請設計推出/復原計畫,並逐步實施變更,保護使用者、服務和 FCM。
- 推出計畫可讓利害關係人達成共識。在某些情況下 (詳見下文),建議您事先與 FCM 團隊分享推出計畫,以免發生意外。
- 復原計畫可讓您考量應變措施,並準備相關機制,以便快速安全地從非預期故障中復原。
- 逐步調整有兩個層面:
- 「逐步」提高:提高比例應為 1% -> 5% -> 10% -> 25% -> 50% -> 75% -> 100% 或更精細。每個步驟「浸泡」(觀察系統在負載下的行為) 1 天到 1 週。這樣一來,您就能在下一次「升級」前
- 逐步提高流量:在每個「步驟」提高流量時,請在至少一小時內平穩地提高流量。這樣一來,FCM 的負載平衡基礎架構就能適當調度新流量,同時盡可能減少熱點和壅塞。
以下假設情境是將全球每秒 50 萬個要求,從 FCM 舊版 HTTP API 遷移至 FCM HTTP v1 API:
| 週 | 步驟 | 逐步增加曝光策略 |
|---|---|---|
| 0 | 1% 逐步推出 | 在一小時內,將 FCM HTTP v1 的 RPS 從 0 逐步提高至 5,000。 |
| 1 | 5% 增加曝光量 | 在 2 小時內,將 RPS 從 5,000 順暢提升至 25,000。 |
| 2 | 10% 逐步增加 | 在 2 小時內,將 RPS 從 25,000 順暢提升至 50,000 |
| 3 | 25% 逐步增加 | 在 3 小時內從 50,000 RPS 逐步增加至 125,000 RPS |
| 4 | 50% 增加曝光量 | 在 6 小時內將 RPS 從 125,000 提高至 250,000 |
| 5 | 75% 漸進式 | 在 6 小時內從 250,000 RPS 增加至 375,000 RPS |
| 6 | 100% 推出 | 在 6 小時內從 375,000 RPS 逐步增加至 500,000 RPS |
假設復原計畫:
- 如果在任何步驟中,95 百分位數延遲時間增加至超過 500 毫秒,或錯誤率超過 1% 的時間超過一小時,請使用動態設定立即復原至上一個步驟。
- 繼續復原至更早的步驟,直到延遲時間和錯誤率恢復正常。
何時該聯絡 FCM
如果符合下列任一情況,請透過 Firebase 支援聯絡 FCM:
- 預設配額不再符合您的用途
- 您在 3 個月內變更傳送模式,全球規模達 100,000 RPS,或洲際規模達 30,000 RPS。