

Niezależnie od tego, czy rozwijasz nową aplikację, czy już prowadzisz usługę o dużym natężeniu ruchu, możesz skorzystać ze wskazówek i rekomendacji zawartych w tym przewodniku, aby płynnie skalować aplikację za pomocą FCM. Te koncepcje i praktyki mogą pomóc Ci uniknąć negatywnych skutków, gdy musisz wysłać dużą liczbę wiadomości.
Kluczowe terminy i pojęcia
Prośba o wiadomość: prośba o wiadomość FCM; używana zamiennie z „prośbą”, „wiadomością” lub „zapytaniem”.
Żądania na sekundę (RPS): dane opisujące liczbę żądań przychodzących do FCM. Są używane zamiennie z zapytaniami na sekundę (QPS).
Tokeny limitu, zasobniki tokenów i uzupełnienia: podczas wysyłania wiadomości do interfejsu FCM HTTP v1 API każde żądanie wykorzystuje przydzielony token limitu w danym przedziale czasowym. To okno, nazywane „zasobnikiem tokena”, zapełnia się pod koniec okresu. Na przykład interfejs HTTP v1 API przydziela 600 tys. tokenów limitu na każdy 1-minutowy zasobnik tokena, który jest uzupełniany do pełna na koniec każdego 1-minutowego okna.
Ograniczanie przepustowości po stronie serwera: gdy natężenie ruchu przekracza możliwości usługi FCM, żądania przekraczające możliwości obsługi są odrzucane, aby ograniczyć przepływ danych przychodzących. Odpowiedzi z błędem 429 z nagłówkami retry-after mogą być zwracane, aby wskazać, że przed ponownym wysłaniem żądania należy odczekać określony czas.
Ograniczanie po stronie klienta: gdy klienci zauważą błędy żądań, wysokie opóźnienie lub błędy 429, powinni dobrowolnie ograniczyć przepływ danych wychodzących, aby uniknąć pogorszenia przeciążenia.
Wzrastający czas do ponowienia: podczas ponawiania prób po wystąpieniu błędów dodawaj wykładniczo rosnące opóźnienia. Na przykład: 1 s, 2 s, 4 s, 8 s, 16 s, 32 s itd.
Wahania: unikanie ponawiania żądań w dokładnych odstępach czasu. W przypadku jitteringu opóźnienia ponownych prób są zmieniane w procesie losowym, aby rozłożyć je równomiernie w czasie (np. 0,9 s, 2,3 s, 4,1 s, 8,5 s, 17,9 s, 34,7 s).
Wzmocnienie ponownych prób: gdy nieudane żądania są ponawiane bez wzrastającego czasu do ponowienia lub jittera, często się kumulują i zwiększają bieżące obciążenie ruchem, co może „wzmocnić” i pogorszyć problemy z przeciążeniem ruchu.
Problem: skoki ruchu
FCM przetwarza miliony żądań na sekundę (RPS). Największym czynnikiem powodującym przeciążenie systemu, problemy z opóźnieniami i przerwy w działaniu są skoki natężenia ruchu.
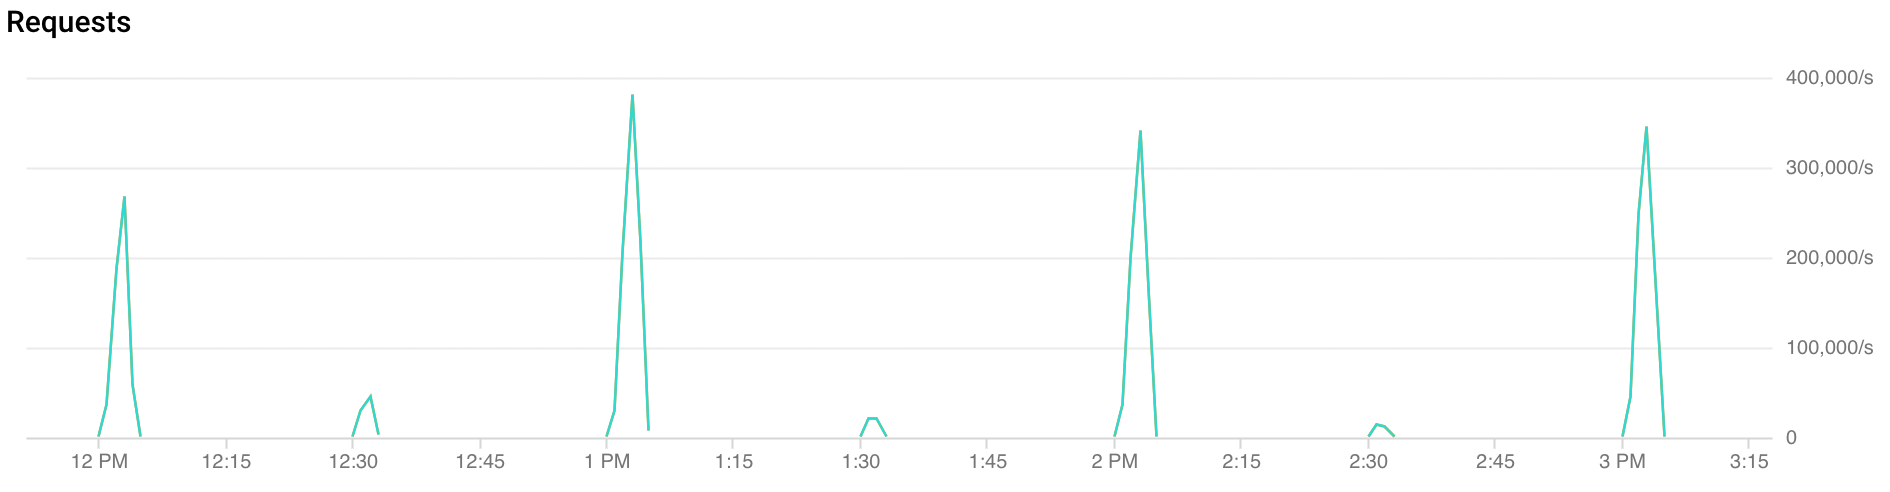
Czym jest ruch o charakterze skokowym?
Istnieje kilka różnych typów skoków ruchu.
Skoki na początku godziny: FCM otrzymuje ponad 2 razy większy ruch w ciągu pierwszych 30 sekund do 2 minut każdej godziny. Podobne, choć mniejsze skoki można zaobserwować również w połowie i w kwadransie godziny (np. 00:15, 00:30, 00:45).
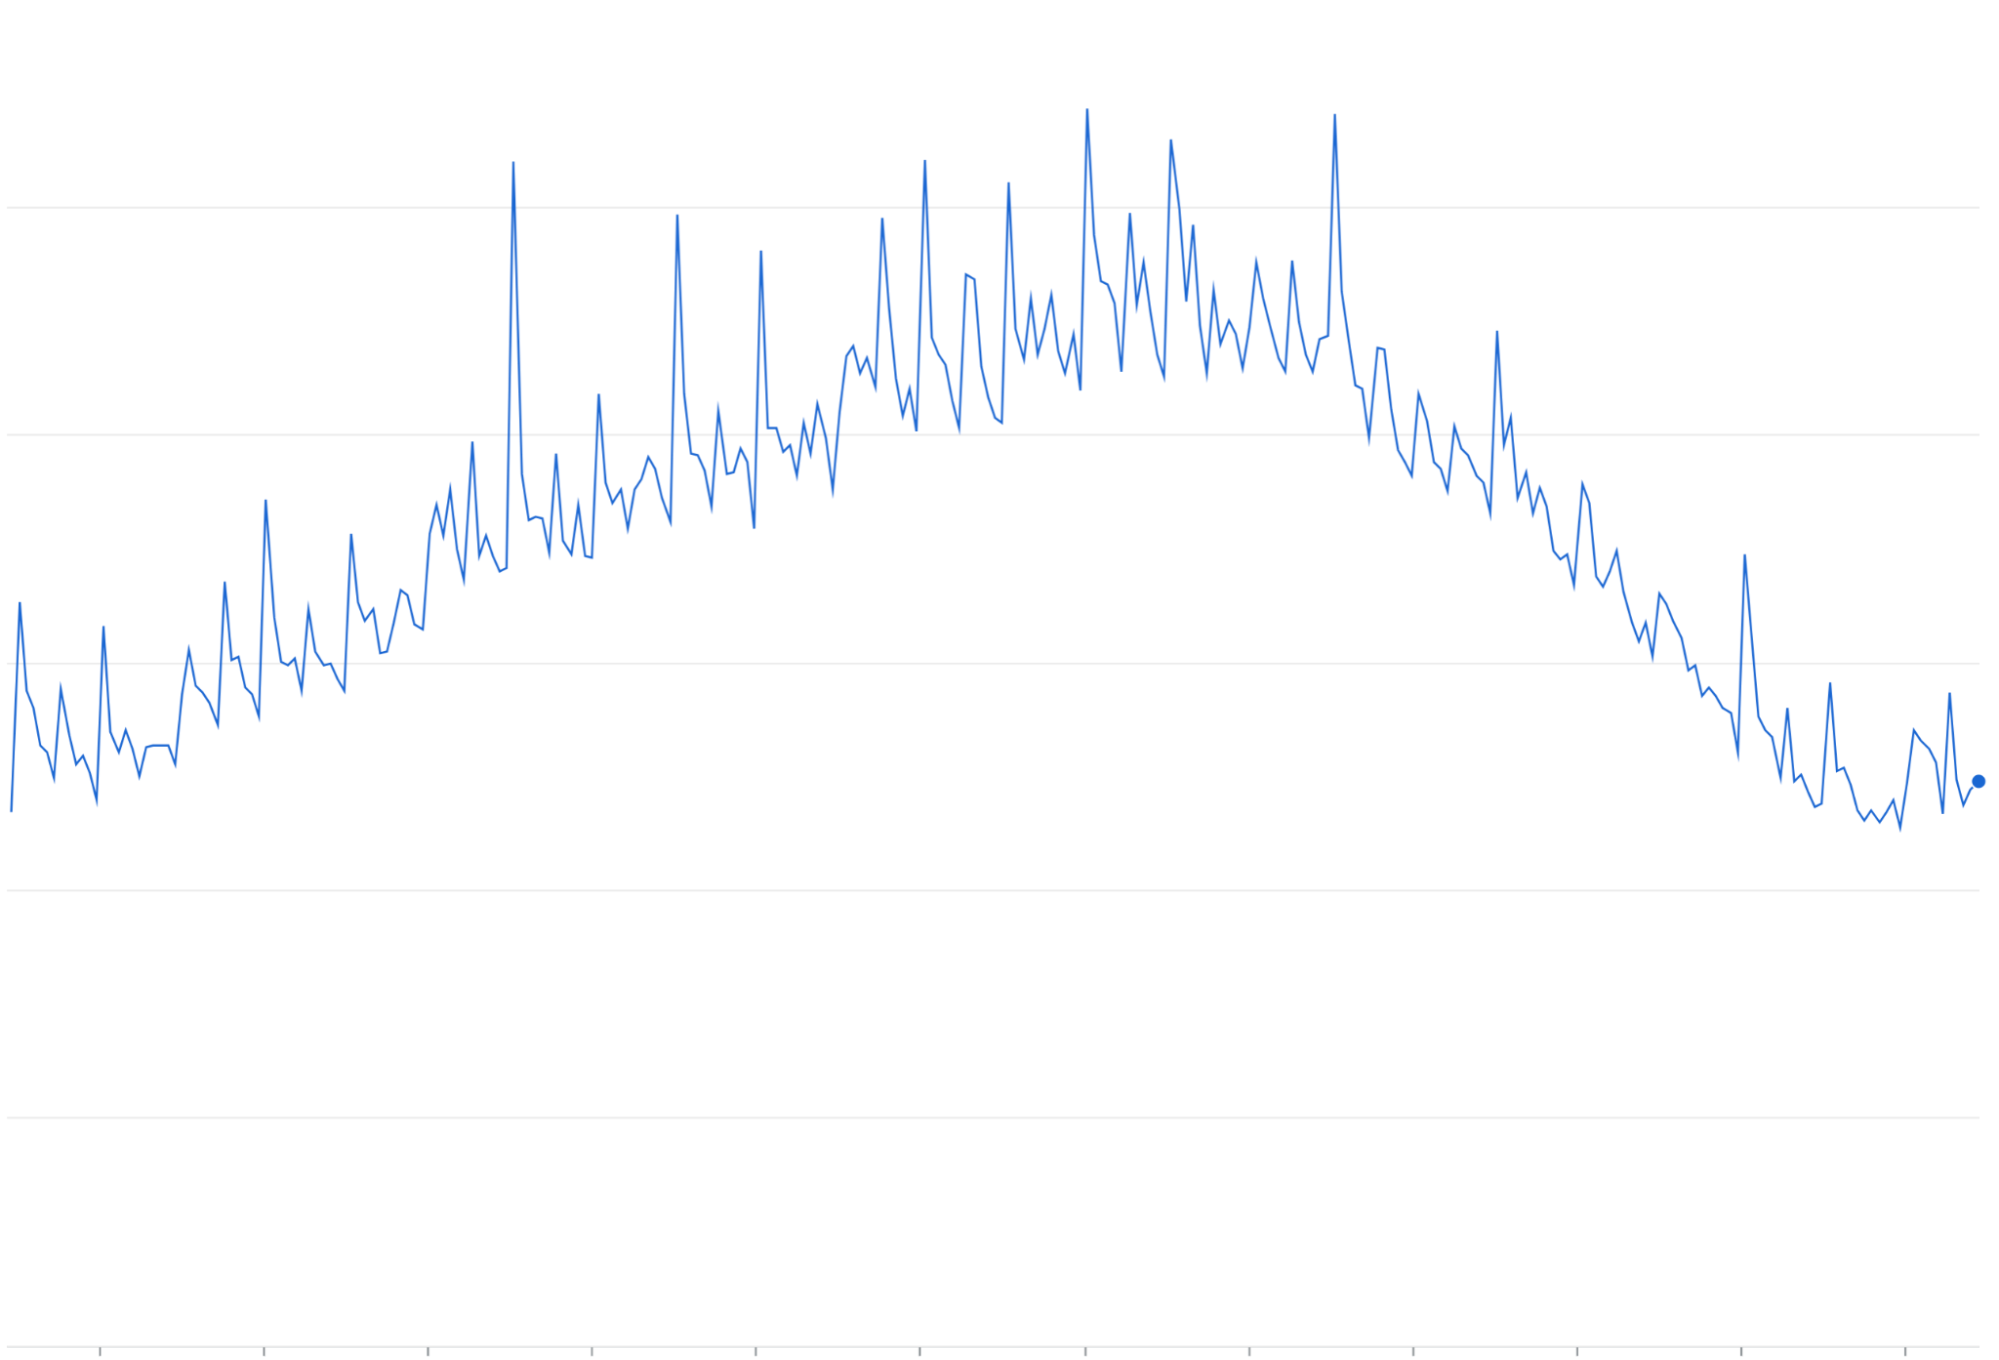
Wzrost liczby ponownych prób: ponawianie nieudanych żądań lub żądań, które przekroczyły limit czasu, bez wzrastającego czasu do ponowienia może powodować powtarzające się fale ruchu nakładające się na istniejące szczyty ruchu.
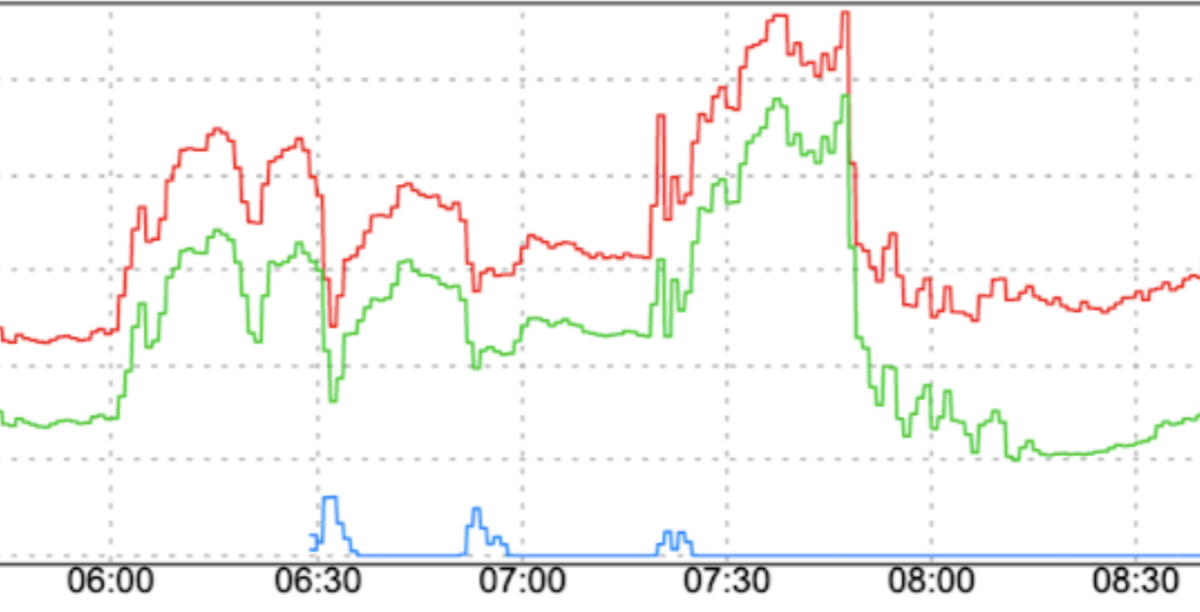
Nagłe zmiany wzorców ruchu: kierowanie nowego ruchu do FCM lub przenoszenie ruchu do FCM między regionami bez czynników wygładzających, takich jak stopniowe zwiększanie, może powodować skoki.
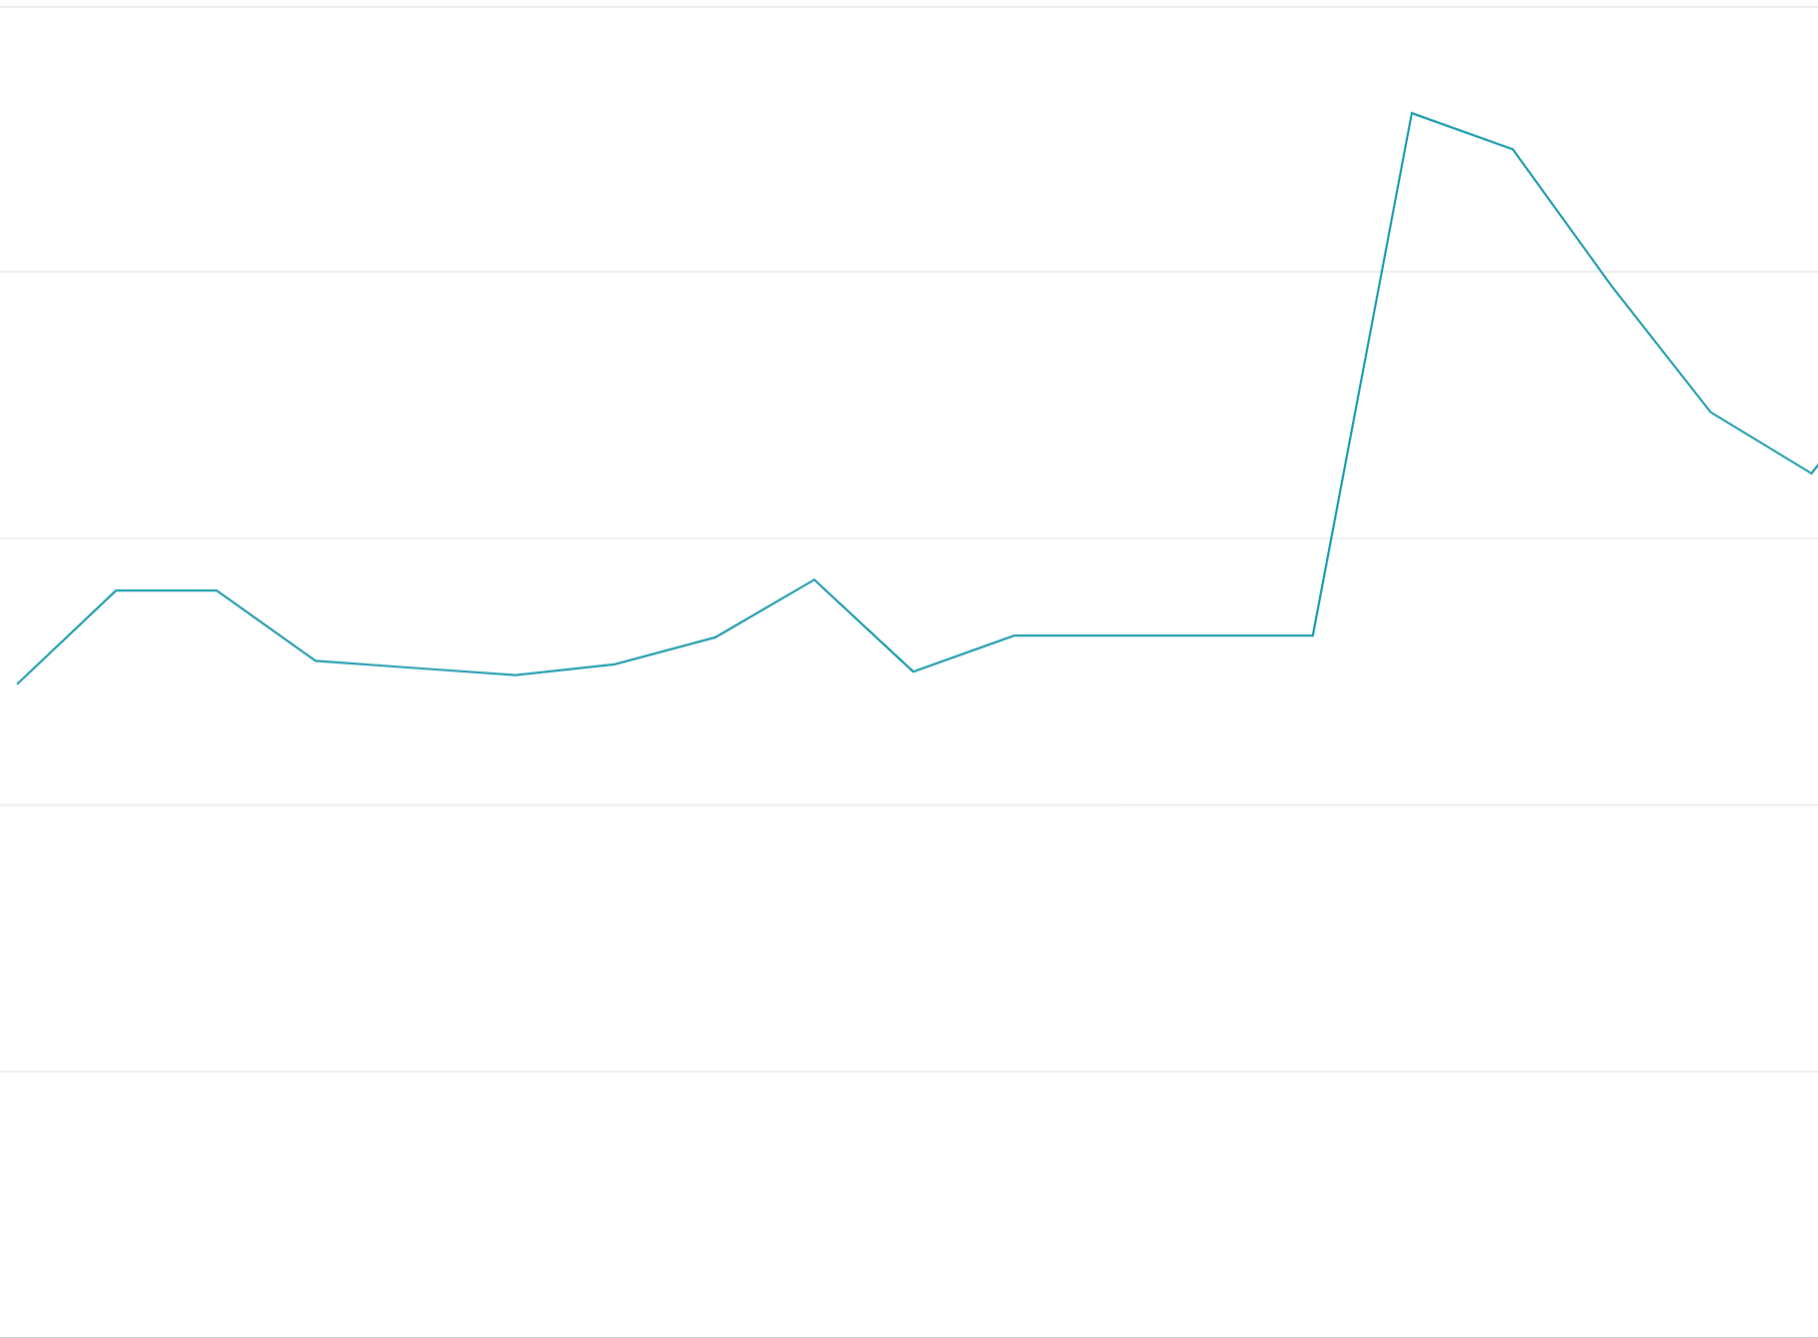
Wykorzystanie tokenów limitu na początku: wyczerpanie wszystkich tokenów limitu na początku okien limitu zamiast równomiernego rozłożenia żądań w oknach limitu spowoduje oscylacje, które są trudne i kosztowne do zrównoważenia.
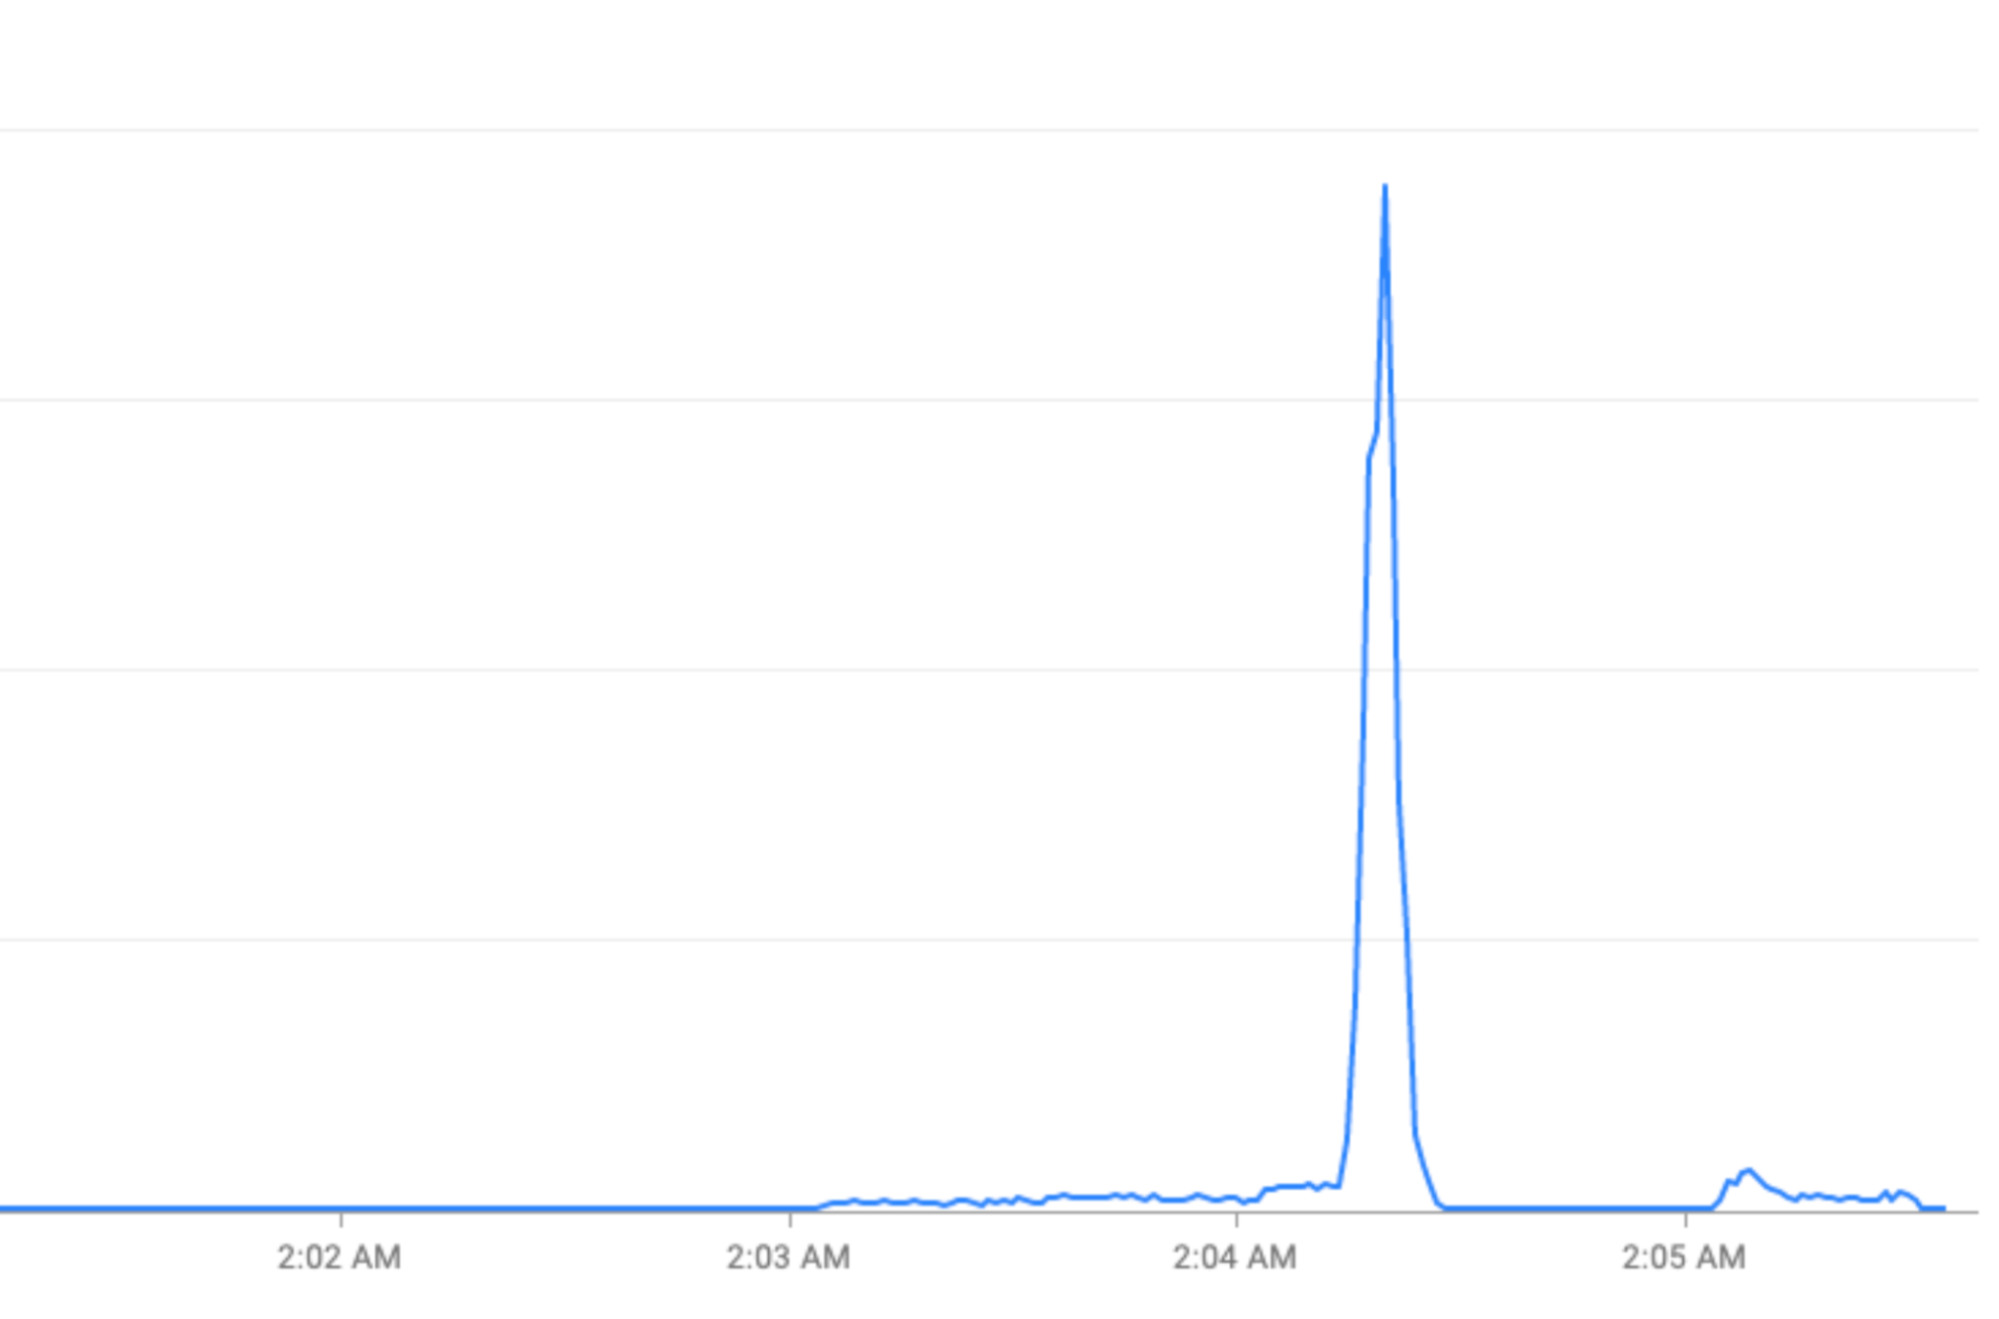
Wydarzenia specjalne: gwałtowne wzrosty natężenia ruchu podczas świąt (Sylwester) lub wydarzeń sportowych (Mistrzostwa Świata w Piłce Nożnej FIFA).
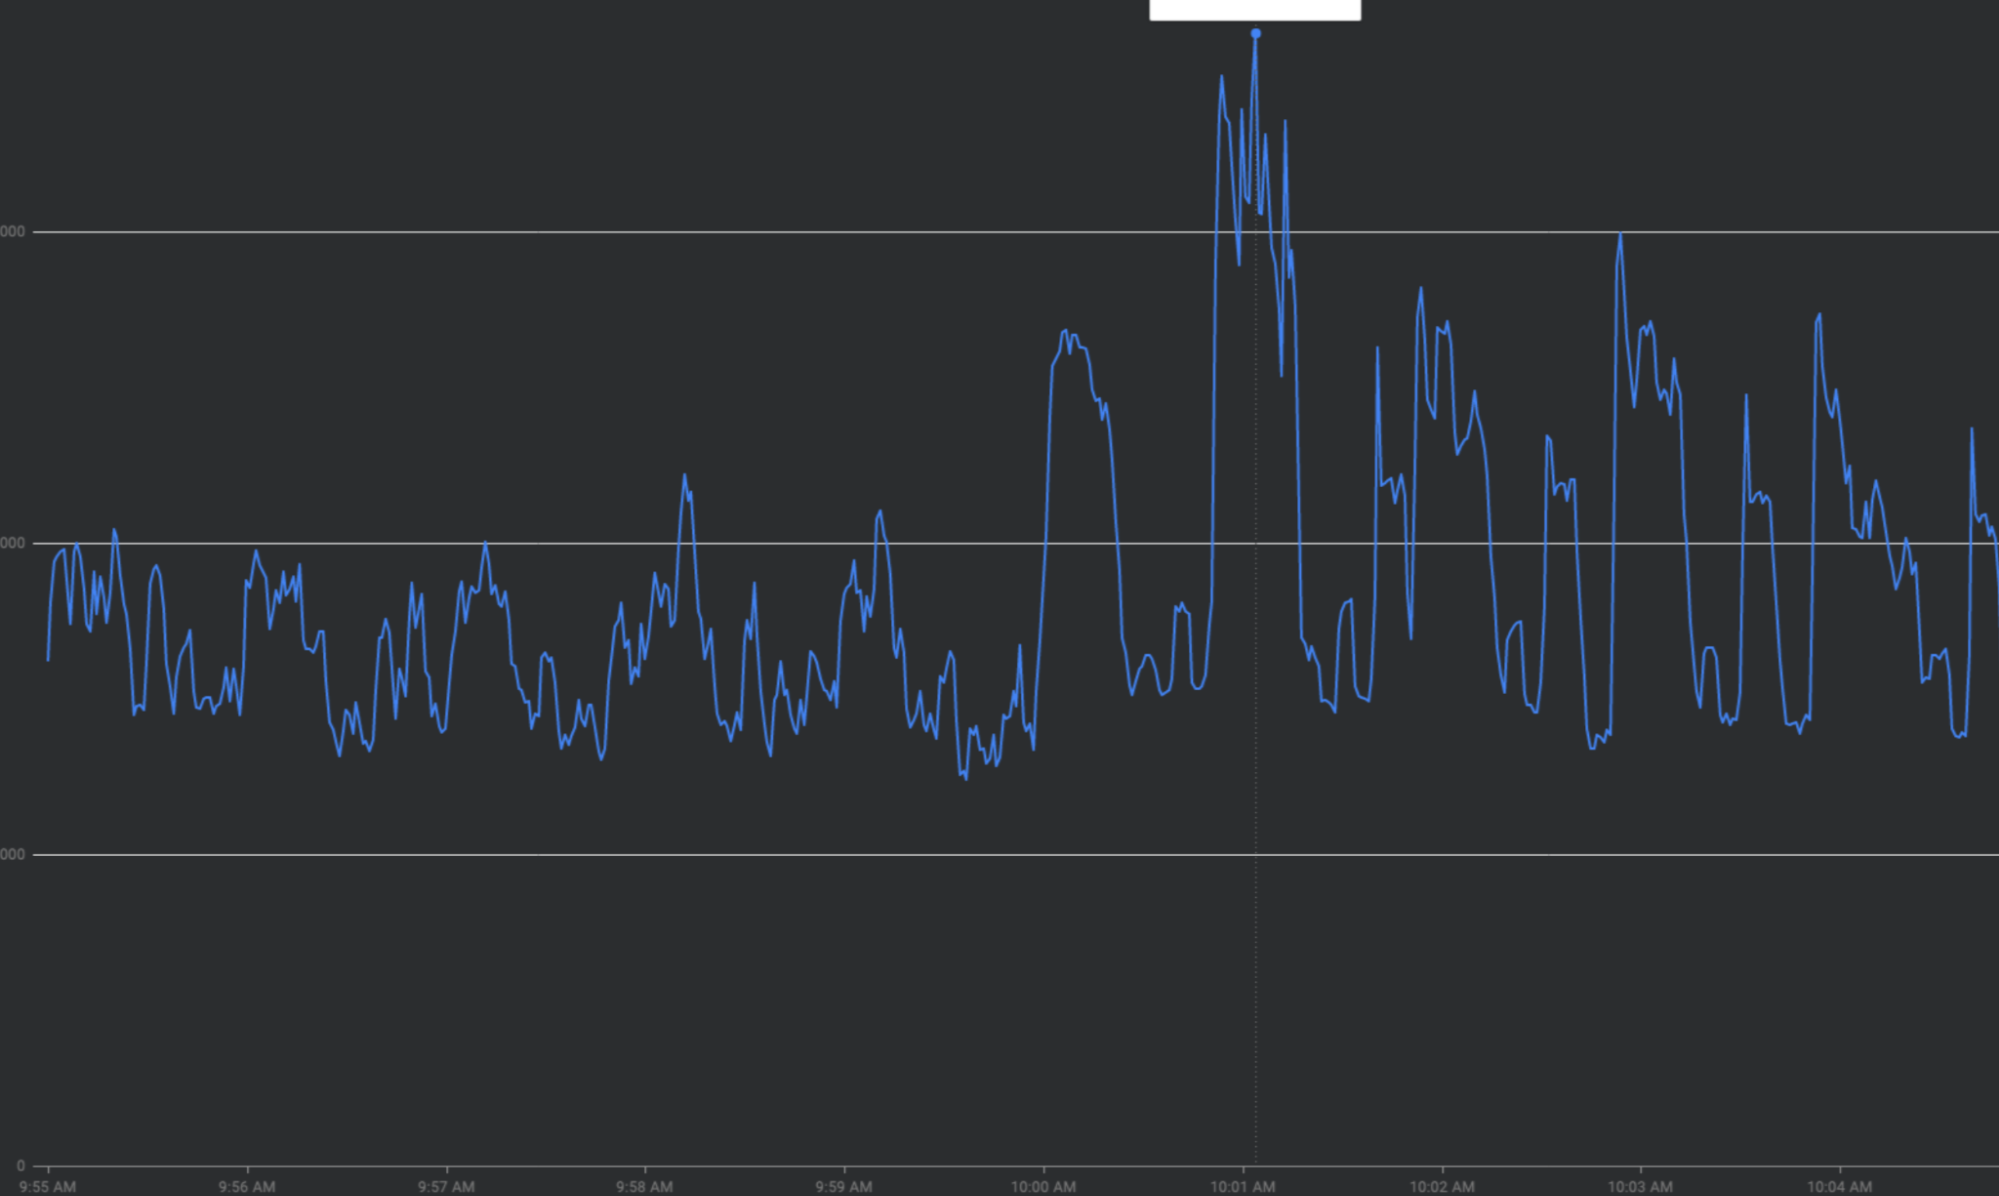
Zmniejszanie skoków ruchu przez „spłaszczanie krzywej”
W tej sekcji opisano strategie, które pozwalają w miarę możliwości wygładzić skoki ruchu, czyli „spłaszczyć krzywą”.
Używaj FCM tylko w odpowiednich przypadkach
W niektórych przypadkach użycie FCM do dostarczenia powiadomienia nie jest konieczne ani odpowiednie.
Na przykład w przypadku powiadomień o wydarzeniach w kalendarzu możesz zaplanować zadanie lokalne w aplikacji, aby wyświetlać powiadomienie w odpowiednim czasie, zamiast wysyłać je z serwera aplikacji. Ogranicz wiadomości FCM do synchronizacji kalendarza.
Unikaj skoków
Jednym z antywzorców skalowania jest wysyłanie powiadomień FCM tak szybko, jak pozwalają na to systemy, zamiast stosowania ograniczania przepustowości po stronie serwera. Weź pod uwagę te kwestie:
- Czy wszyscy klienci muszą otrzymać to samo powiadomienie w ciągu 1 minuty? Czy na przykład 5-minutowe okno dostawy nadal spełniałoby potrzeby Twojej firmy?
- Czy możesz podzielić klientów na segmenty według priorytetu, aby wygładzić skoki?
- Czy powiadomienia można zaplanować z wyprzedzeniem?
W miarę możliwości unikaj strategii, które powodują natychmiastowe wyczerpanie limitu wysyłania FCM, a następnie powtarzanie tego wzorca, gdy tylko zasobnik tokena zostanie ponownie zapełniony. Ten wzorzec dostępu powoduje problemy z równoważeniem obciążenia w FCM i systemach zależnych. Zwiększaj ruch jak najwolniej. Minimalny wzrost od 0 do maksymalnej liczby żądań na sekundę w ciągu 60 sekund. Aby uzyskać wyższą wartość RPS, preferuj dłuższe okna.
Unikanie ruchu „o pełnej godzinie”
Jeśli to możliwe: unikaj wysyłania wiadomości w ciągu 2 minut od każdej z tych minut: :00, :15, :30 i :45.
Wdrażanie ograniczania przepustowości po stronie serwera
Zaimplementuj ograniczanie przepustowości po stronie serwera, aby monitorować i zarządzać przepływem ruchu do FCM.
Obsługa ponownych prób
Chociaż FCM dąży do zapewnienia wysokiej dostępności, czasami niektóre żądania mogą przekroczyć limit czasu lub zakończyć się niepowodzeniem. Przyczyny mogą być różne, ale poniższe sprawdzone metody optymalizują ponowne próby, aby dostarczać wiadomości jak najszybciej, jednocześnie minimalizując wpływ na przeciążenie ruchu.
Czasy oczekiwania
Przed ponowną próbą ustaw limit czasu na żądania wysyłania na co najmniej 10 sekund. Większość wewnętrznych zdalnych wywołań procedur FCM używa 10-sekundowego limitu czasu.
Błędy
- W przypadku błędów 400, 401, 403 i 404: przerwij i nie próbuj ponownie.
- W przypadku błędów 429: ponów próbę po upływie czasu określonego w nagłówku retry-after. Jeśli nie ustawiono nagłówka retry-after, domyślnie ustawiane jest 60 sekund.
- W przypadku błędów 500: ponów próbę ze wzrastającym czasem do ponowienia.
Wzrastający czas do ponowienia
Aby uniknąć wzmocnienia ponownych prób, zaimplementuj wykładnicze opóźnienie z jitterem w przypadku ponownych prób wysłania żądań. Na przykład pakiet Firebase Admin SDK implementuje wzrastający czas do ponowienia.
Oto kilka dodatkowych zalecanych ustawień:
- Minimalny odstęp: nie ponawiaj od razu nieudanej prośby za pomocą FCM. Zanim spróbujesz ponownie wysłać nieudane żądanie, odczekaj co najmniej 10 sekund.
- Maksymalny interwał: ustaw maksymalny interwał, po którym żądania, które nie są już aktualne, będą odrzucane, zamiast ponawiać próby w nieskończoność.
Jeśli żądanie jest stale ponawiane ze wzrastającym czasem do ponowienia i po 60 minutach nadal kończy się niepowodzeniem, oznacza to, że zostało błędnie sklasyfikowane jako błąd, który można naprawić, lub że w FCM wystąpiła przerwa w działaniu, podczas której ponowne próby mogą nieumyślnie pogorszyć sytuację.
tworzyć plany wdrażania i przywracania oraz wprowadzać zmiany stopniowo;
Podczas wprowadzania zmian w ruchu na dużą skalę, takich jak zwiększanie ruchu do FCM lub przenoszenie ruchu między regionami lub sieciami, opracowanie planu wdrażania i wycofywania oraz wprowadzanie stopniowych zmian pomoże chronić użytkowników, Twoją usługę i FCM.
- Plan wdrażania pozwala ujednolicić oczekiwania interesariuszy. W niektórych sytuacjach (omówionych poniżej) warto wcześniej udostępnić plan wdrażania zespołowi FCM, aby uniknąć niespodzianek.
- Plan przywracania pozwala uwzględnić nieprzewidziane okoliczności i przygotować mechanizmy szybkiego i bezpiecznego przywracania po nieoczekiwanych awariach.
- Wprowadzanie stopniowych zmian ma 2 aspekty:
- Stopniowe zwiększanie: kroki powinny wynosić 1% -> 5% -> 10% -> 25% -> 50% -> 75% -> 100% lub mniej. „Obserwuj” (zachowanie systemu pod obciążeniem) każdy krok przez okres od 1 dnia do 1 tygodnia. Dzięki temu możesz wykryć potencjalne problemy przed kolejnym „krokiem”.
- Stopniowe zwiększanie ruchu: podczas każdego „kroku” zwiększania ruchu należy rozłożyć ruch na co najmniej godzinę. Dzięki temu infrastruktura równoważenia obciążenia FCM może odpowiednio skalować nowy ruch, minimalizując jednocześnie ryzyko wystąpienia hotspotów i przeciążeń.
Oto hipotetyczny scenariusz migracji 500 000 żądań na sekundę na całym świecie ze starszego interfejsu FCM HTTP API do interfejsu FCM HTTP v1 API:
| Tydzień | Step | Strategia stopniowego zwiększania liczby wysyłanych e-maili |
|---|---|---|
| 0 | 1% – zwiększanie wyświetlania | W ciągu godziny płynnie zwiększaj liczbę żądań na sekundę do FCM HTTP v1 od 0 do 5000. |
| 1 | 5% wzrostu | Płynnie zwiększaj liczbę żądań na sekundę z 5000 do 25 000 w ciągu 2 godzin. |
| 2 | 10% – zwiększanie wyświetlania | Płynne zwiększanie liczby żądań na sekundę z 25 000 do 50 000 w ciągu 2 godzin |
| 3 | 25% – zwiększanie wyświetlania | Zwiększenie liczby żądań na sekundę z 50 000 do 125 000 w ciągu 3 godzin |
| 4 | 50% zwiększania wyświetlania | Zwiększenie liczby żądań na sekundę ze 125 000 do 250 000 w ciągu 6 godzin |
| 5 | 75% – zwiększanie wyświetlania | Zwiększenie liczby żądań na sekundę z 250 000 do 375 000 w ciągu 6 godzin |
| 6 | 100% – zwiększanie wyświetlania | Zwiększanie liczby żądań na sekundę z 375 000 do 500 000 w ciągu 6 godzin |
Przykładowy plan przywrócenia:
- Jeśli na dowolnym etapie opóźnienie na poziomie 95 percentyla wzrośnie do ponad 500 ms lub współczynnik błędów przekroczy 1% przez ponad godzinę, użyj konfiguracji dynamicznej, aby natychmiast wrócić do poprzedniego etapu.
- Kontynuuj wycofywanie zmian do wcześniejszych kroków, aż czas oczekiwania i odsetek błędów powrócą do wartości nominalnych.
Kiedy skontaktować się z FCM
Skontaktuj się z FCM przez zespół pomocy Firebase, jeśli:
- Domyślne limity nie odpowiadają już Twojemu przypadkowi użycia.
- Zmieniasz wzorce wysyłania w ciągu 3 miesięcy w skali 100 tys. RPS globalnie lub 30 tys. RPS na kontynencie.