

Cho dù bạn đang phát triển một ứng dụng mới hay đang vận hành một dịch vụ có lưu lượng truy cập cao, bạn đều có thể hưởng lợi từ thông tin chi tiết và đề xuất trong hướng dẫn này về cách mở rộng quy mô một cách suôn sẻ bằng FCM. Những khái niệm và phương pháp này có thể giúp bạn tránh tác động tiêu cực khi cần gửi số lượng lớn thư.
Các thuật ngữ và khái niệm chính
Yêu cầu thông báo: Yêu cầu thông báo FCM; được dùng thay thế cho "yêu cầu", "thông báo" hoặc "truy vấn".
Số yêu cầu mỗi giây (RPS): Chỉ số mô tả tỷ lệ yêu cầu đến FCM; được dùng thay thế cho Số truy vấn mỗi giây (QPS).
Mã thông báo hạn mức, thùng đựng mã thông báo và nạp lại: Khi gửi thông báo đến API HTTP v1 của FCM, mỗi yêu cầu sẽ sử dụng một Mã thông báo hạn mức được phân bổ trong một khoảng thời gian nhất định. Cửa sổ này, được gọi là "Token Bucket" (Thùng mã thông báo), sẽ được nạp đầy vào cuối khung thời gian. Ví dụ: API HTTP phiên bản 1 phân bổ 600.000 mã thông báo hạn mức cho mỗi Thùng đựng mã thông báo 1 phút, thùng này sẽ được nạp đầy vào cuối mỗi khoảng thời gian 1 phút.
Điều tiết phía máy chủ: Khi lưu lượng truy cập vượt quá dung lượng của dịch vụ FCM, các yêu cầu vượt quá dung lượng phân phát sẽ bị từ chối để giới hạn tốc độ luồng dữ liệu vào. Phản hồi lỗi 429 có tiêu đề retry-after có thể được trả về để cho biết rằng bạn nên đợi một khoảng thời gian nhất định trước khi thử lại yêu cầu.
Điều tiết phía máy khách: Khi máy khách nhận thấy lỗi yêu cầu, độ trễ cao hoặc lỗi 429, họ nên tự nguyện giới hạn tốc độ luồng dữ liệu ra để tránh làm trầm trọng thêm tình trạng tắc nghẽn.
Thuật toán thời gian đợi luỹ thừa: Khi thử lại các lỗi, hãy thêm độ trễ thời gian tăng theo cấp số nhân. Ví dụ: 1 giây, 2 giây, 4 giây, 8 giây, 16 giây, 32 giây, v.v.
Biến động: Tránh gửi lại yêu cầu theo khoảng thời gian chính xác. Với độ giật, bạn thay đổi độ trễ thử lại thông qua một quy trình ngẫu nhiên để phân phối đồng đều theo thời gian (ví dụ: 0,9 giây, 2,3 giây, 4,1 giây, 8,5 giây, 17,9 giây, 34,7 giây).
Khuếch đại số lần thử lại: Khi các yêu cầu không thành công được thử lại mà không có độ trễ tăng theo cấp luỹ thừa/dao động, chúng thường tích luỹ và làm tăng tải lưu lượng truy cập đang diễn ra, có khả năng "khuếch đại" và làm trầm trọng thêm các vấn đề về tắc nghẽn lưu lượng truy cập.
Vấn đề: lưu lượng truy cập tăng đột biến
FCM xử lý hàng triệu yêu cầu mỗi giây (RPS). Nguyên nhân lớn nhất gây ra tình trạng tắc nghẽn hệ thống, vấn đề về độ trễ và sự cố ngừng hoạt động là do lưu lượng truy cập tăng đột biến.
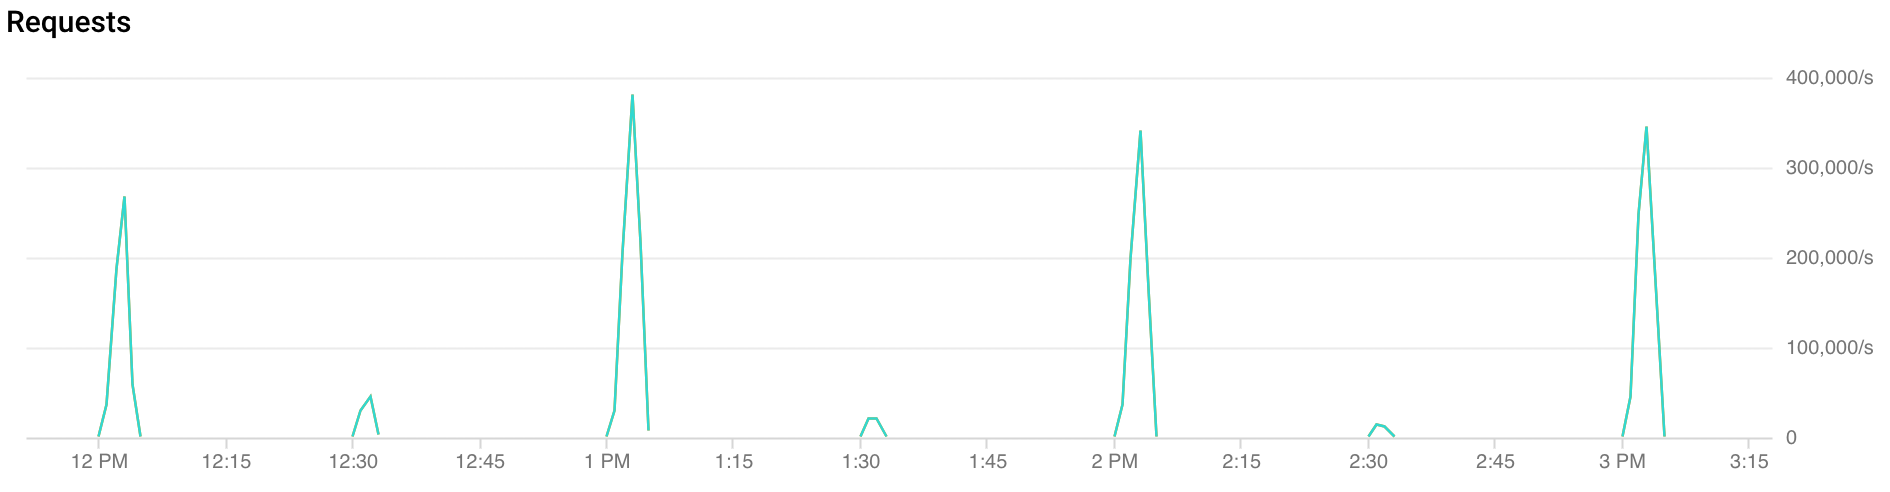
Lưu lượng truy cập tăng đột biến là gì?
Có một số loại biến động lưu lượng truy cập.
Lưu lượng truy cập tăng đột biến theo giờ: FCM nhận được lưu lượng truy cập cao hơn gấp đôi trong 30 giây đến 2 phút đầu tiên của mỗi giờ. Các mức tăng đột biến tương tự, mặc dù ít hơn, cũng được quan sát thấy ở các mốc nửa giờ và một phần tư giờ (ví dụ: 00:15, 00:30, 00:45)
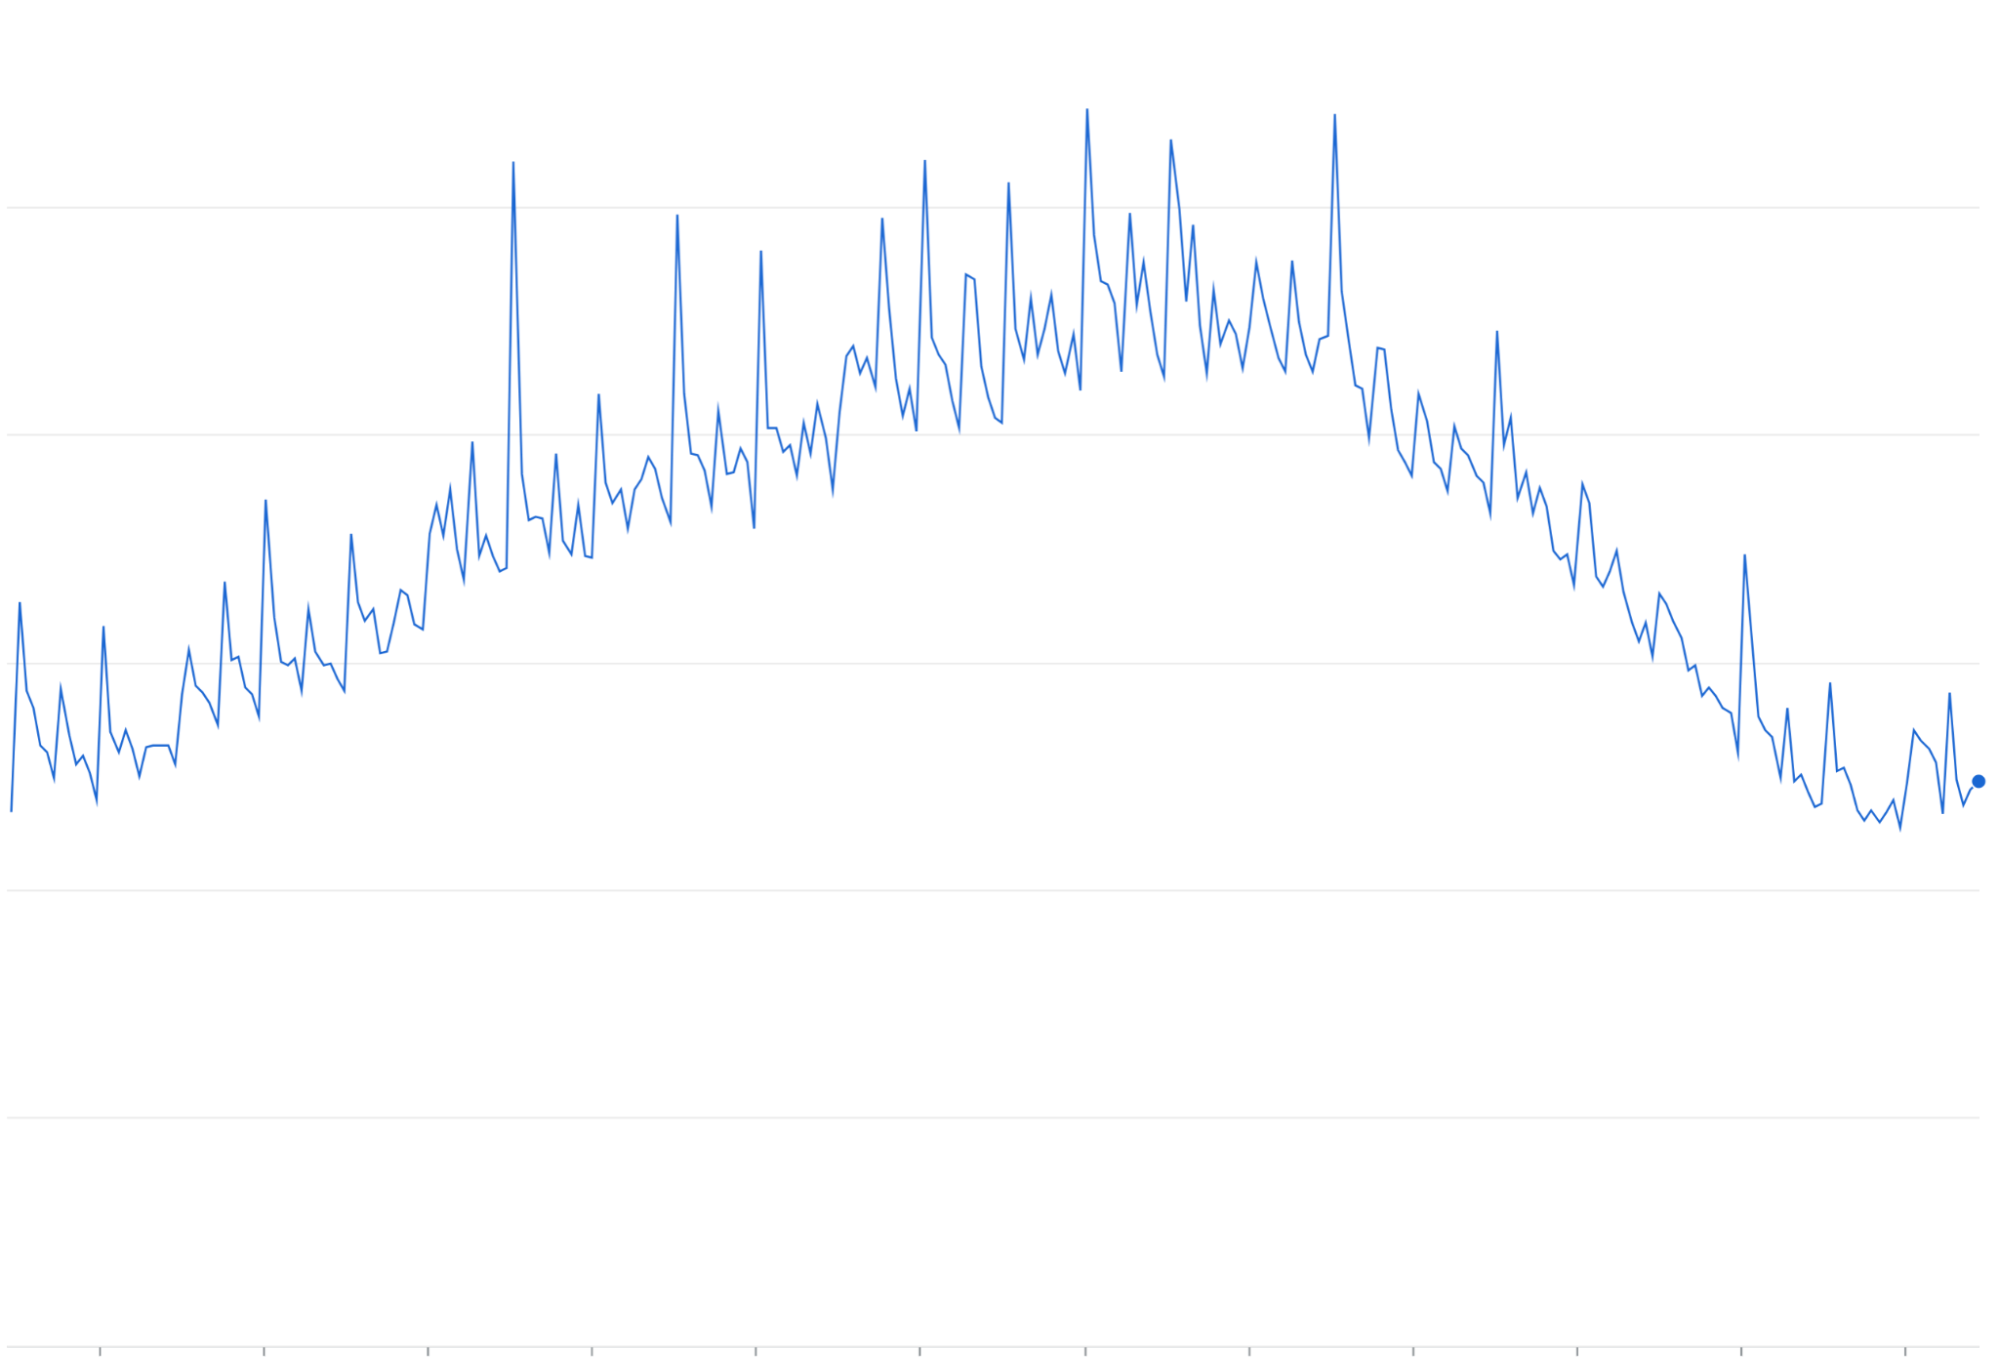
Khuếch đại thử lại: Thử lại các yêu cầu không thành công hoặc hết thời gian chờ mà không có Thuật toán thời gian đợi tăng dần có thể tích luỹ thành các làn sóng lưu lượng truy cập lặp lại trên các đỉnh lưu lượng truy cập hiện có.
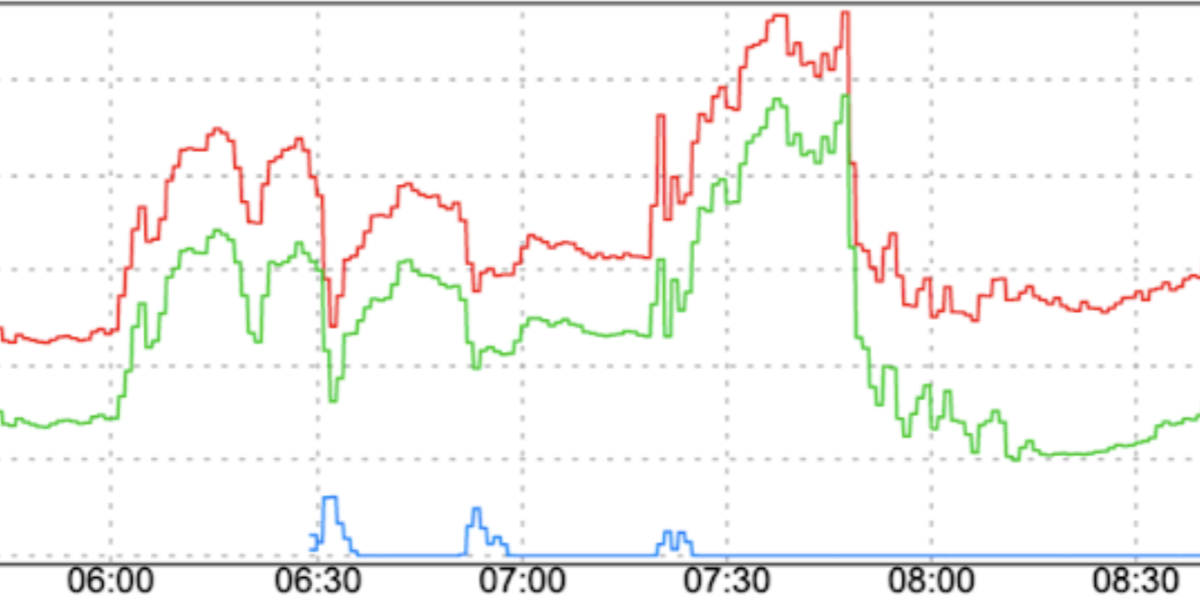
Thay đổi đột ngột về mẫu lưu lượng truy cập: Việc chuyển lưu lượng truy cập mới đến FCM hoặc di chuyển lưu lượng truy cập đến FCM trên các khu vực mà không có các yếu tố làm mượt như tăng dần có thể gây ra đột biến.
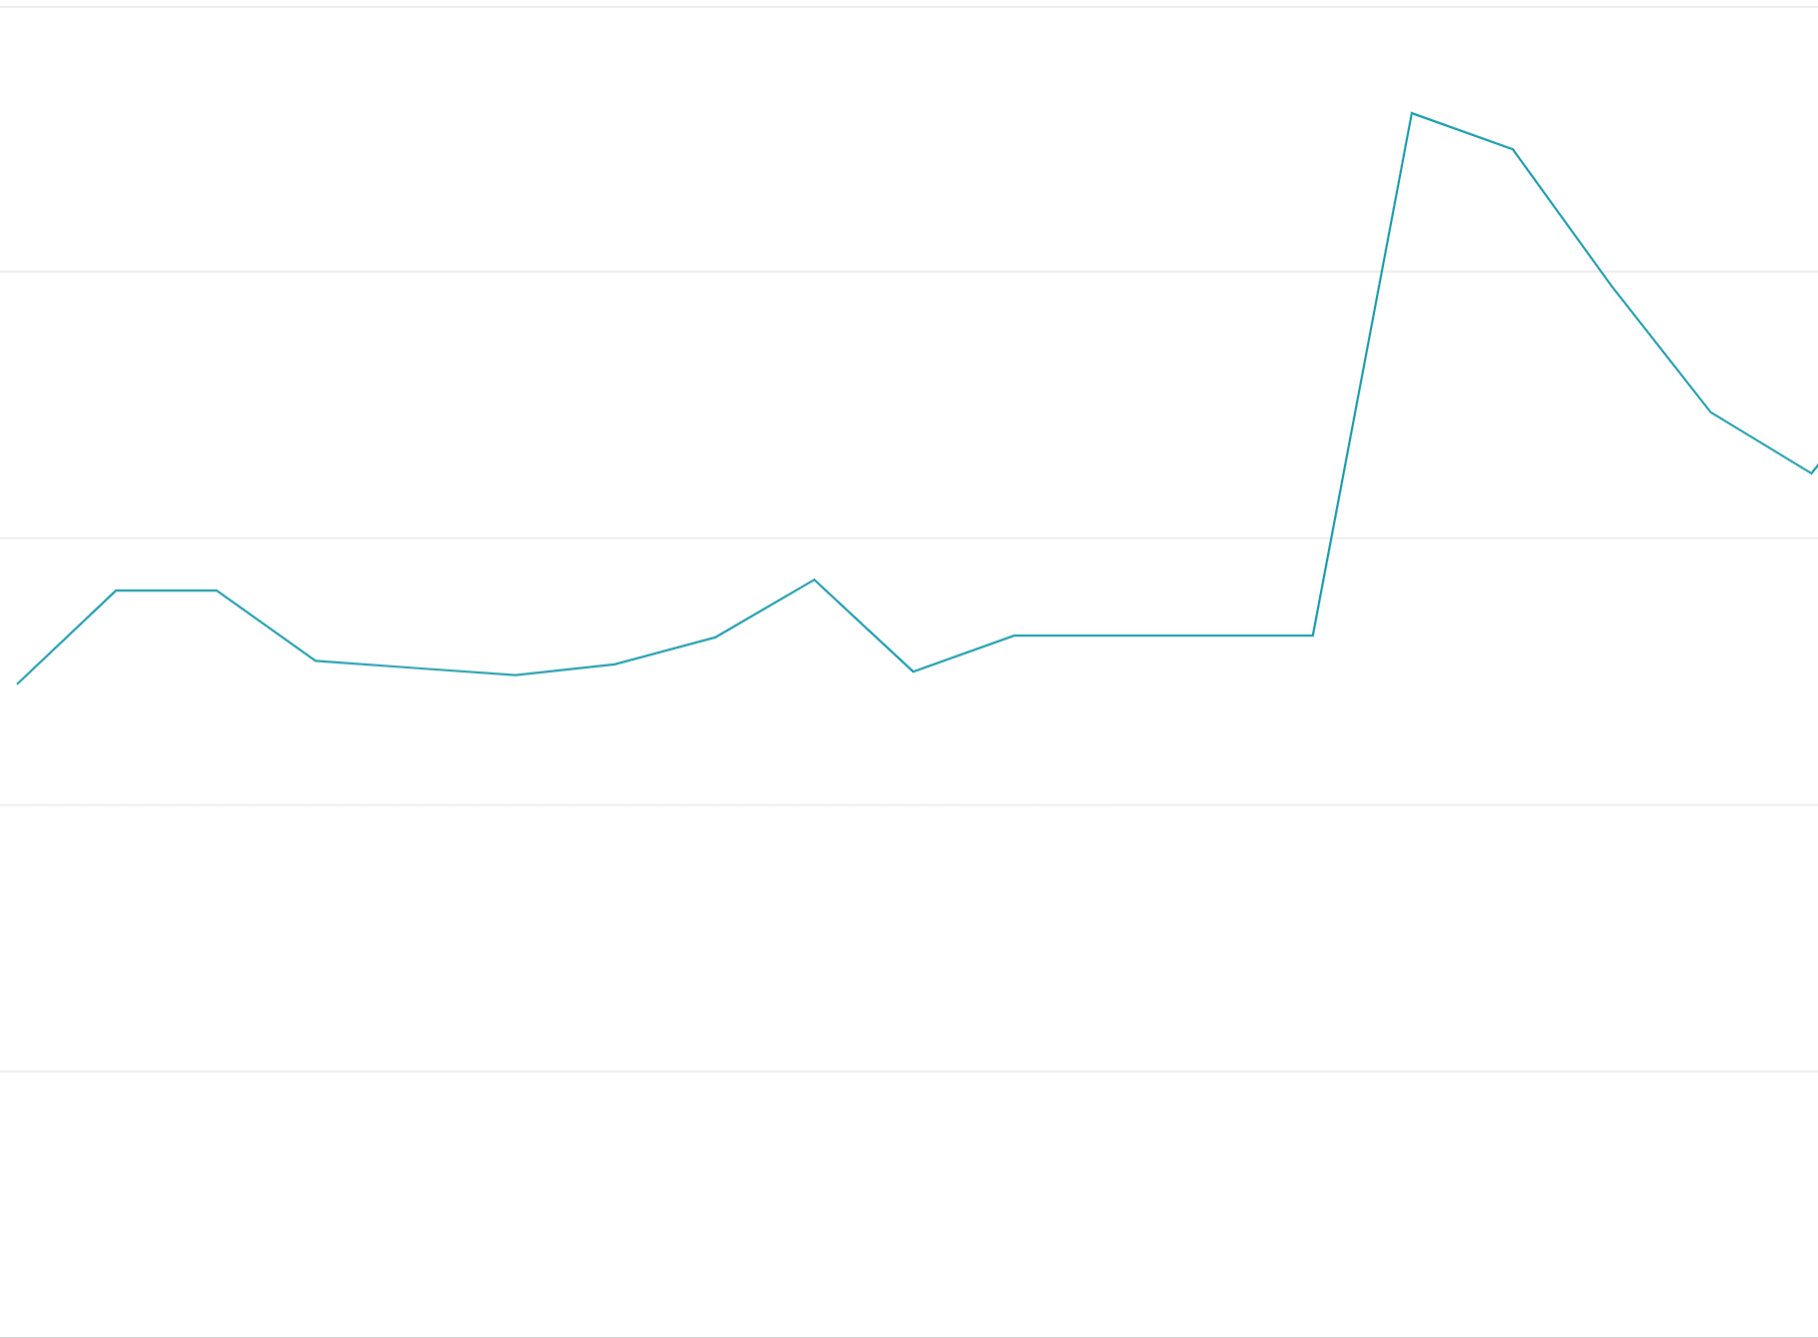
Sử dụng mã thông báo hạn mức trước: Việc sử dụng hết mã thông báo hạn mức khi bắt đầu cửa sổ hạn mức thay vì phân bổ đều các yêu cầu trong cửa sổ hạn mức sẽ tạo ra các dao động bật/tắt khó khăn và tốn kém để cân bằng tải.
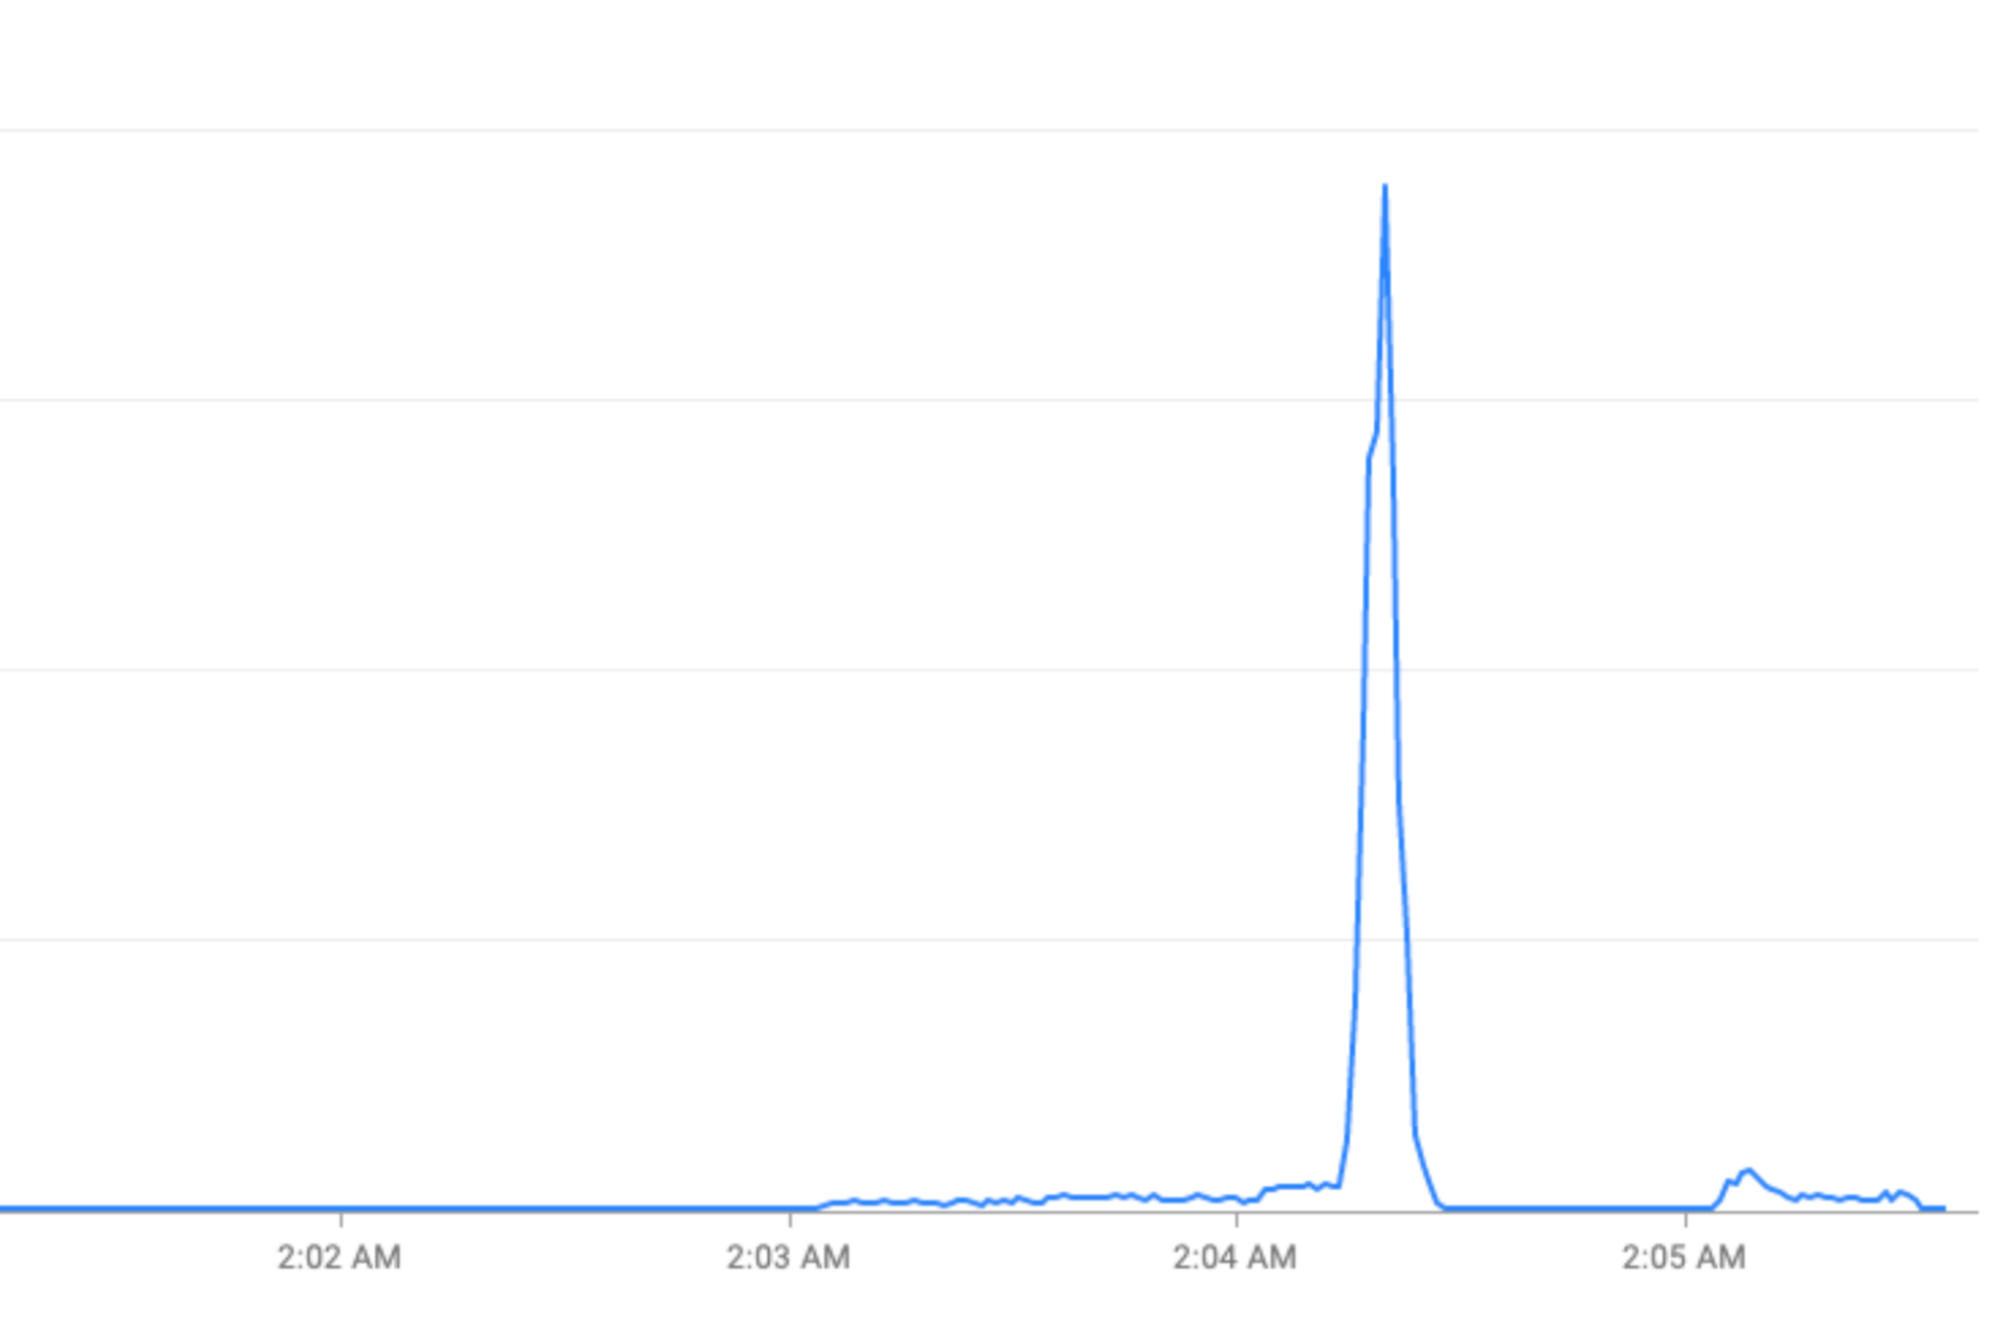
Sự kiện đặc biệt: Lưu lượng truy cập tăng đột biến trong các ngày lễ (Đêm giao thừa) hoặc sự kiện thể thao (Giải vô địch bóng đá thế giới).
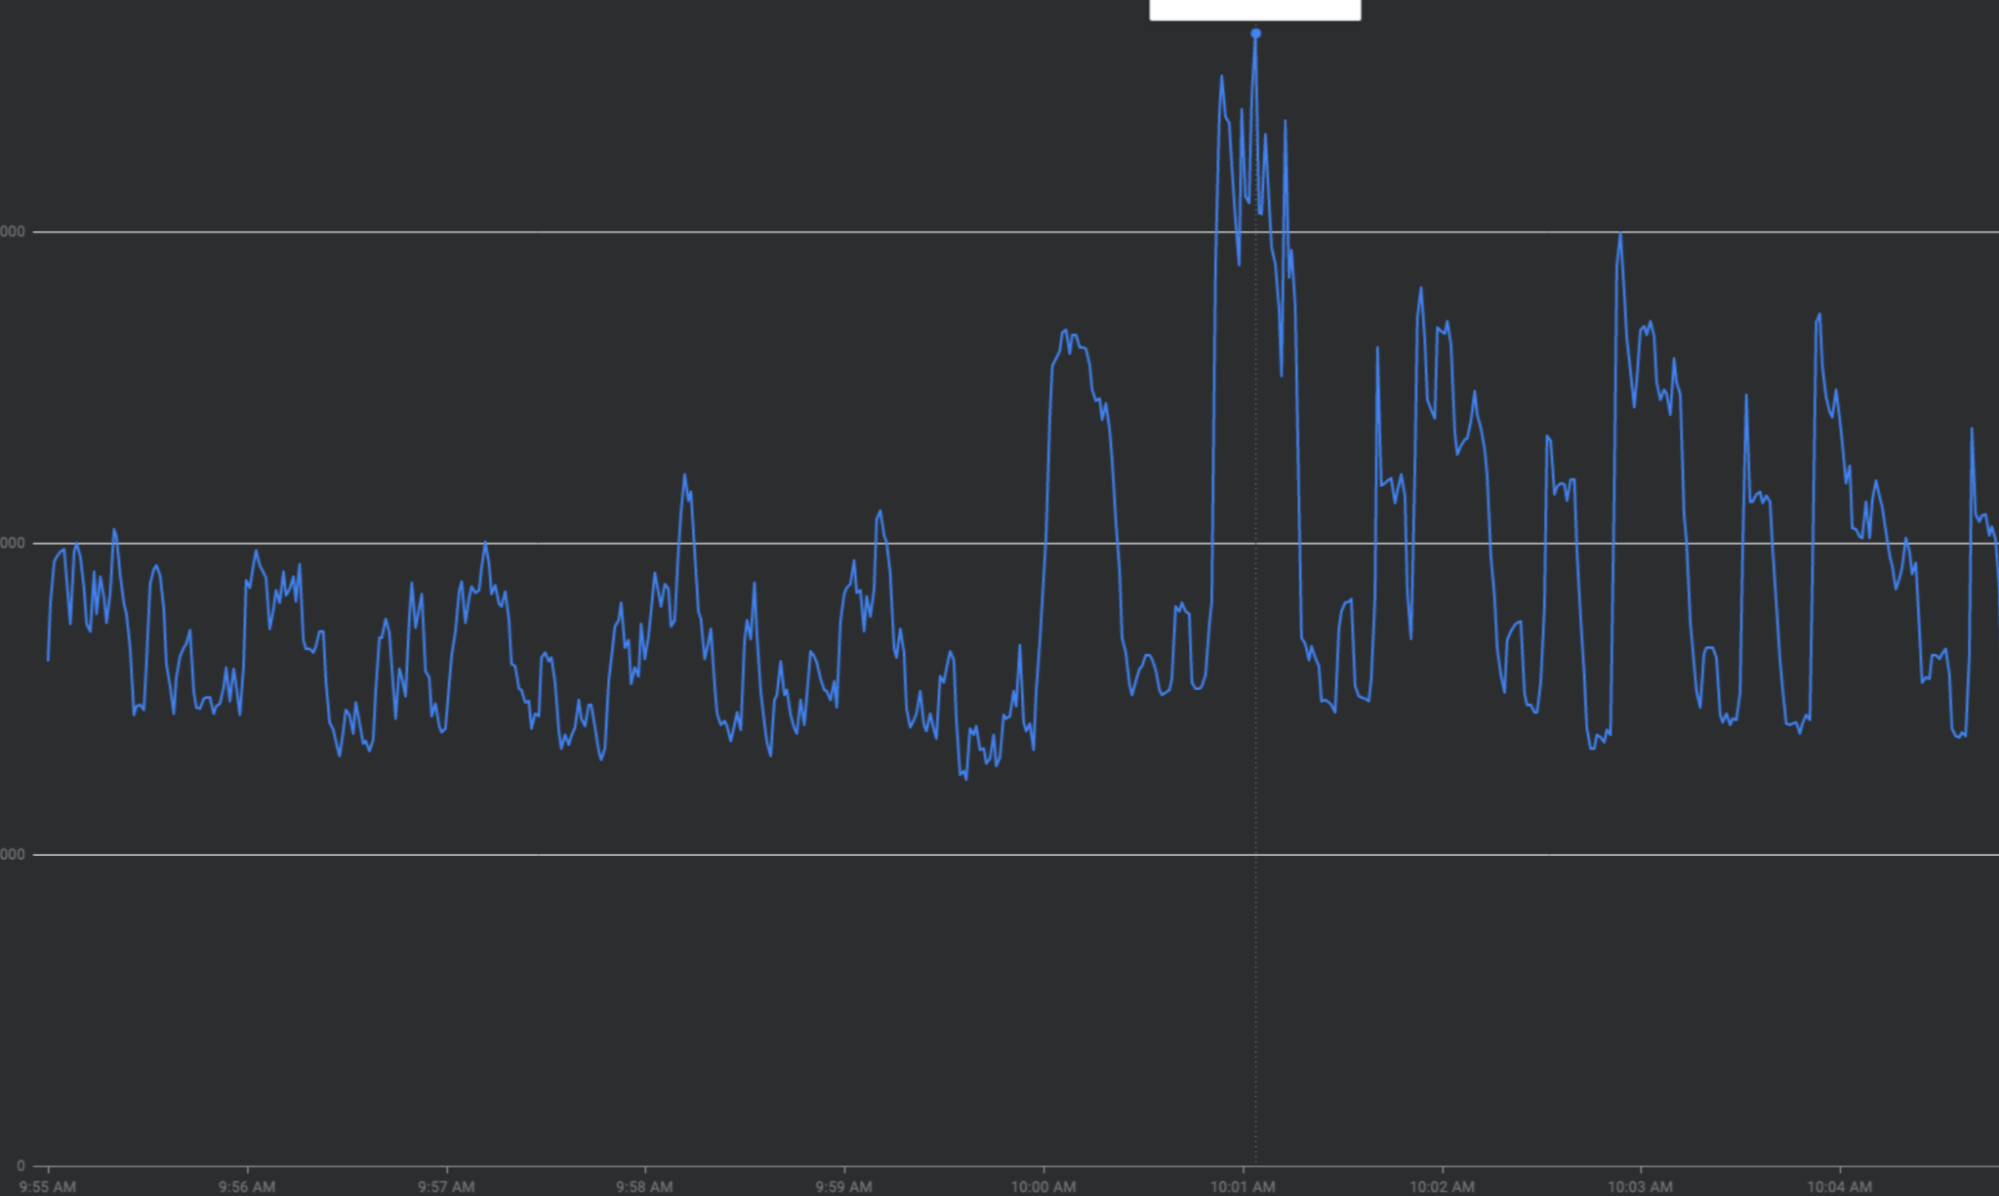
Khắc phục tình trạng tăng đột biến lưu lượng truy cập bằng cách "giảm tốc độ tăng trưởng"
Phần này mô tả các chiến lược để giảm thiểu các đợt tăng đột biến lưu lượng truy cập nếu có thể – các chiến lược để "giảm đường cong".
Chỉ sử dụng FCM cho các trường hợp sử dụng phù hợp
Có một số trường hợp sử dụng mà bạn không cần hoặc không nên dùng FCM để gửi thông báo.
Ví dụ: đối với thông báo sự kiện trên lịch, bạn có thể lên lịch cho một tác vụ cục bộ trong ứng dụng để hiển thị thông báo vào thời điểm thích hợp thay vì gửi thông báo đó từ máy chủ ứng dụng. Giới hạn số lượng thông báo FCM cho các hoạt động đồng bộ hoá lịch.
Tránh tăng đột biến
Một mẫu chống mở rộng quy mô là gửi thông báo FCM nhanh nhất có thể khi hệ thống cho phép, thay vì áp dụng tính năng điều tiết phía máy chủ. Hãy cân nhắc những điểm sau:
- Có phải tất cả khách hàng của bạn đều cần nhận được cùng một thông báo trong vòng 1 phút không? Ví dụ: khoảng thời gian giao hàng 5 phút có đáp ứng được nhu cầu của doanh nghiệp bạn không?
- Bạn có thể phân khúc khách hàng dựa trên mức độ ưu tiên để giảm bớt tình trạng tăng đột biến không?
- Bạn có thể lên lịch gửi thông báo trước không?
Bất cứ khi nào có thể: tránh những chiến lược dẫn đến việc sử dụng hết hạn mức gửi FCM ngay lập tức, chỉ để lặp lại mẫu này ngay khi nhóm mã thông báo của bạn được nạp lại. Mẫu truy cập này gây ra vấn đề về cân bằng tải cho FCM và các hệ thống phụ thuộc của FCM. Tăng lưu lượng truy cập càng chậm càng tốt. Tối thiểu, hãy tăng dần từ 0 đến RPS tối đa trong khoảng thời gian 60 giây. Ưu tiên các cửa sổ dài hơn để có RPS cao hơn.
Tránh lưu lượng truy cập "theo giờ"
Trong trường hợp có thể: tránh gửi tin nhắn trong vòng 2 phút kể từ các mốc :00, :15, :30 và :45.
Triển khai tính năng điều tiết phía máy chủ
Triển khai tính năng điều tiết phía máy chủ để theo dõi và quản lý luồng lưu lượng truy cập đến FCM.
Xử lý việc thử lại
Mặc dù FCM luôn nỗ lực để có độ sẵn sàng cao, nhưng đôi khi một số yêu cầu sẽ hết thời gian chờ hoặc không thành công. Mặc dù có nhiều lý do, nhưng các phương pháp hay nhất sau đây sẽ tối ưu hoá hành vi thử lại để gửi thư sớm nhất có thể, đồng thời giảm thiểu tác động đến tình trạng tắc nghẽn lưu lượng truy cập.
Hết thời gian chờ
Đặt thời gian chờ ít nhất là 10 giây cho các yêu cầu gửi trước khi thử lại. Hầu hết các lệnh gọi quy trình từ xa nội bộ của FCM đều sử dụng thời gian chờ 10 giây.
Lỗi
- Đối với lỗi 400, 401, 403, 404: huỷ và không thử lại.
- Đối với lỗi 429: hãy thử lại sau khi đợi khoảng thời gian được đặt trong tiêu đề retry-after. Nếu không có tiêu đề retry-after, hãy đặt mặc định là 60 giây.
- Đối với lỗi 500: thử lại với thời gian đợi luỹ thừa.
Thuật toán thời gian đợi luỹ thừa
Để tránh khuếch đại số lần thử lại, hãy triển khai thuật toán thời gian đợi luỹ thừa có thêm độ trễ ngẫu nhiên để thử lại các yêu cầu. Ví dụ: SDK của Firebase dành cho quản trị viên triển khai thuật toán thời gian đợi luỹ thừa.
Sau đây là một số chế độ cài đặt được đề xuất khác:
- Khoảng thời gian tối thiểu: Đừng thử lại ngay một yêu cầu không thành công bằng FCM. Chờ ít nhất 10 giây trước khi thử lại một yêu cầu không thành công.
- Khoảng thời gian tối đa: Đặt khoảng thời gian tối đa để loại bỏ các yêu cầu không còn kịp thời, thay vì thử lại vô thời hạn.
Nếu một yêu cầu liên tục được thử lại với thời gian đợi luỹ thừa và vẫn không thành công sau 60 phút, thì yêu cầu đó có thể bị phân loại nhầm là lỗi có thể thử lại hoặc FCM đang gặp sự cố ngừng hoạt động, trong đó việc thử lại có thể vô tình làm trầm trọng thêm tình hình.
Tạo kế hoạch triển khai và khôi phục, đồng thời thực hiện các thay đổi từng bước
Khi thực hiện các thay đổi về lưu lượng truy cập trên quy mô lớn, chẳng hạn như tăng lưu lượng truy cập vào FCM hoặc chuyển lưu lượng truy cập giữa các khu vực hoặc mạng, việc thiết kế kế hoạch triển khai/khôi phục và triển khai các thay đổi dần dần sẽ bảo vệ người dùng, dịch vụ của bạn và FCM.
- Kế hoạch ra mắt giúp các bên liên quan thống nhất kỳ vọng. Trong một số trường hợp (được thảo luận bên dưới), bạn nên chia sẻ trước kế hoạch ra mắt với nhóm FCM để tránh những điều bất ngờ.
- Kế hoạch khôi phục cho phép bạn tính đến các trường hợp bất ngờ và chuẩn bị cơ chế để khôi phục nhanh chóng và an toàn sau các lỗi không lường trước.
- Việc thực hiện các thay đổi từng bước có 2 khía cạnh:
- Tăng dần theo từng bước: Các bước nên là 1% -> 5% -> 10% -> 25% -> 50% -> 75% -> 100% hoặc nhỏ hơn. "Ngâm" (quan sát hành vi của hệ thống khi chịu tải) mỗi bước trong 1 ngày đến 1 tuần. Điều này giúp bạn phát hiện các vấn đề tiềm ẩn trước khi "bước lên" bước tiếp theo
- Tăng dần lưu lượng truy cập: Khi thực hiện từng "bước" để tăng lưu lượng truy cập, hãy tăng dần lưu lượng truy cập trong khoảng thời gian ít nhất là một giờ. Điều này cho phép cơ sở hạ tầng cân bằng tải của FCM điều chỉnh quy mô lưu lượng truy cập mới của bạn một cách phù hợp, đồng thời giảm thiểu khả năng xảy ra điểm phát sóng và tắc nghẽn.
Sau đây là một tình huống giả định về việc di chuyển 500.000 RPS trên toàn cầu từ FCM Legacy HTTP API sang FCM HTTP v1 API:
| Tuần | Bước | Chiến lược tăng dần số lượng |
|---|---|---|
| 0 | Tăng dần 1% | Tăng dần từ 0 lên 5.000 RPS đến FCM HTTP v1 trong vòng một giờ. |
| 1 | Tăng dần 5% | Tăng dần từ 5.000 lên 25.000 RPS trong 2 giờ. |
| 2 | Tăng dần 10% | Tăng dần từ 25.000 lên 50.000 RPS trong 2 giờ |
| 3 | Tăng dần 25% | Tăng từ 50.000 lên 125.000 RPS trong 3 giờ |
| 4 | Tăng dần 50% | Tăng từ 125.000 lên 250.000 RPS trong 6 giờ |
| 5 | Tăng dần số lượng lên 75% | Tăng từ 250.000 lên 375.000 RPS trong 6 giờ |
| 6 | Tăng dần 100% | Tăng từ 375.000 lên 500.000 RPS trong 6 giờ |
Kế hoạch khôi phục giả định:
- Nếu độ trễ ở phân vị thứ 95 tăng lên hơn 500 mili giây hoặc nếu tỷ lệ lỗi vượt quá 1% trong hơn một giờ ở bất kỳ bước nào, hãy sử dụng cấu hình động để khôi phục ngay về bước trước đó.
- Tiếp tục khôi phục về các bước trước đó cho đến khi độ trễ và tỷ lệ lỗi trở lại mức bình thường.
Khi nào nên liên hệ với FCM
Liên hệ với FCM thông qua Nhóm hỗ trợ Firebase nếu bạn gặp phải bất kỳ trường hợp nào sau đây:
- Hạn mức mặc định không còn đáp ứng trường hợp sử dụng của bạn
- Bạn đang thay đổi kiểu gửi trong khoảng thời gian 3 tháng ở quy mô 100.000 RPS trên toàn cầu hoặc 30.000 RPS trên toàn lục địa.