

ไม่ว่าคุณจะกำลังพัฒนาแอปที่เพิ่งเริ่มใช้งานหรือใช้งานบริการที่มีการเข้าชมสูงอยู่แล้ว คุณก็สามารถใช้ประโยชน์จากข้อมูลเชิงลึกและคำแนะนำในคู่มือนี้เกี่ยวกับวิธีปรับขนาดอย่างราบรื่นด้วย FCM แนวคิดและแนวทางปฏิบัติเหล่านี้จะช่วยให้คุณหลีกเลี่ยงผลกระทบเชิงลบเมื่อต้องส่งข้อความจำนวนมาก
คำศัพท์และแนวคิดสำคัญ
คำขอข้อความ: คำขอข้อความ FCM ซึ่งใช้แทนกันได้กับ "คำขอ" "ข้อความ" หรือ "การค้นหา"
คำขอต่อวินาที (RPS): เมตริกที่อธิบายอัตราของคำขอขาเข้าที่ส่งไปยัง FCM โดยใช้แทนกันได้กับจำนวนคำค้นหาต่อวินาที (QPS)
โทเค็นโควต้า, Bucket โทเค็น และการเติมโทเค็น: เมื่อส่งข้อความไปยัง FCM HTTP v1 API คำขอแต่ละรายการจะใช้โทเค็นโควต้าที่จัดสรรไว้ในกรอบเวลาที่กำหนด หน้าต่างนี้เรียกว่า "Bucket โทเค็น" ซึ่งจะเติมจนเต็มเมื่อสิ้นสุดกรอบเวลา ตัวอย่างเช่น HTTP v1 API จะจัดสรรโทเค็นโควต้า 600, 000 รายการสำหรับ Bucket โทเค็น 1 นาทีแต่ละรายการ ซึ่งจะเติมจนเต็มเมื่อสิ้นสุดกรอบเวลา 1 นาทีแต่ละรายการ
การควบคุมปริมาณฝั่งเซิร์ฟเวอร์: เมื่อปริมาณการเข้าชมเกินความจุของบริการ FCM ระบบจะปฏิเสธคำขอที่เกินความจุในการแสดงผลเพื่อจำกัดอัตราการไหลเข้า ระบบอาจแสดงการตอบกลับข้อผิดพลาด 429 พร้อมส่วนหัว retry-after เพื่อระบุว่าคุณควรรอเป็นระยะเวลาหนึ่งก่อนที่จะลองส่งคำขออีกครั้ง
การจำกัดอัตราคำขอฝั่งไคลเอ็นต์: เมื่อไคลเอ็นต์พบคำขอที่ล้มเหลว เวลาในการตอบสนองสูง หรือข้อผิดพลาด 429 ไคลเอ็นต์ควรจำกัดอัตราคำขอขาออกโดยสมัครใจเพื่อหลีกเลี่ยงการทำให้ความแออัดแย่ลง
Exponential Backoff: เมื่อลองแก้ไขข้อผิดพลาดอีกครั้ง ให้เพิ่มระยะเวลาหน่วงแบบทวีคูณ เช่น 1 วินาที, 2 วินาที, 4 วินาที, 8 วินาที, 16 วินาที, 32 วินาที และต่อไปเรื่อยๆ
การเพิ่มความผันแปร (Jittering): หลีกเลี่ยงการส่งคำขออีกครั้งตามช่วงเวลาที่แน่นอน เมื่อใช้ Jittering คุณจะเปลี่ยนความล่าช้าในการลองใหม่ผ่านกระบวนการสุ่มเพื่อกระจายความล่าช้าอย่างสม่ำเสมอเมื่อเวลาผ่านไป (เช่น 0.9 วินาที, 2.3 วินาที, 4.1 วินาที, 8.5 วินาที, 17.9 วินาที, 34.7 วินาที)
การขยายการลองใหม่: เมื่อมีการลองส่งคำขอที่ล้มเหลวอีกครั้งโดยไม่มี Exponential Backoff/ความผันผวน คำขอเหล่านั้นมักจะสะสมและเพิ่มภาระการเข้าชมที่ดำเนินอยู่ ซึ่งอาจ "ขยาย" และทำให้ปัญหาความแออัดของการเข้าชมรุนแรงขึ้น
ปัญหา: การเข้าชมที่เพิ่มขึ้นอย่างรวดเร็ว
FCM ประมวลผลคำขอหลายล้านรายการต่อวินาที (RPS) ปัจจัยที่ส่งผลมากที่สุดต่อความแออัดของระบบ ปัญหาเวลาในการตอบสนอง และการหยุดทำงานคือการเข้าชมที่เพิ่มขึ้นอย่างรวดเร็ว
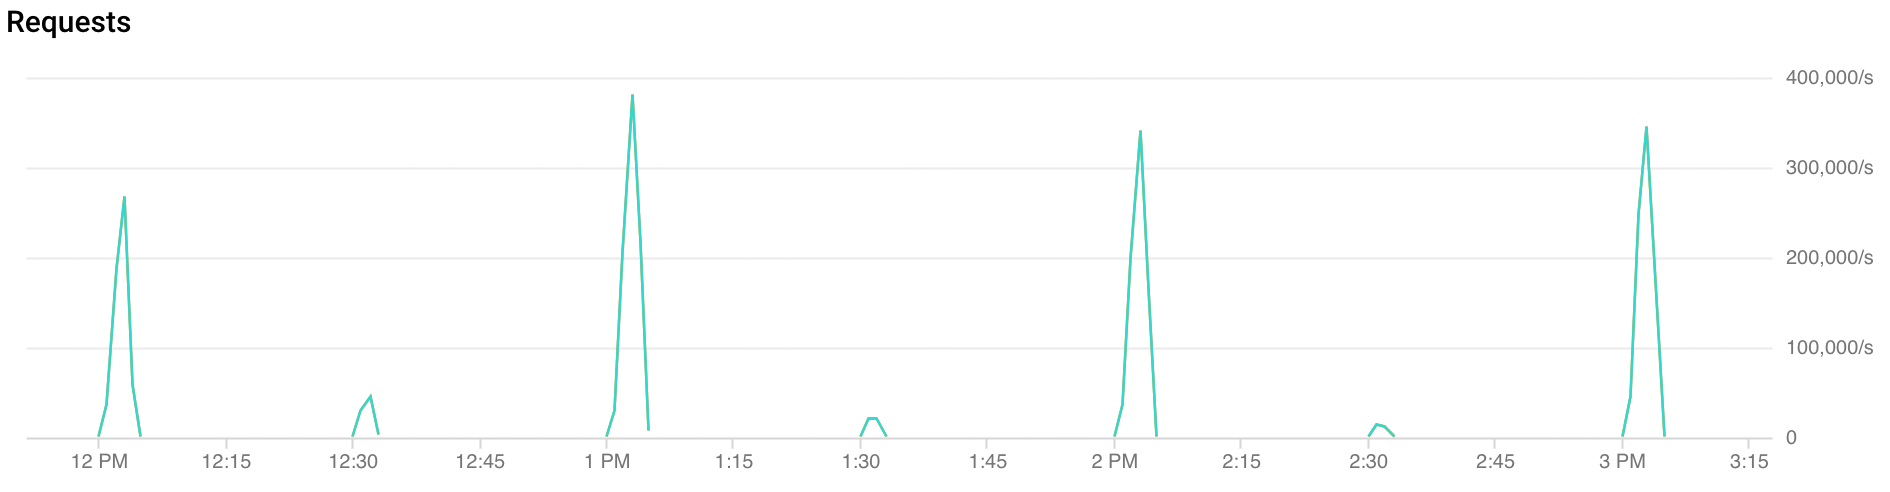
การเข้าชมที่พุ่งสูงขึ้นคืออะไร
การเข้าชมที่เพิ่มขึ้นอย่างฉับพลันมีหลายประเภท ดังนี้
การเพิ่มขึ้นอย่างรวดเร็วทุกๆ ชั่วโมง: FCM ได้รับการเข้าชมเพิ่มขึ้นมากกว่า 2 เท่าในช่วง 30 วินาทีถึง 2 นาทีแรกของแต่ละชั่วโมง นอกจากนี้ ยังพบการเพิ่มขึ้นอย่างรวดเร็วที่คล้ายกันแต่มีจำนวนน้อยกว่าในช่วงครึ่งชั่วโมงและ 15 นาที (เช่น 00:15, 00:30, 00:45)
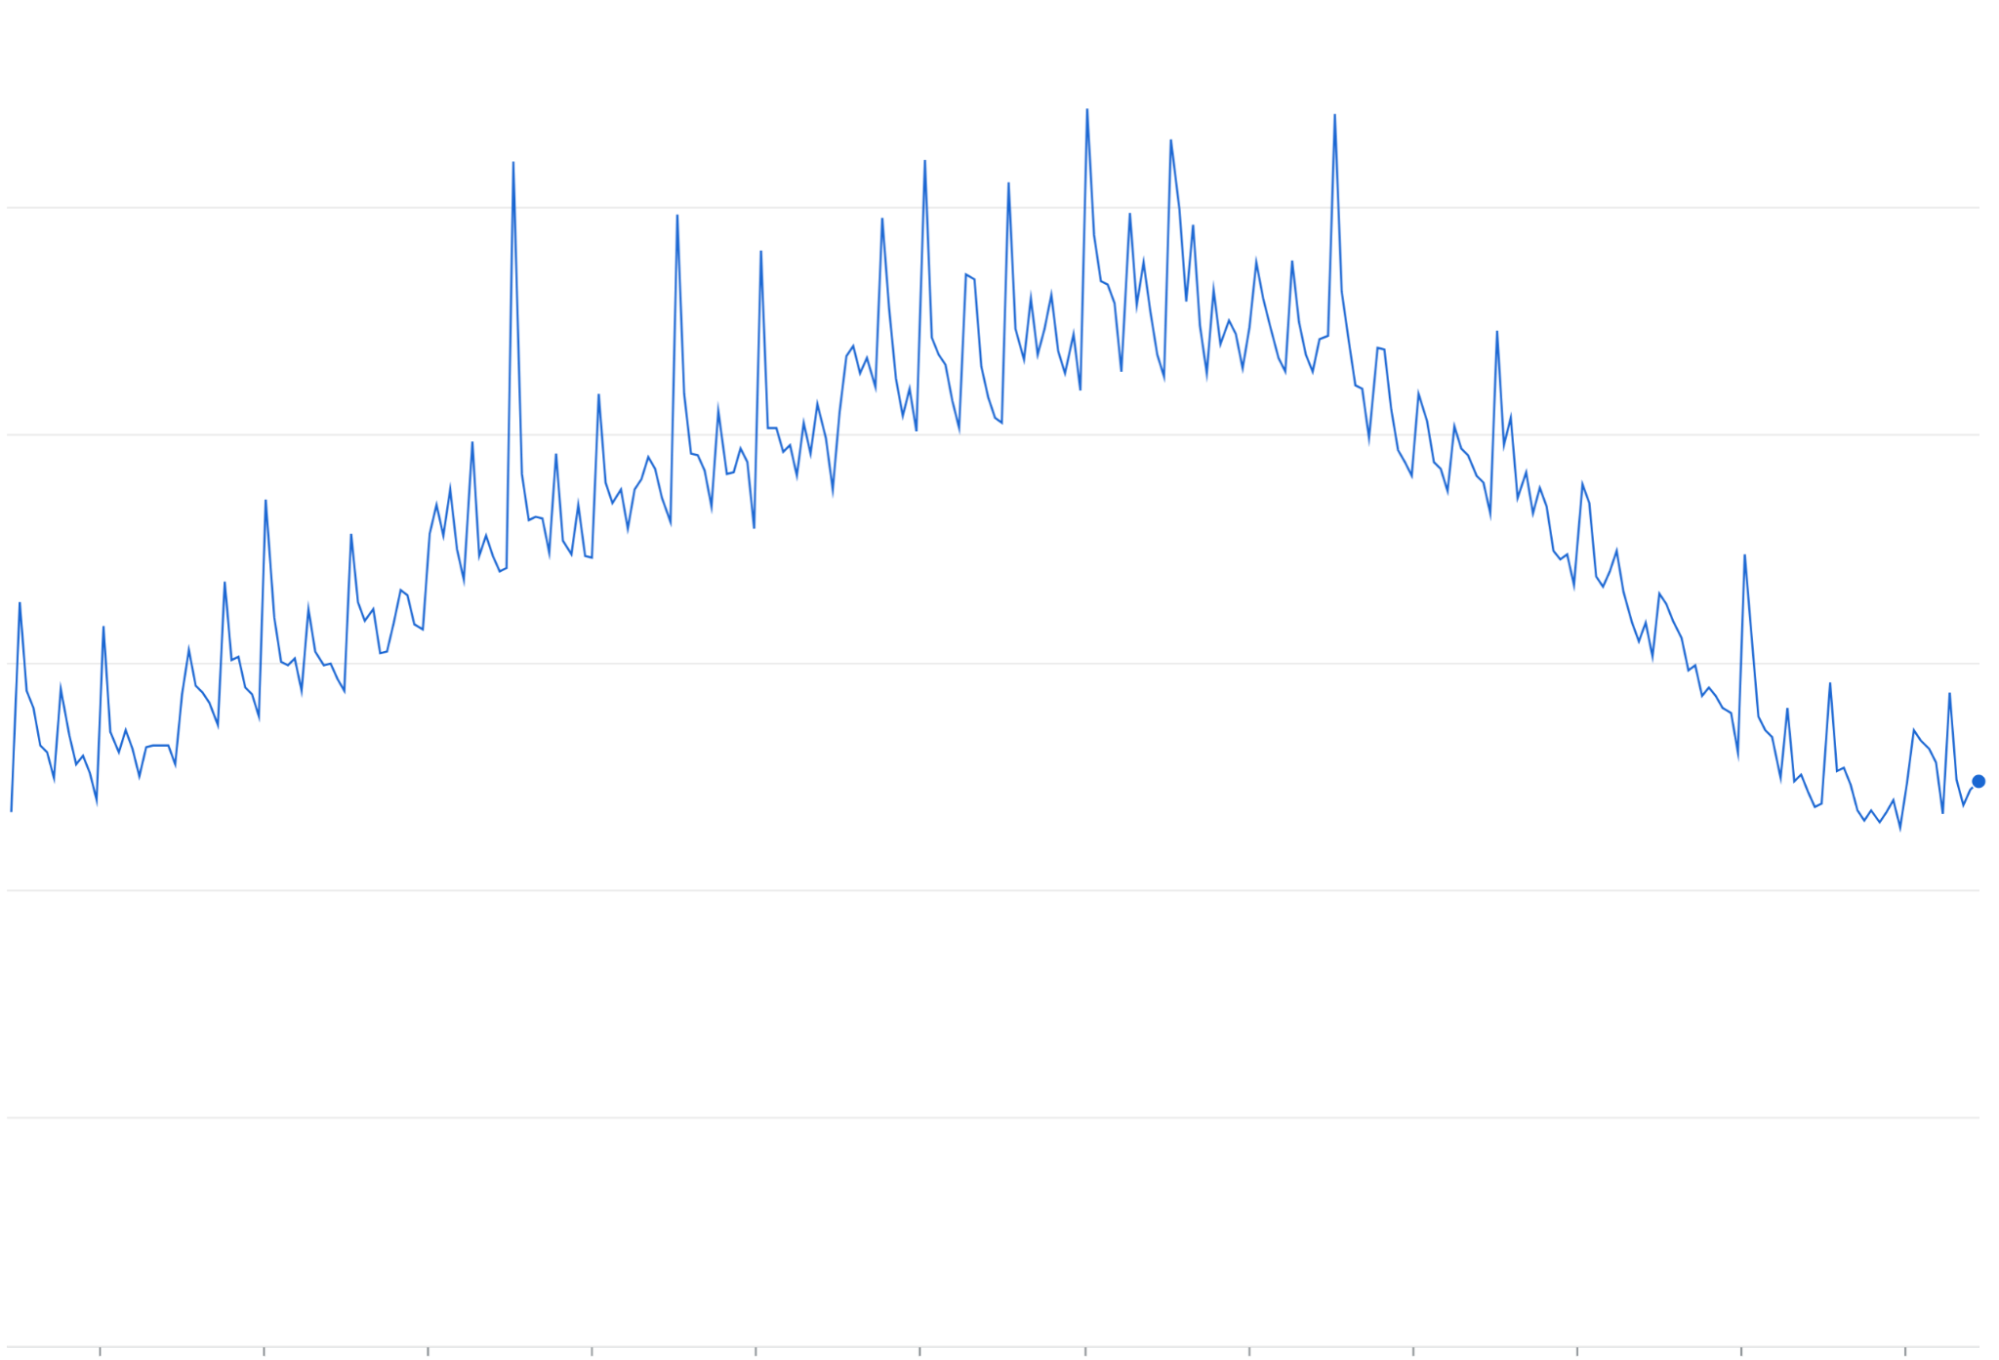
การขยายการลองใหม่: การลองส่งคำขอที่ล้มเหลวหรือหมดเวลาอีกครั้งโดยไม่มี Exponential Backoff อาจทำให้เกิดการเข้าชมที่ซ้ำกันจำนวนมากนอกเหนือจากการเข้าชมที่มีอยู่
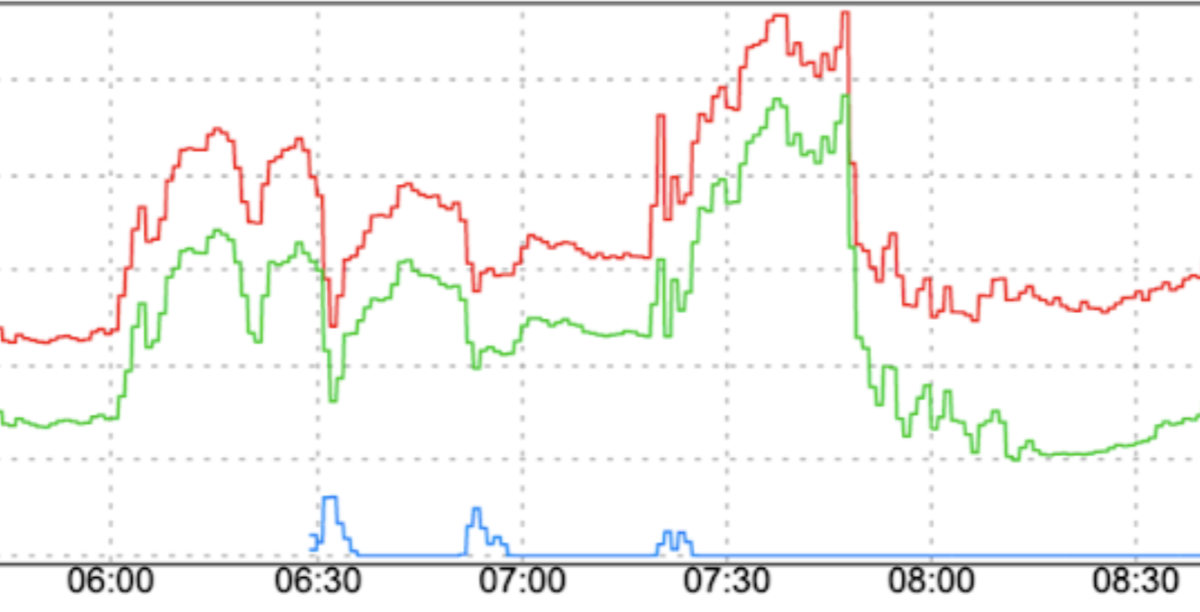
การเปลี่ยนแปลงรูปแบบการเข้าชมอย่างฉับพลัน: การกำหนดเส้นทางการเข้าชมใหม่ไปยัง FCM หรือการย้ายการเข้าชมไปยัง FCM ในภูมิภาคต่างๆ โดยไม่มีปัจจัยที่ช่วยให้ราบรื่น เช่น การเพิ่มขึ้นทีละน้อย อาจทำให้เกิดการเพิ่มขึ้นอย่างฉับพลัน
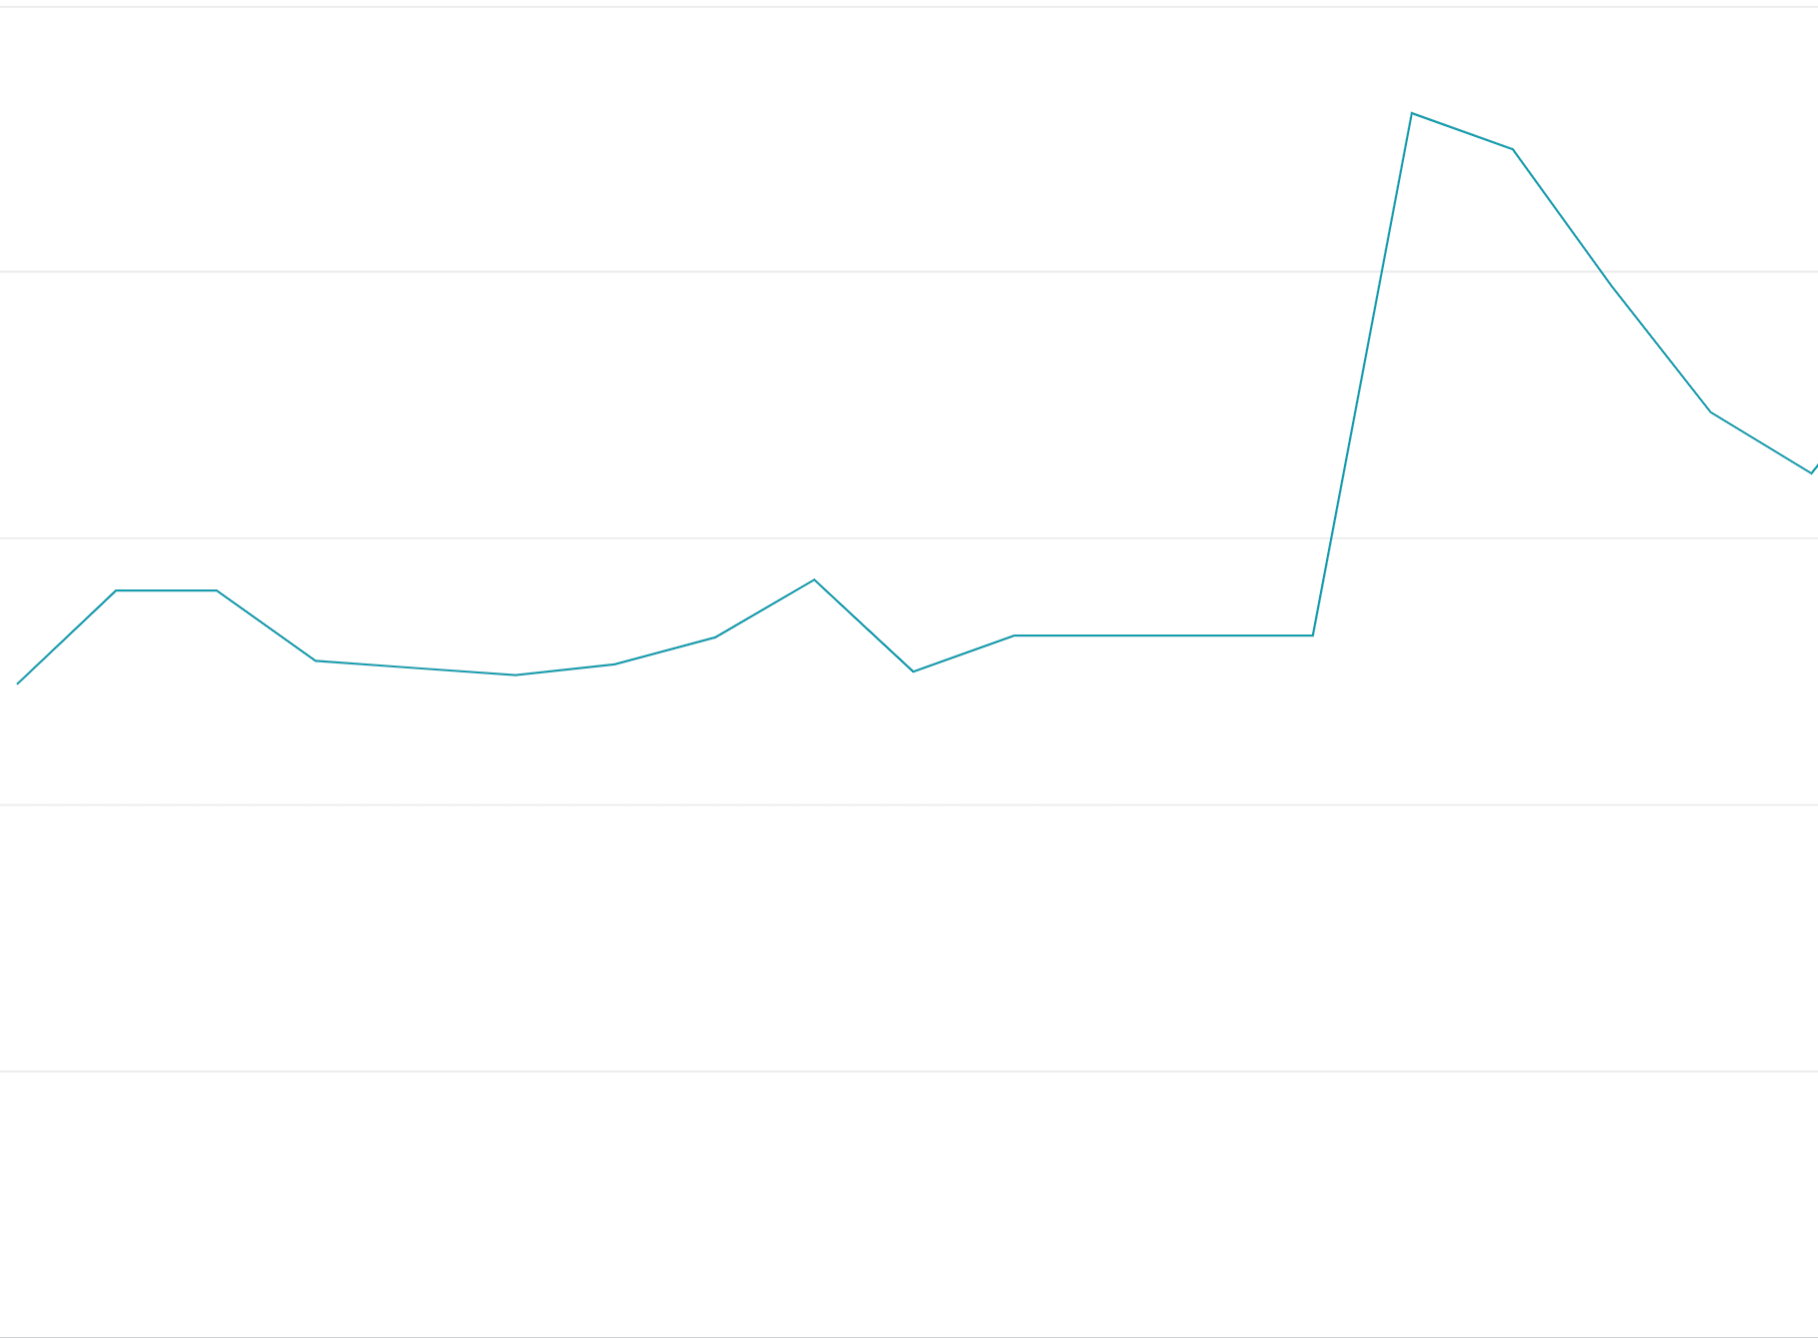
การใช้โทเค็นโควต้าแบบ Front-loading: การใช้โทเค็นโควต้าทั้งหมดจนหมดเมื่อเริ่มกรอบเวลาโควต้าแทนที่จะกระจายคำขออย่างสม่ำเสมอทั่วทั้งกรอบเวลาโควต้าจะทำให้เกิดความผันผวนแบบเปิด-ปิดซึ่งยากต่อการจัดสรรภาระงานและมีค่าใช้จ่ายสูง
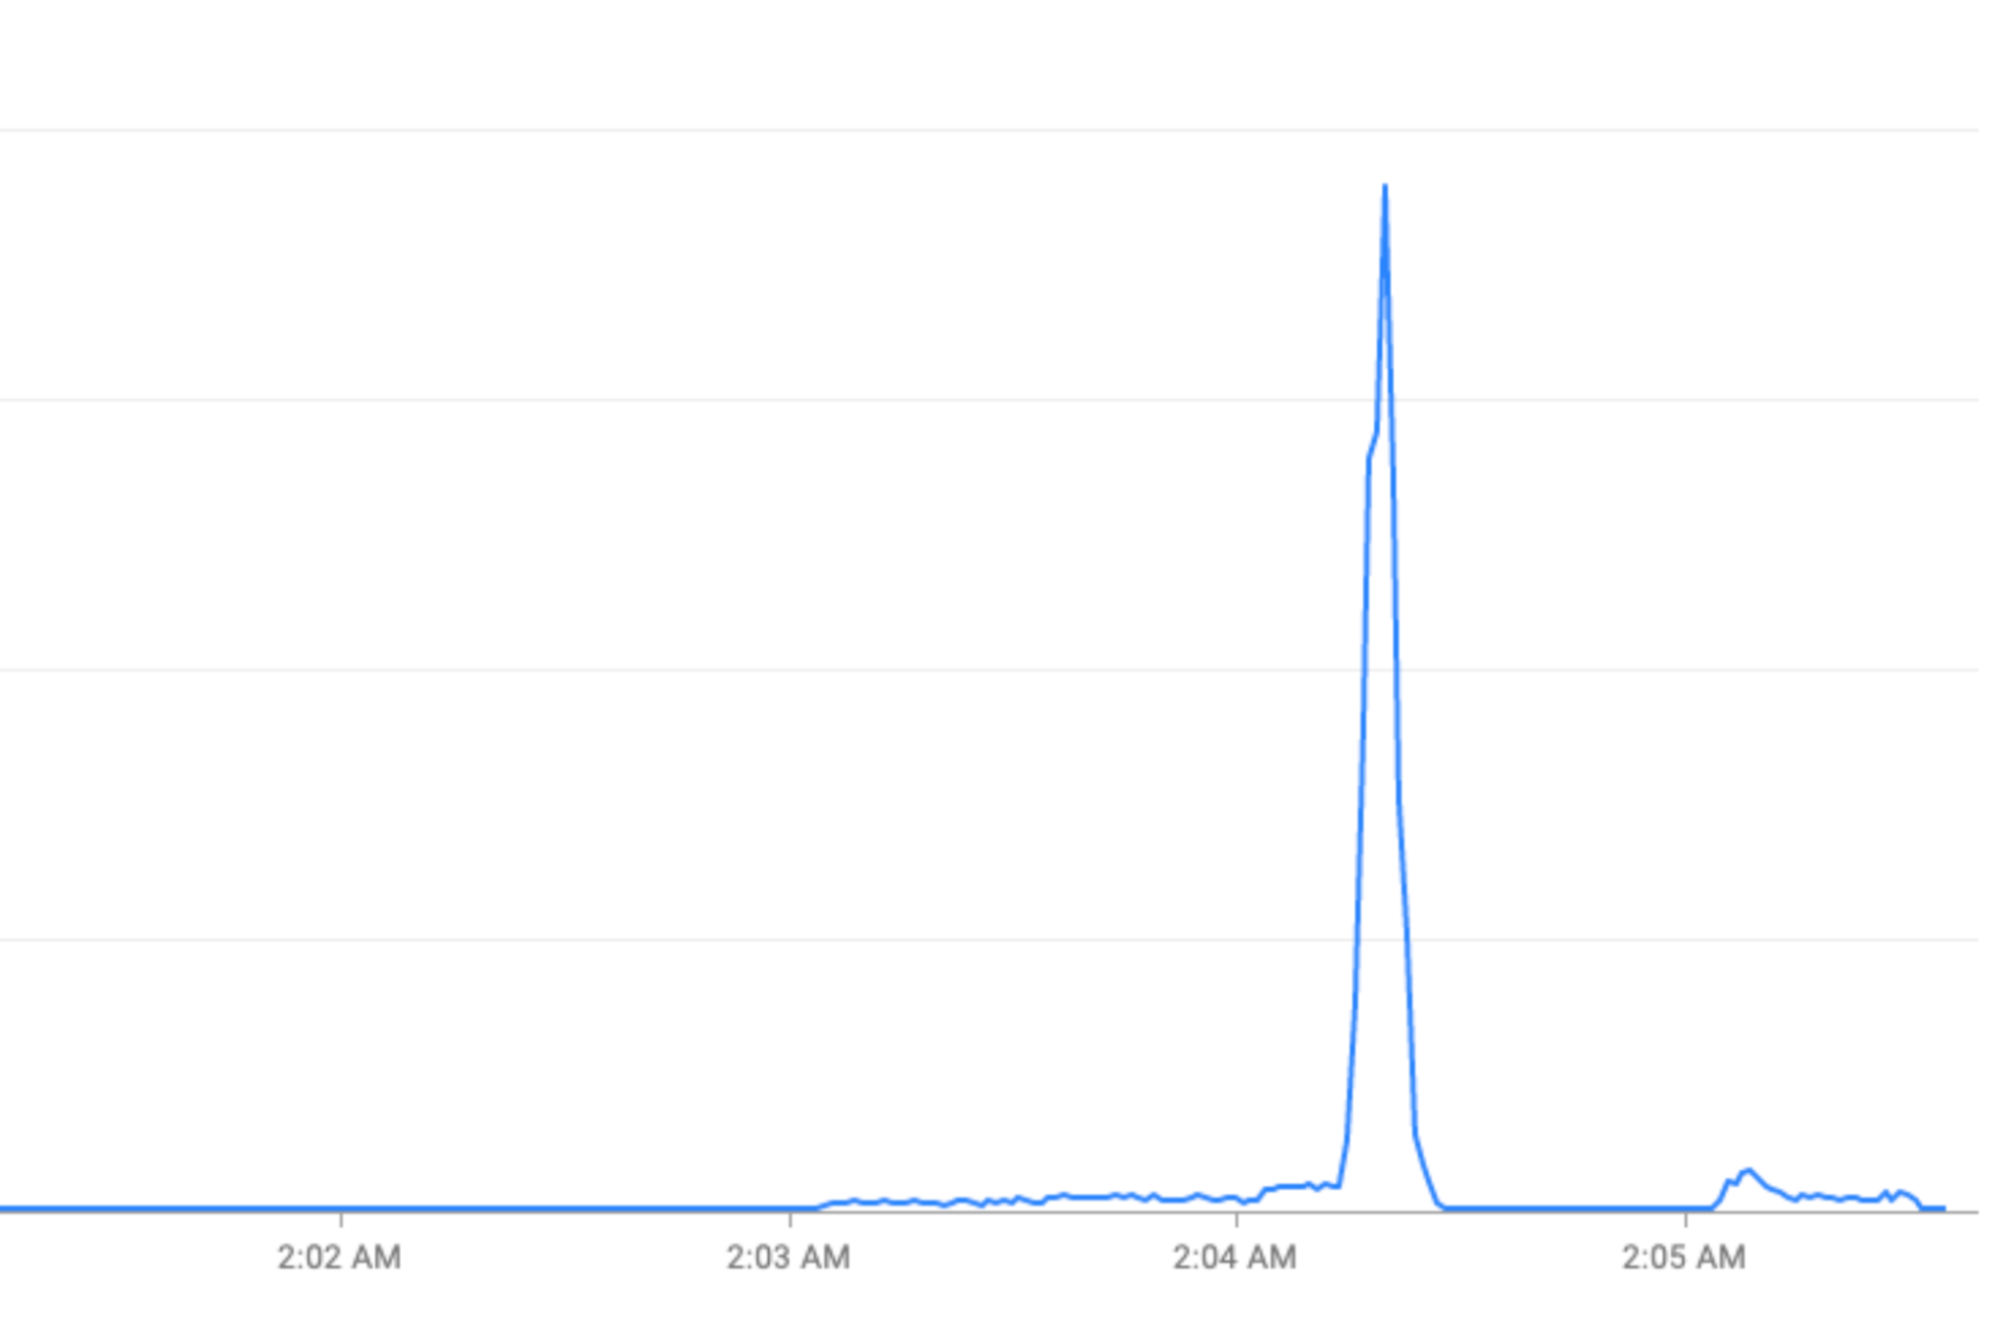
กิจกรรมพิเศษ: การเข้าชมพุ่งสูงขึ้นในช่วงวันหยุด (วันส่งท้ายปีเก่า) หรือการแข่งขันกีฬา (ฟุตบอลโลก FIFA)
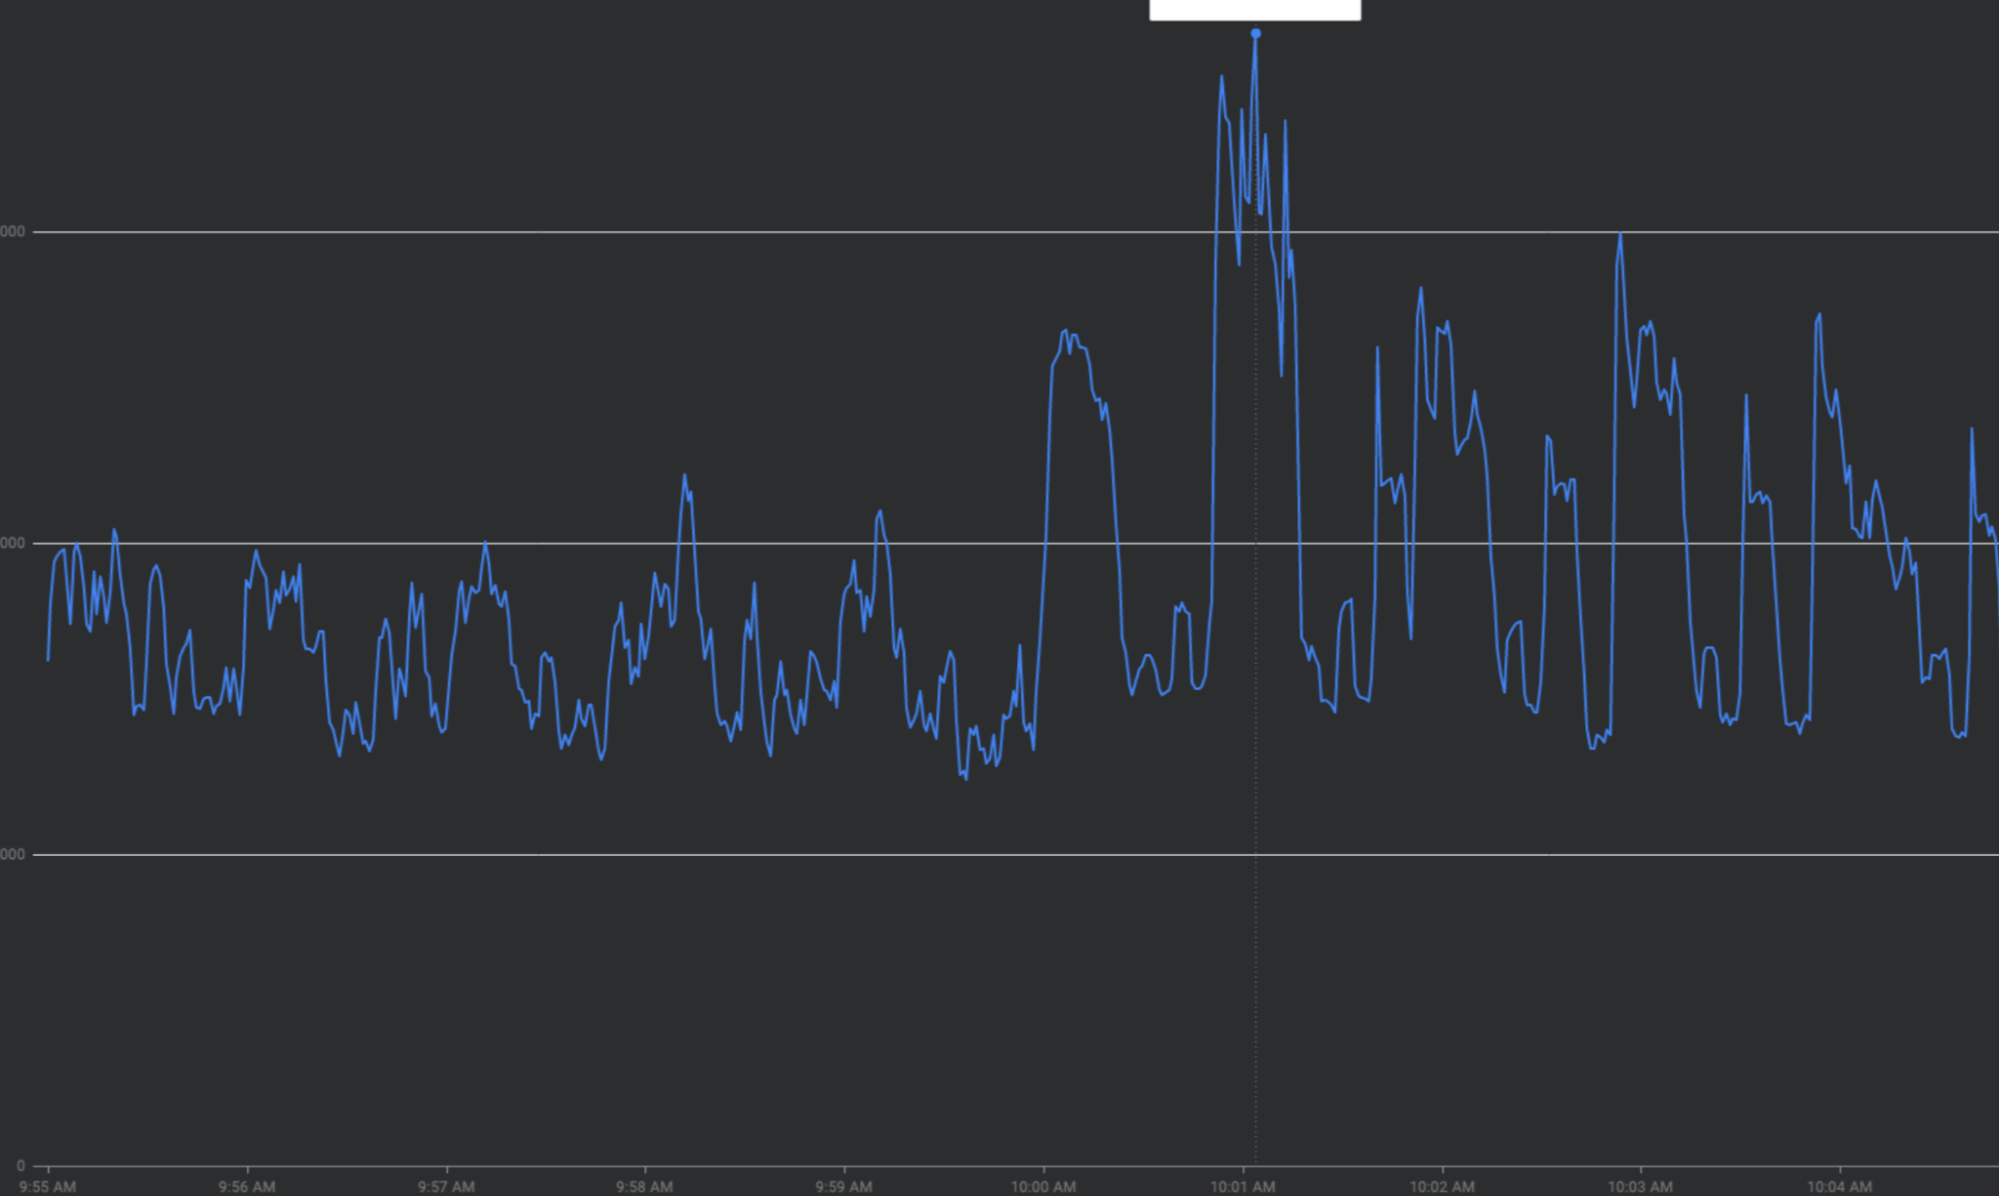
แก้ไขปัญหาการเข้าชมที่เพิ่มขึ้นอย่างรวดเร็วด้วยการ "ลดความชันของกราฟ"
ส่วนนี้จะอธิบายกลยุทธ์ในการลดการเข้าชมที่เพิ่มขึ้นอย่างฉับพลันเมื่อเป็นไปได้ ซึ่งเป็นกลยุทธ์ในการ "ลดความชันของเส้นโค้ง"
ใช้ FCM สำหรับกรณีการใช้งานที่เหมาะสมเท่านั้น
มีบางกรณีการใช้งานที่การใช้ FCM เพื่อส่งการแจ้งเตือนไม่จำเป็นหรือไม่เหมาะสม
ตัวอย่างเช่น สำหรับการแจ้งเตือนกิจกรรมในปฏิทิน คุณสามารถกำหนดเวลางานในเครื่องในแอปเพื่อแสดงการแจ้งเตือนในเวลาที่เหมาะสมแทนการส่งจากเซิร์ฟเวอร์แอป จำกัดข้อความ FCM สำหรับการซิงค์ปฏิทิน
หลีกเลี่ยงการเพิ่มขึ้นอย่างรวดเร็ว
รูปแบบต่อต้านการปรับขนาดอย่างหนึ่งคือการส่งการแจ้งเตือน FCM ให้เร็วที่สุดเท่าที่ระบบจะอนุญาต แทนที่จะใช้การควบคุมฝั่งเซิร์ฟเวอร์ ลองพิจารณาสิ่งเหล่านี้
- ลูกค้าทุกคนจำเป็นต้องได้รับการแจ้งเตือนเดียวกันภายในกรอบเวลา 1 นาทีหรือไม่ ตัวอย่างเช่น กรอบเวลาการนำส่ง 5 นาทีจะยังคงตอบสนองความต้องการทางธุรกิจของคุณหรือไม่
- คุณสามารถแบ่งกลุ่มลูกค้าตามลำดับความสำคัญเพื่อลดความผันผวนได้ไหม
- ฉันจะกำหนดเวลาการแจ้งเตือนล่วงหน้าได้ไหม
เมื่อเป็นไปได้: หลีกเลี่ยงกลยุทธ์ที่ส่งผลให้โควต้าการส่ง FCM หมดลงทันที เพียงเพื่อทำซ้ำรูปแบบเดิมทันทีที่ Bucket โทเค็นเติมใหม่ รูปแบบการเข้าถึงนี้ทำให้เกิดปัญหาการจัดสรรภาระงานสำหรับ FCM และระบบที่เกี่ยวข้อง เพิ่มการเข้าชมอย่างค่อยเป็นค่อยไปให้มากที่สุด อย่างน้อยที่สุด ให้เพิ่มจาก 0 เป็น RPS สูงสุดในกรอบเวลา 60 วินาที เลือกกรอบเวลาที่นานขึ้นเพื่อให้ได้ RPS ที่สูงขึ้น
หลีกเลี่ยงการเข้าชมที่ "ตรงเวลา"
หากเป็นไปได้: หลีกเลี่ยงการส่งข้อความภายในกรอบเวลา 2 นาทีของทุกๆ นาทีที่ :00, :15, :30 และ :45
ใช้การควบคุมฝั่งเซิร์ฟเวอร์
ใช้การควบคุมฝั่งเซิร์ฟเวอร์เพื่อตรวจสอบและจัดการการไหลของการเข้าชมไปยัง FCM
การจัดการการลองใหม่
แม้ว่า FCM จะพยายามให้บริการพร้อมใช้งานสูง แต่บางครั้งคำขอบางรายการอาจหมดเวลาหรือดำเนินการไม่สำเร็จ แม้ว่าสาเหตุจะแตกต่างกันไป แต่แนวทางปฏิบัติแนะนำต่อไปนี้จะเพิ่มประสิทธิภาพลักษณะการลองใหม่เพื่อส่งข้อความโดยเร็วที่สุด พร้อมทั้งลดผลกระทบต่อความแออัดของการรับส่งข้อมูล
การระงับข้อความชั่วคราว
ตั้งค่าระยะหมดเวลาอย่างน้อย 10 วินาทีสำหรับคำขอส่งก่อนที่จะลองอีกครั้ง การเรียกใช้โพรซีเยอร์ระยะไกล (RPC) ภายในส่วนใหญ่ของ FCM จะใช้ระยะหมดเวลา 10 วินาที
ข้อผิดพลาด
- สำหรับข้อผิดพลาด 400, 401, 403, 404 ให้ยกเลิกและไม่ต้องลองอีกครั้ง
- สำหรับข้อผิดพลาด 429: ให้ลองอีกครั้งหลังจากรอตามระยะเวลาที่กำหนดไว้ในส่วนหัว retry-after หากไม่ได้ตั้งค่าส่วนหัว retry-after ระบบจะใช้ค่าเริ่มต้นเป็น 60 วินาที
- สำหรับข้อผิดพลาด 500: ให้ลองอีกครั้งโดยใช้ Exponential Backoff
Exponential Backoff
เพื่อหลีกเลี่ยงการขยายการลองใหม่ ให้ใช้ Exponential Backoff ที่มี Jittering สำหรับคำขอที่ลองใหม่ ตัวอย่างเช่น Firebase Admin SDK จะใช้ Exponential Backoff
การตั้งค่าที่แนะนำเพิ่มเติมมีดังนี้
- ช่วงเวลาขั้นต่ำ: อย่าลองส่งคำขอที่ล้มเหลวอีกครั้งด้วย FCM ทันที รออย่างน้อย 10 วินาทีก่อนลองส่งคำขอที่ล้มเหลวอีกครั้ง
- ช่วงเวลาสูงสุด: กำหนดช่วงเวลาสูงสุดสำหรับการยกเลิกคำขอที่ไม่ทันเวลาอีกต่อไป แทนที่จะลองใหม่ไปเรื่อยๆ
หากมีการลองส่งคำขอซ้ำอย่างต่อเนื่องด้วย Exponential Backoff และยังคงไม่สำเร็จหลังจากผ่านไป 60 นาที แสดงว่าคำขอดังกล่าวได้รับการจัดหมวดหมู่ผิดเป็นข้อผิดพลาดที่ลองใหม่ได้ หรือ FCM กำลังประสบปัญหาการหยุดทำงานซึ่งการลองใหม่อาจทำให้สถานการณ์แย่ลงโดยไม่ตั้งใจ
สร้างแผนการเปิดตัวและการย้อนกลับ รวมถึงทำการเปลี่ยนแปลงแบบค่อยเป็นค่อยไป
เมื่อทำการเปลี่ยนแปลงการรับส่งข้อมูลขนาดใหญ่ เช่น การเพิ่มการรับส่งข้อมูลไปยัง FCM หรือการเปลี่ยนการรับส่งข้อมูลข้ามภูมิภาคหรือเครือข่าย การออกแบบแผนการเปิดตัว/ย้อนกลับและการใช้การเปลี่ยนแปลงแบบค่อยเป็นค่อยไปจะช่วยปกป้องผู้ใช้ บริการ และ FCM
- แผนการเปิดตัวจะช่วยให้ผู้มีส่วนเกี่ยวข้องมีความคาดหวังที่สอดคล้องกัน ในบางสถานการณ์ (ตามที่อธิบายไว้ด้านล่าง) คุณอาจต้องการแชร์แผนการเปิดตัวล่วงหน้ากับทีม FCM เพื่อหลีกเลี่ยงปัญหาที่ไม่คาดคิด
- แผนการย้อนกลับช่วยให้คุณพิจารณาถึงเหตุการณ์ฉุกเฉินและเตรียมกลไกเพื่อกู้คืนจากความล้มเหลวที่ไม่คาดคิดได้อย่างรวดเร็วและปลอดภัย
- การเปลี่ยนแปลงแบบค่อยเป็นค่อยไปมี 2 ด้าน ดังนี้
- การเพิ่มขึ้นแบบ "เป็นขั้นเป็นตอน": ขั้นตอนควรเป็น 1% -> 5% -> 10% -> 25% -> 50% -> 75% -> 100% หรือละเอียดกว่านั้น "สังเกตการณ์" (สังเกตลักษณะการทำงานของระบบภายใต้ภาระงาน) แต่ละขั้นตอนเป็นเวลา 1 วันถึง 1 สัปดาห์ ซึ่งจะช่วยให้คุณพบปัญหาที่อาจเกิดขึ้นก่อนที่จะ "ก้าวขึ้น" ไปยังระดับถัดไป
- การเพิ่มการเข้าชมทีละน้อย: เมื่อทำ "ขั้นตอน" แต่ละขั้นเพื่อเพิ่มการเข้าชม ให้กระจายการเข้าชมให้สม่ำเสมอเป็นระยะเวลาอย่างน้อย 1 ชั่วโมง ซึ่งจะช่วยให้โครงสร้างพื้นฐานการจัดสรรภาระงานของ FCM ปรับขนาดการเข้าชมใหม่ได้อย่างเหมาะสม พร้อมทั้งลดโอกาสที่จะเกิดฮอตสปอตและความแออัด
ต่อไปนี้เป็นสถานการณ์สมมติสำหรับการย้ายข้อมูล 500,000 RPS ทั่วโลกจาก FCM Legacy HTTP API ไปยัง FCM HTTP v1 API
| สัปดาห์ | Step | กลยุทธ์การเพิ่มจำนวนแบบค่อยเป็นค่อยไป |
|---|---|---|
| 0 | การเพิ่มจำนวน 1% | เพิ่ม RPS จาก 0 เป็น 5,000 ไปยัง FCM HTTP v1 อย่างราบรื่นในระยะเวลา 1 ชั่วโมง |
| 1 | เพิ่มขึ้น 5% | เพิ่ม RPS จาก 5,000 เป็น 25,000 อย่างราบรื่นในระยะเวลา 2 ชั่วโมง |
| 2 | การเพิ่มจำนวน 10% | เพิ่มขึ้นอย่างราบรื่นจาก 25,000 เป็น 50,000 RPS ในช่วง 2 ชั่วโมง |
| 3 | การเพิ่มจำนวน 25% | เพิ่มจาก 50,000 เป็น 125,000 RPS ในระยะเวลา 3 ชั่วโมง |
| 4 | การเพิ่มจำนวน 50% | เพิ่มจาก 125,000 เป็น 250,000 RPS ในระยะเวลา 6 ชั่วโมง |
| 5 | การเพิ่มจำนวน 75% | เพิ่มจาก 250,000 เป็น 375,000 RPS ในระยะเวลา 6 ชั่วโมง |
| 6 | การเพิ่มจำนวน 100% | เพิ่มจาก 375,000 เป็น 500,000 RPS ในระยะเวลา 6 ชั่วโมง |
ตัวอย่างสมมติของแผนย้อนกลับ
- หากเวลาในการตอบสนองเปอร์เซ็นไทล์ที่ 95 เพิ่มขึ้นมากกว่า 500 มิลลิวินาที หรือหากอัตราส่วนข้อผิดพลาดเกิน 1% นานกว่า 1 ชั่วโมงในขั้นตอนใดก็ตาม ให้ใช้การกำหนดค่าแบบไดนามิกเพื่อย้อนกลับไปยังขั้นตอนก่อนหน้าทันที
- ย้อนกลับไปยังขั้นตอนก่อนหน้าต่อไปจนกว่าเวลาในการตอบสนองและอัตราส่วนข้อผิดพลาดจะกลับสู่ระดับปกติ
กรณีที่ควรติดต่อ FCM
ติดต่อ FCM ผ่านทีมสนับสนุนของ Firebase หากมีกรณีต่อไปนี้
- โควต้าเริ่มต้นไม่ตรงกับกรณีการใช้งานของคุณอีกต่อไป
- คุณกำลังเปลี่ยนรูปแบบการส่งภายในกรอบเวลา 3 เดือนที่ระดับ 100,000 RPS ทั่วโลกหรือ 30,000 RPS ทั่วทวีป