

इस पेज पर, क्वेरी की परफ़ॉर्मेंस का पता लगाने और उसका विश्लेषण करने के लिए, क्वेरी की अहम जानकारी वाले डैशबोर्ड को इस्तेमाल करने का तरीका बताया गया है.
क्वेरी इनसाइट की खास जानकारी
मेट्रिक से जुड़ी क्वेरी को मॉनिटर करने के लिए, क्वेरी इनसाइट डैशबोर्ड का इस्तेमाल करें. मेट्रिक के आधार पर, सबसे ज़्यादा इस्तेमाल की जाने वाली क्वेरी और ज़्यादा इंतज़ार के समय वाली क्वेरी की पहचान की जा सकती है. इन क्वेरी को ऑप्टिमाइज़ करने की ज़रूरत पड़ सकती है. क्वेरी इनसाइट डैशबोर्ड का इस्तेमाल करके, ये काम किए जा सकते हैं:
- क्वेरी की परफ़ॉर्मेंस को ऑप्टिमाइज़ करना: ज़्यादा इंतज़ार के समय वाली और ऑप्टिमाइज़ेशन की ज़रूरत वाली क्वेरी की पहचान करें.
- क्वेरी की लागत को मैनेज करना: ज़्यादा लागत वाली क्वेरी का पता लगाएं और लागत कम करने के लिए उन्हें ऑप्टिमाइज़ करें.
- क्वेरी के आंकड़ों की निगरानी करना: समय के साथ क्वेरी के आंकड़ों को ट्रैक करें.
- इंडेक्स से जुड़े सुझाव: इस सुविधा की मदद से, ऐसे कंपोज़िट इंडेक्स की पहचान की जा सकती है जो मौजूद नहीं हैं या सही तरीके से काम नहीं कर रहे हैं. साथ ही, सीधे डैशबोर्ड से सुझाए गए इंडेक्स बनाए जा सकते हैं. यह सुविधा, Enterprise वर्शन में उपलब्ध है.
क्वेरी इनसाइट का डेटा
क्वेरी इनसाइट में, इन एपीआई तरीकों का डेटा शामिल होता है:
findaggregate
किसी प्रोजेक्ट, डेटाबेस, और 10 मिनट से लेकर 30 दिनों तक की समयावधि के लिए, इन तरीकों का इस्तेमाल करने वाली क्वेरी का डेटा देखा जा सकता है. एक जैसे स्ट्रक्चर वाली क्वेरी का डेटा, एक ही नॉर्मलाइज़्ड क्वेरी के तहत कैप्चर किया जाता है.
क्वेरी इनसाइट, किसी क्वेरी के बारे में यह जानकारी दिखाती है:
| नॉर्मलाइज़ किया गया क्वेरी टेक्स्ट | टेक्स्ट में दिखाया गया क्वेरी स्ट्रक्चर. |
| एक्ज़ीक्यूशन की संख्या | चुनी गई समयावधि में, ट्रिगर किए गए इवेंट की संख्या. |
| गड़बड़ी की संख्या | चुनी गई समयावधि में हुई गड़बड़ियों की संख्या. |
| एक्ज़ीक्यूशन में लगने वाला औसत समय (मिलीसेकंड) | क्वेरी को प्रोसेस करने में, डेटाबेस को मिलीसेकंड में लगा औसत समय. |
| नतीजों की औसत संख्या | क्वेरी से मिले नतीजों की संख्या. नतीजों में दस्तावेज़, कलेक्शन आईडी, और एग्रीगेट की गई बकेट शामिल होती हैं. |
| स्कैन किए गए दस्तावेज़ों की औसत संख्या | किसी क्वेरी में स्कैन किए गए दस्तावेज़ों की संख्या. |
| स्कैन किए गए इंडेक्स के रिकॉर्ड की औसत संख्या | क्वेरी को लागू करने के लिए, इंडेक्स की जांच की गई एंट्री की संख्या. |
| औसत समय के हिसाब से लोड करें | औसत इंतज़ार के समय के आधार पर, सबसे ज़्यादा इस्तेमाल की गई क्वेरी को फ़िल्टर करने में मदद करने वाला डेटा. |
| रीड ऑपरेशन की कुल संख्या (बिल करने लायक) के हिसाब से लोड करना | बिल किए जा सकने वाले कुल रीड ऑपरेशन के आधार पर, टॉप क्वेरी को फ़िल्टर करने में मदद करने वाला डेटा. |
| सुझावों को इंडेक्स करना | Enterprise वर्शन के डेटाबेस में मौजूद क्वेरी के लिए, सुझाए गए कंपोज़िट इंडेक्स, इस्तेमाल किए गए इंडेक्स, और वर्कलोड पर पड़ने वाले अनुमानित असर की जानकारी. |
डेटा की बारीकी और रखरखाव
डेटा की जानकारी का लेवल, चुनी गई अवधि के हिसाब से तय होता है:
- चार दिन पहले तक के इंटरवल के लिए, 10 मिनट की ग्रैन्युलैरिटी
- पिछले 30 दिनों के इंटरवल के लिए, एक घंटे की ग्रैन्युलैरिटी
क्वेरी इनसाइट के लिए, डेटा का रखरखाव ज़्यादा से ज़्यादा 30 दिनों तक किया जा सकता है. हर 10 मिनट का डेटा, चार दिनों के लिए सेव किया जाता है. वहीं, हर घंटे का डेटा, 30 दिनों के लिए सेव किया जाता है.
क्वेरी की अहम जानकारी देखना
Firebase कंसोल
- Cloud Firestore डेटाबेस के लिए क्वेरी की अहम जानकारी देखने के लिए, Google Cloud Console में डेटाबेस का क्वेरी की अहम जानकारी पैनल खोलें.
Firebase कंसोल में, Firestore Database पेज पर जाएं.
- डेटाबेस की सूची में से कोई डेटाबेस चुनें.
- टैब की सूची में जाकर, क्वेरी इनसाइट पर क्लिक करें.
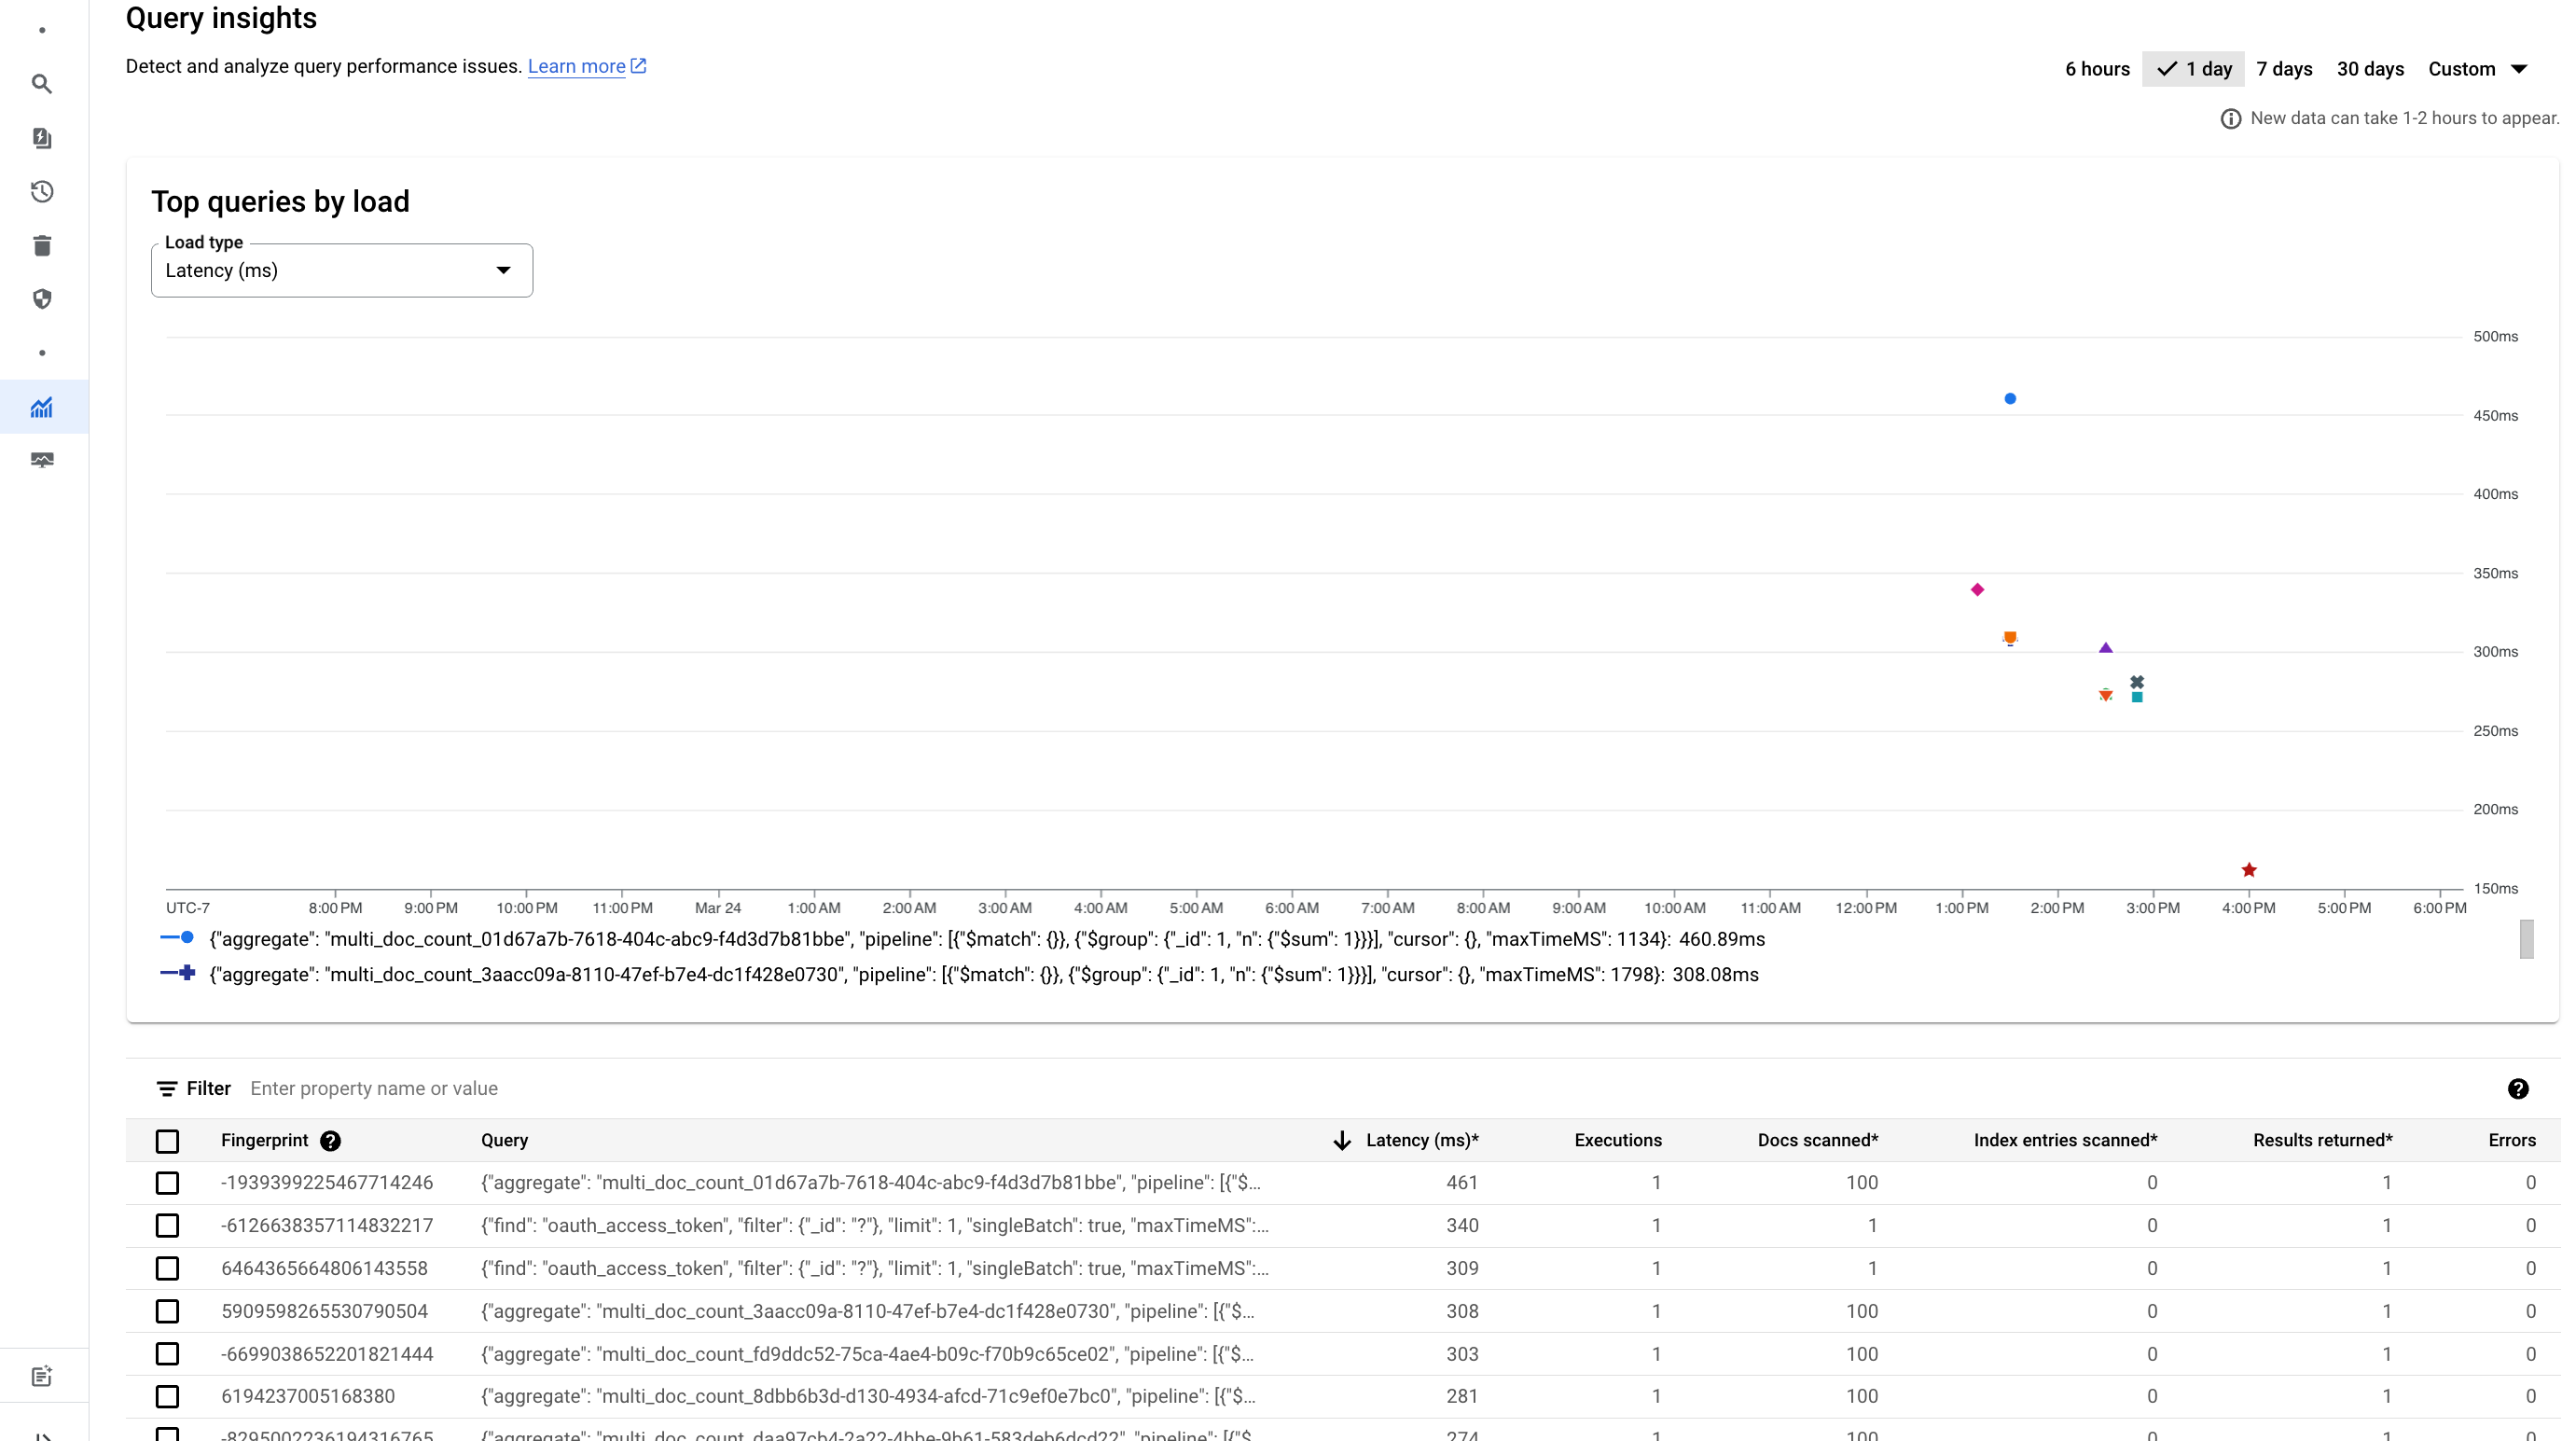
लेटेंसी या रीड ऑपरेशन की संख्या के आधार पर टॉप क्वेरी देखने के लिए, लेटेंसी या रीड ऑपरेशन पर क्लिक करें.
सुझावों को इंडेक्स करना
क्वेरी की अहम जानकारी के लिए इंडेक्स के सुझाव, Firestore Enterprise वर्शन के डेटाबेस में बार-बार इस्तेमाल होने वाली क्वेरी के लिए, मौजूद न होने वाले या खराब कंपोज़िट इंडेक्स कॉन्फ़िगरेशन की पहचान अपने-आप करते हैं.
Firestore Enterprise वर्शन में, क्वेरी को कंपोज़िट इंडेक्स मैच किए बिना भी चलाया जा सकता है. इससे, पूरे कलेक्शन को स्कैन करने या मेमोरी में मौजूद डेटा को क्रम से लगाने की प्रोसेस धीमी हो सकती है. क्वेरी इनसाइट डैशबोर्ड, क्वेरी के लागू होने के पुराने आंकड़ों का विश्लेषण करता है. साथ ही, क्वेरी के इंतज़ार के समय को ऑप्टिमाइज़ करने और स्कैन किए गए बिल किए जा सकने वाले दस्तावेज़ों की संख्या को कम करने के लिए, टारगेट किए गए कंपोज़िट इंडेक्स का सुझाव देता है.
इंडेक्स के सुझाव कैसे काम करते हैं
ऑफ़लाइन बैच पाइपलाइन, समय-समय पर पुरानी टॉप क्वेरी का आकलन करती है:
- क्वेरी के स्ट्रक्चर का विश्लेषण: बार-बार इस्तेमाल की जाने वाली क्वेरी से, समानता, क्रम से लगाने, और रेंज के प्रेडिकेट को अलग करता है.
- संभावित इंडेक्स जनरेट करना: इंडेक्स के क्रम को तय करने के लिए, अनुमानित तरीकों (बराबर > क्रम से लगाएं > रेंज) का इस्तेमाल करके, संभावित कंपोज़िट इंडेक्स की परिभाषाएं जनरेट करता है.
- ऑप्टिमाइज़र का आकलन: यह क्वेरी इंजन के लागत मॉडल में, इंडेक्स किए जाने वाले संभावित कॉलम को शामिल करता है. इससे, क्वेरी को लागू करने की बेसलाइन लागत की तुलना, इंडेक्स किए गए काल्पनिक प्लान से की जाती है.
- वर्कलोड पर पड़ने वाले असर की रैंकिंग: यह सुविधा, सुझाए गए इंडेक्स को असर के हिसाब से अलग-अलग टियर में बांटती है. इसके लिए, वर्कलोड की कुल अनुमानित लागत में होने वाली बचत को आधार बनाया जाता है:
- HIGH: यह पूरे कलेक्शन को स्कैन करने के बजाय, चुनिंदा इंडेक्स को स्कैन करता है. इससे दस्तावेज़ों को पढ़ने और उन्हें लागू करने में लगने वाला समय काफ़ी कम हो जाता है.
- MEDIUM: यह इंडेक्स के नतीजों को पहले से क्रम में लगाकर देता है. इससे, इन-मेमोरी सॉर्टिंग जैसी महंगी कार्रवाइयों से बचा जा सकता है.
- कम: इससे वीडियो को आगे-पीछे करने की सुविधा में मामूली सुधार होता है.
सुझाए गए इंडेक्स देखना और बनाना
इंडेक्स के सुझाव देखने और सुझाए गए इंडेक्स बनाने के लिए, Firebase कंसोल में जाकर:Firebase कंसोल में, Firestore Database पेज पर जाएं.
डेटाबेस की सूची में से, Enterprise वर्शन वाला डेटाबेस चुनें.
क्वेरी इनसाइट टैब पर क्लिक करें.
क्वेरी टेबल में, सुझावों वाली क्वेरी का आकार ढूंढें. इसके बाद, पंक्ति या पॉपओवर में मौजूद सुझावों की समीक्षा करें पर क्लिक करें.
इंडेक्स के सुझाव वाले डायलॉग बॉक्स में, कंपोज़िट इंडेक्स की परिभाषा, फ़ील्ड के क्रम, और वर्कलोड पर पड़ने वाले असर के अनुमानित टियर (ज़्यादा, सामान्य या कम) की समीक्षा करें.
सेव करें पर क्लिक करें. इंडेक्स बनाने की प्रोसेस को ट्रैक करने के लिए, ज़्यादा समय तक चलने वाली कार्रवाई (एलआरओ) पैनल खुलता है.
इंडेक्स बनने के बाद, उसे इंडेक्स टैब में लिस्ट किया जाता है. साथ ही, क्वेरी वाली लाइन से सुझाव का इंडिकेटर हट जाता है.
इन वर्शन में उपलब्ध है
इंडेक्स के सुझाव, सिर्फ़ Firestore Enterprise वर्शन के डेटाबेस के लिए उपलब्ध हैं. स्टैंडर्ड वर्शन वाले डेटाबेस का इस्तेमाल नहीं किया जा सकता.
सीमाएं
- क्वेरी इनसाइट का डेटा एक से दो घंटे की देरी से मिलता है.
- इंडेक्स के सुझाव, क्वेरी के पुराने डेटा के आधार पर समय-समय पर जनरेट किए जाते हैं, न कि रीयल टाइम में.
- इंडेक्स के सुझावों में, नए कंपोज़िट इंडेक्स के सुझाव दिए जाते हैं. इनमें मौजूदा इंडेक्स में बदलाव करने या उन्हें मिटाने के सुझाव नहीं दिए जाते.
- इंडेक्स अपने-आप बनने की सुविधा उपलब्ध नहीं है. सुझाए गए इंडेक्स मैन्युअल तरीके से बनाए जाने चाहिए.
- क्वेरी नॉर्मलाइज़ेशन, लिटरल वैल्यू को प्लेसहोल्डर से बदल देता है. इंडेक्स के सुझाव, रनटाइम की खास वैल्यू के बजाय, सामान्य क्वेरी टेंप्लेट पर आधारित होते हैं.
- लागत का आकलन करने के लिए, लाइव डेटा सैंपलिंग के बजाय ह्यूरिस्टिक का इस्तेमाल किया जाता है. ऐसा हो सकता है कि सुझाए गए इंडेक्स से हर स्थिति में परफ़ॉर्मेंस बेहतर न हो. साथ ही, इंडेक्स बनाने से डेटा लिखने और स्टोरेज का खर्च बढ़ जाता है.
कीमत
क्वेरी इनसाइट या इंडेक्स के सुझावों के लिए, कोई अतिरिक्त शुल्क नहीं लिया जाता.
ज़रूरी भूमिकाएं
क्वेरी इनसाइट डैशबोर्ड देखने और सुझाए गए इंडेक्स बनाने के लिए, आपके पास ज़रूरी अनुमतियां होनी चाहिए. इसके लिए, अपने एडमिन से कहें कि वह आपको अपने प्रोजेक्ट पर ये आईएएम भूमिकाएं दे:
- क्वेरी इनसाइट देखने के लिए:
डेटास्टोर व्यूअर
(
roles/datastore.viewer) - सुझाए गए इंडेक्स बनाने के लिए:
डेटास्टोर इंडेक्स एडमिन
(
roles/datastore.indexAdmin) या Cloud Datastore का मालिक (roles/datastore.owner)
पहले से तय की गई इन भूमिकाओं में, datastore.insights.get और datastore.indexes.create अनुमतियां शामिल होती हैं.
आपको कस्टम रोल या पहले से तय अन्य भूमिकाओं के ज़रिए भी ये अनुमतियां मिल सकती हैं.