

উচ্চ পারফর্ম্যান্স ও নির্ভরযোগ্যতার জন্য আপনার অ্যাপ্লিকেশনের আর্কিটেকচার তৈরি করার বিষয়ে সঠিক সিদ্ধান্ত নিতে এই ডকুমেন্ট পড়ুন। এই ডকুমেন্টে উন্নত Cloud Firestoreটি বিষয় অন্তর্ভুক্ত আছে। আপনি যদি সবেমাত্র Cloud Firestore ব্যবহার করা শুরু করে থাকেন, তাহলে পরিবর্তে কুইকস্টার্ট গাইড দেখুন।
Cloud Firestore হল Firebase ও Google Cloud থেকে মোবাইল ডিভাইস, ওয়েব ও সার্ভার ডেভেলপমেন্টের জন্য একটি ফ্লেক্সিবল, স্কেলেবল ডেটাবেস। Cloud Firestore-এর মাধ্যমে শুরু করা এবং সমৃদ্ধ ও শক্তিশালী অ্যাপ্লিকেশন লেখা খুবই সহজ।
আপনার ডেটাবেসের সাইজ এবং ট্রাফিক বাড়ার সাথে সাথে আপনার অ্যাপ্লিকেশনগুলি যাতে ভাল পারফর্ম করা চালিয়ে যায় তা নিশ্চিত করতে, Cloud Firestore ব্যাকএন্ডে রিড এবং রাইটের মেকানিক্স বুঝতে সাহায্য করে। এছাড়াও, স্টোরেজ লেয়ারের সাথে আপনার রিড ও রাইট ইন্টার্যাকশন এবং পারফর্ম্যান্সকে প্রভাবিত করতে পারে এমন অন্তর্নিহিত সীমাবদ্ধতা সম্পর্কে আপনাকে বুঝতে হবে।
আপনার অ্যাপ্লিকেশন আর্কিটেক্ট করার আগে পেশাদার পদ্ধতির জন্য নিম্নলিখিত বিভাগগুলি দেখুন।
হাই-লেভেল কম্পোনেন্ট সম্পর্কে বোঝা
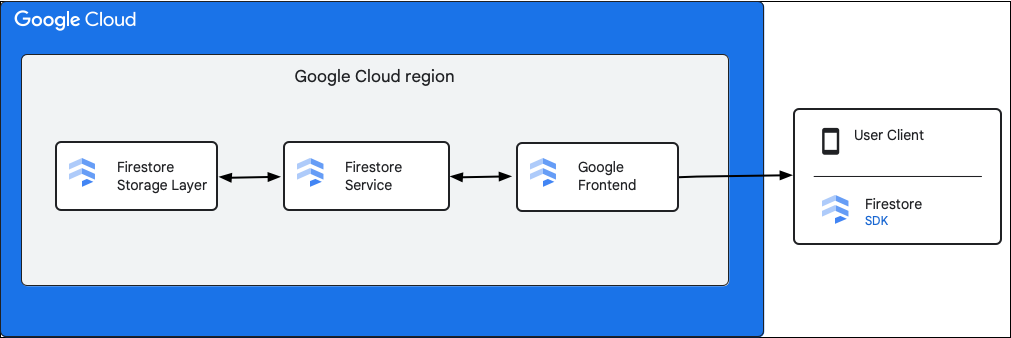
নিম্নলিখিত ডায়াগ্রামটি Cloud Firestore API অনুরোধে জড়িত উচ্চ স্তরের উপাদানগুলি দেখায়।
Cloud Firestore SDK এবং ক্লায়েন্ট লাইব্রেরি
Cloud Firestore বিভিন্ন প্ল্যাটফর্মের জন্য SDK ও ক্লায়েন্ট লাইব্রেরি সাপোর্ট করে। কোনও অ্যাপ সরাসরি HTTP এবং RPC কল Cloud Firestore API-তে করতে পারলেও, ক্লায়েন্ট লাইব্রেরি API-এর ব্যবহার সহজ করতে এবং পেশাদার পদ্ধতি প্রয়োগ করতে অ্যাবস্ট্রাকশনের একটি লেয়ার প্রদান করে। এছাড়াও, তারা অফলাইন অ্যাক্সেস, ক্যাশে ও আরও অনেক কিছুর মতো অতিরিক্ত ফিচার প্রদান করতে পারে।
Google Front End (GFE)
এটি একটি পরিকাঠামোগত পরিষেবা যা সমস্ত Google Cloud পরিষেবার জন্য সাধারণ। GFE ইনকামিং অনুরোধ গ্রহণ করে এবং প্রাসঙ্গিক Google পরিষেবায় (এই প্রসঙ্গে Cloud Firestore পরিষেবা) তা ফরওয়ার্ড করে। এছাড়াও, এটি ডিনায়াল অফ সার্ভিস অ্যাটাকের বিরুদ্ধে সুরক্ষা সহ অন্যান্য গুরুত্বপূর্ণ কার্যকারিতা প্রদান করে।
Cloud Firestoreটি পরিষেবা
Cloud Firestore পরিষেবা API অনুরোধ চেক করে, যার মধ্যে যাচাইকরণ, অনুমোদন, কোটা চেক ও নিরাপত্তা সংক্রান্ত নিয়ম অন্তর্ভুক্ত এবং এটি ট্রানজ্যাকশনও ম্যানেজ করে। এই Cloud Firestore পরিষেবায় একটি স্টোরেজ ক্লায়েন্ট অন্তর্ভুক্ত থাকে যা ডেটা রিড ও রাইট করার জন্য স্টোরেজ লেয়ারের সাথে ইন্টার্যাক্ট করে।
Cloud Firestore স্টোরেজ লেয়ার
Cloud Firestore স্টোরেজ লেয়ার ডেটা ও মেটাডেটা এবং Cloud Firestore-এর মাধ্যমে প্রদান করা সংশ্লিষ্ট ডেটাবেস ফিচার স্টোর করার জন্য দায়ী। নিম্নলিখিত বিভাগগুলি বর্ণনা করে যে কীভাবে ডেটা Cloud Firestore স্টোরেজ লেয়ারে সাজানো হয় এবং সিস্টেম কীভাবে স্কেল করে। ডেটা কীভাবে সাজানো হয় তা জানলে আপনি স্কেলেবেল ডেটা মডেল ডিজাইন করতে পারবেন এবং Cloud Firestore-এর পেশাদার পদ্ধতি আরও ভালোভাবে বুঝতে পারবেন।
মূল রেঞ্জ ও স্প্লিট
Cloud Firestore হল NoSQL, ডকুমেন্ট-ওরিয়েন্টেড ডেটাবেস। আপনি ডকুমেন্টে ডেটা স্টোর করেন, যা কালেকশনের হায়ারার্কিতে সাজানো থাকে। প্রতিটি ডকুমেন্টের জন্য কালেকশন হায়ারার্কি এবং ডকুমেন্ট আইডি একটি একক কীতে অনুবাদ করা হয়। ডকুমেন্টগুলি লজিক্যালি স্টোর করা হয় এবং এই একক কী দ্বারা লেক্সিকোগ্রাফিকভাবে অর্ডার করা হয়। আমরা 'কী রেঞ্জ' শব্দটি ব্যবহার করে অভিধানের ক্রম অনুযায়ী 'কী'-এর রেঞ্জকে বোঝাই।
একটি সাধারণ Cloud Firestore ডেটাবেস একটি ফিজিক্যাল মেশিনে ফিট করার পক্ষে অনেক বড়। এমন পরিস্থিতিও হতে পারে যেখানে ডেটার উপর কাজের চাপ এতটাই বেশি যে একটি মেশিন তা সামলাতে পারে না। বিশাল পরিমাণ ওয়ার্কলোড ম্যানেজ করতে, Cloud Firestore ডেটাকে আলাদা আলাদা অংশে ভাগ করে দেয় যা একাধিক মেশিন বা স্টোরেজ সার্ভারে স্টোর করা ও সেখান থেকে পরিবেশন করা যায়। এইসব পার্টিশন ডেটাবেস টেবিলে কী রেঞ্জের ব্লকে তৈরি করা হয়, যাকে স্প্লিট বলা হয়।
সিঙ্ক্রোনাস রেপ্লিকেশন
এটি মনে রাখা গুরুত্বপূর্ণ যে ডেটাবেস সবসময় অটোমেটিক ও সিঙ্ক্রোনাসভাবে রেপ্লিকেট করা হয়। ডেটার স্প্লিটের রেপ্লিকা বিভিন্ন জোনে থাকে যাতে কোনও জোন অ্যাক্সেস করা না গেলেও ডেটা উপলভ্য থাকে। স্প্লিটের বিভিন্ন কপিতে একই ধরনের রেপ্লিকেশন Paxos অ্যালগরিদম দ্বারা ম্যানেজ করা হয়। প্রতিটি স্প্লিটের একটি রেপ্লিকা Paxos লিডার হিসেবে কাজ করার জন্য নির্বাচিত হয়, যা সেই স্প্লিটে লেখার কাজ পরিচালনা করার জন্য দায়ী। সিঙ্ক্রোনাস রেপ্লিকেশন আপনাকে Cloud Firestore থেকে ডেটার লেটেস্ট ভার্সন সবসময় পড়ার সুবিধা দেয়।
এর সামগ্রিক ফলাফল হল একটি স্কেলেবল এবং অত্যন্ত সহজলভ্য সিস্টেম যা রিড এবং রাইট উভয়ের জন্যই কম লেটেন্সি প্রদান করে, তা সে ভারী ওয়ার্কলোড এবং খুব বড় স্কেলে যাই হোক না কেন।
ডেটা লেআউট
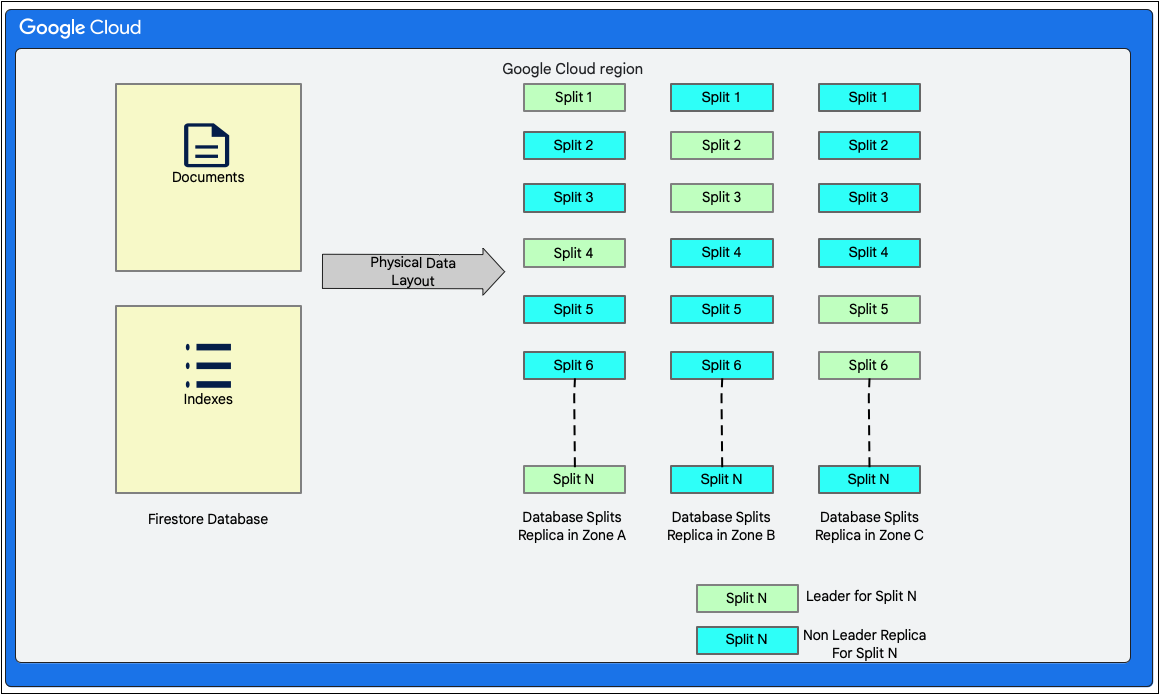
Cloud Firestore হল স্কিমাহীন ডকুমেন্ট ডেটাবেস। তবে, ইন্টার্নালি এটি স্টোরেজ লেয়ারে মূলত দুটি রিলেশনাল ডেটাবেস-স্টাইল টেবিলে ডেটা সাজায়, যা নিচে উল্লেখ করা হল:
- Documents টেবিল: এই টেবিলে ডকুমেন্ট স্টোর করা হয়।
- ইনডেক্স টেবিল: ইনডেক্স এন্ট্রি যা দক্ষতার সাথে ফলাফল পেতে এবং ইনডেক্স মান অনুসারে সাজানো সম্ভব করে তোলে তা এই টেবিলে স্টোর করা হয়।
নিচের ডায়াগ্রাম থেকে বোঝা যাবে যে স্প্লিট করার পরে Cloud Firestore ডেটাবেসের টেবিলগুলি কেমন দেখতে হতে পারে। স্প্লিটগুলি তিনটি ভিন্ন জোনে রেপ্লিকেট করা হয় এবং প্রতিটি স্প্লিটের একটি করে Paxos লিডার থাকে।
সিঙ্গেল-রিজিয়ন বনাম মাল্টি-রিজিয়ন
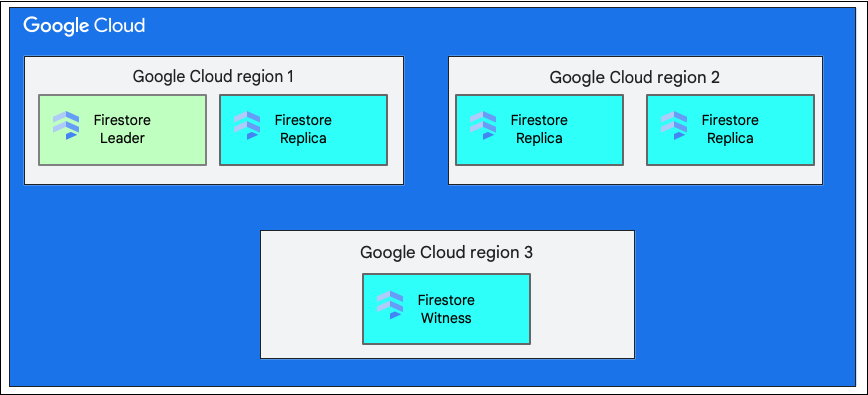
আপনি ডেটাবেস তৈরি করার সময়, আপনাকে অবশ্যই একটি অঞ্চল বা মাল্টি-রিজিয়ন বেছে নিতে হবে।
একটি আঞ্চলিক লোকেশন হল একটি নির্দিষ্ট ভৌগোলিক লোকেশন, যেমন us-west1। আগে যেমন ব্যাখ্যা করা হয়েছে, Cloud Firestore ডেটাবেসের ডেটার স্প্লিটের রেপ্লিকা বেছে নেওয়া অঞ্চলের মধ্যে বিভিন্ন জোনে থাকে।
মাল্টি-রিজিয়ন লোকেশনে নির্দিষ্ট কিছু অঞ্চল থাকে যেখানে ডেটাবেসের রেপ্লিকা স্টোর করা হয়। Cloud Firestore-এর মাল্টি-রিজিয়ন ডেপ্লয়মেন্টে, দুটি রিজিয়নে ডেটাবেসের সম্পূর্ণ ডেটার সম্পূর্ণ রেপ্লিকা আছে। তৃতীয় অঞ্চলে একটি উইটনেস রেপ্লিকা থাকে যা ডেটার সম্পূর্ণ সেট বজায় রাখে না, তবে রেপ্লিকেশনে অংশগ্রহণ করে। একাধিক অঞ্চলের মধ্যে ডেটা রেপ্লিকেট করার মাধ্যমে, কোনও একটি অঞ্চল সম্পূর্ণভাবে হারিয়ে গেলেও ডেটা লেখা ও পড়ার জন্য উপলভ্য থাকে।
কোনও অঞ্চলের লোকেশন সম্পর্কে আরও তথ্যের জন্য, Cloud Firestore লোকেশন দেখুন।
Cloud Firestore-এ লেখার আয়ু সম্পর্কে বোঝা
Cloud Firestore ক্লায়েন্ট একটি ডকুমেন্ট তৈরি, আপডেট বা মুছে ফেলার মাধ্যমে ডেটা লিখতে পারে। একটি ডকুমেন্টে লেখার জন্য স্টোরেজ লেয়ারে ডকুমেন্ট এবং এর সাথে যুক্ত ইন্ডেক্স এন্ট্রি উভয়ই অ্যাটমিক্যালি আপডেট করতে হবে। এছাড়াও, Cloud Firestore-এ অ্যাটমিক অপারেশন করা যায়, যার মধ্যে এক বা একাধিক ডকুমেন্ট একাধিকবার পড়া এবং/অথবা লেখা অন্তর্ভুক্ত।
সব ধরনের রাইটের জন্য, Cloud Firestore রিলেশনাল ডেটাবেসের ACID প্রপার্টি (অ্যাটোমিসিটি, কনসিস্টেন্সি, আইসোলেশন ও ডিউরেবিলিটি) প্রদান করে। Cloud Firestore-এ সিরিয়ালাইজেবিলিটি-এর সুবিধাও আছে, যার অর্থ হল সব ট্রানজ্যাকশন এমনভাবে দেখানো হয় যেন সেগুলি সিরিয়াল অর্ডারে এক্সিকিউট করা হয়েছে।
রাইট ট্রানজ্যাকশনের ক্ষেত্রে হাই-লেভেল ধাপ
Cloud Firestore ক্লায়েন্ট যখন আগে উল্লেখ করা কোনও পদ্ধতি ব্যবহার করে ট্রানজ্যাকশন লেখে বা কমিট করে, তখন ইন্টার্নালি এটি স্টোরেজ লেয়ারে ডেটাবেস রিড-রাইট ট্রানজ্যাকশন হিসেবে এক্সিকিউট করা হয়। ট্রানজ্যাকশন Cloud Firestore-কে আগে উল্লেখ করা ACID প্রপার্টি প্রদান করতে দেয়।
ট্রানজ্যাকশনের প্রথম ধাপ হিসেবে, Cloud Firestore আগে থেকে থাকা ডকুমেন্ট পড়ে এবং ডকুমেন্টের টেবিলে ডেটায় কী কী পরিবর্তন করতে হবে তা নির্ধারণ করে।
এছাড়াও, এর মধ্যে নিম্নলিখিতভাবে ইন্ডেক্স টেবিলে প্রয়োজনীয় আপডেট করা অন্তর্ভুক্ত:
- ডকুমেন্টে যোগ করা হচ্ছে এমন ফিল্ডের জন্য ইন্ডেক্স টেবিলে সংশ্লিষ্ট ইনসার্ট থাকতে হবে।
- ডকুমেন্ট থেকে যেসব ফিল্ড সরানো হচ্ছে, ইন্ডেক্স টেবিল থেকে সেগুলি মুছে ফেলতে হবে।
- ডকুমেন্টে যেসব ফিল্ড পরিবর্তন করা হচ্ছে, সেগুলির জন্য ইনডেক্স টেবিলে মুছে ফেলা (পুরনো ভ্যালুর জন্য) এবং যোগ করা (নতুন ভ্যালুর জন্য) উভয়ই করতে হবে।
আগে উল্লেখ করা মিউটেশন গণনা করতে, Cloud Firestore ডেটাবেসের জন্য ইনডেক্সিং কনফিগারেশন পড়ে। ইনডেক্সিং কনফিগারেশন ডেটাবেসের ইনডেক্স সংক্রান্ত তথ্য স্টোর করে। Cloud Firestore দুই ধরনের ইন্ডেক্স ব্যবহার করে: সিঙ্গল-ফিল্ড ও কম্পোজিট। Cloud Firestore-এ তৈরি করা ইন্ডেক্স সম্পর্কে বিস্তারিত জানতে, Cloud Firestore-এ ইন্ডেক্সের ধরন দেখুন।
মিউটেশন গণনা করা হয়ে গেলে, Cloud Firestore ট্রানজ্যাকশনের মধ্যে সেগুলি সংগ্রহ করে এবং তারপর তা কমিট করে।
স্টোরেজ লেয়ারে একটি রাইট ট্রানজ্যাকশন বুঝুন
আগে যেমন আলোচনা করা হয়েছে, Cloud Firestore-এ রাইট করার অর্থ হল স্টোরেজ লেয়ারে রিড-রাইট ট্রানজ্যাকশন। ডেটার লেআউটের উপর নির্ভর করে, ডেটা লেআউটে যেমন দেখা যায়, লেখার মধ্যে এক বা একাধিক স্প্লিট থাকতে পারে।
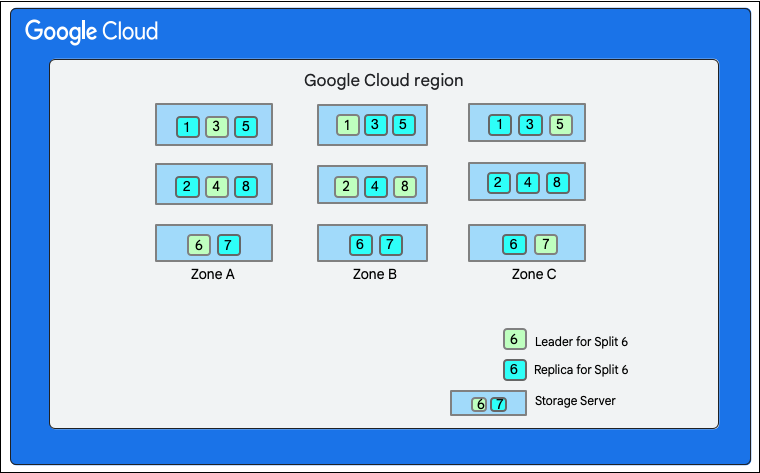
নিচের ডায়াগ্রামে, Cloud Firestore ডেটাবেসের আটটি স্প্লিট (১-৮ হিসেবে চিহ্নিত) আছে যা একটি জোনে তিনটি আলাদা স্টোরেজ সার্ভারে হোস্ট করা আছে এবং প্রতিটি স্প্লিট ৩টি(বা তার বেশি) আলাদা জোনে রেপ্লিকেট করা আছে। প্রতিটি স্প্লিটের একজন করে প্যাক্সোস লিডার থাকেন, যিনি বিভিন্ন স্প্লিটের জন্য বিভিন্ন জোনে থাকতে পারেন।
 Cloud Firestore ডেটাবেস স্প্লিট">
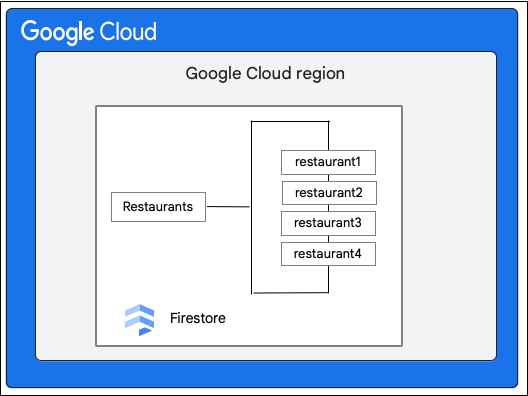
Cloud Firestore ডেটাবেস বিবেচনা করুন যাতে নিম্নলিখিত Restaurants সংগ্রহ আছে:
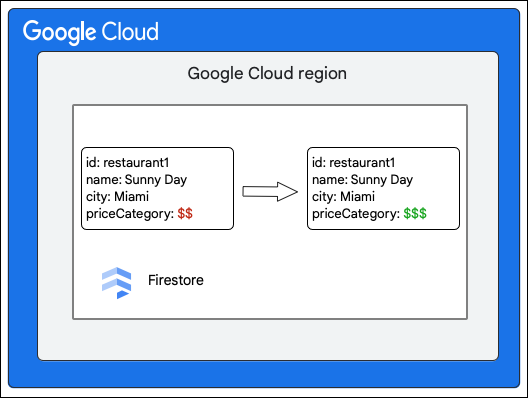
Cloud Firestore ক্লায়েন্ট Restaurant সংগ্রহে থাকা কোনও ডকুমেন্টে priceCategory ফিল্ডের ভ্যালু আপডেট করে নিম্নলিখিত পরিবর্তন করার অনুরোধ করে।
নিম্নলিখিত হাই-লেভেল ধাপগুলি বর্ণনা করে যে লেখার অংশ হিসেবে কী ঘটে:
- রিড-রাইট ট্রানজ্যাকশন তৈরি করুন।
- স্টোরেজ লেয়ার থেকে Documents টেবিল থেকে
Restaurantsসংগ্রহেrestaurant1ডকুমেন্ট পড়ুন। - ইনডেক্স টেবিল থেকে ডকুমেন্টের ইনডেক্স পড়ুন।
- ডেটাতে করা মিউটেশন গণনা করুন। এই ক্ষেত্রে, পাঁচটি মিউটেশন আছে:
- M1:
priceCategoryফিল্ডের ভ্যালুতে পরিবর্তন দেখাতে ডকুমেন্ট টেবিলেরrestaurant1-এর জন্য সারি আপডেট করুন। - M2 এবং M3: নিম্নক্রম ও ঊর্ধ্বক্রম ইন্ডেক্সের জন্য ইন্ডেক্স সারণিতে
priceCategory-এর পুরনো ভ্যালুর জন্য সারিগুলি মুছে দিন। - M4 এবং M5: নিম্নক্রম এবং ঊর্ধ্বক্রম সূচকের জন্য সূচক টেবিলে
priceCategory-এর নতুন মানের জন্য সারিগুলি সন্নিবেশ করুন।
- M1:
- এইসব মিউটেশন কমিট করুন।
Cloud Firestore পরিষেবার স্টোরেজ ক্লায়েন্ট সেইসব স্প্লিট খোঁজে যেগুলি পরিবর্তন করতে হবে এমন সারির 'কী'র মালিক। ধরা যাক, স্প্লিট ৩-এ M1 এবং স্প্লিট ৬-এ M2-M5 দেখানো হয়। একটি ডিস্ট্রিবিউটেড ট্রানজ্যাকশন আছে, যাতে অংশগ্রহণকারী হিসেবে এইসব স্প্লিট অন্তর্ভুক্ত আছে। পার্টিসিপেন্ট স্প্লিটে অন্য কোনও স্প্লিটও অন্তর্ভুক্ত থাকতে পারে যেখান থেকে রিড-রাইট ট্রানজ্যাকশনের অংশ হিসেবে আগে ডেটা রিড করা হয়েছিল।
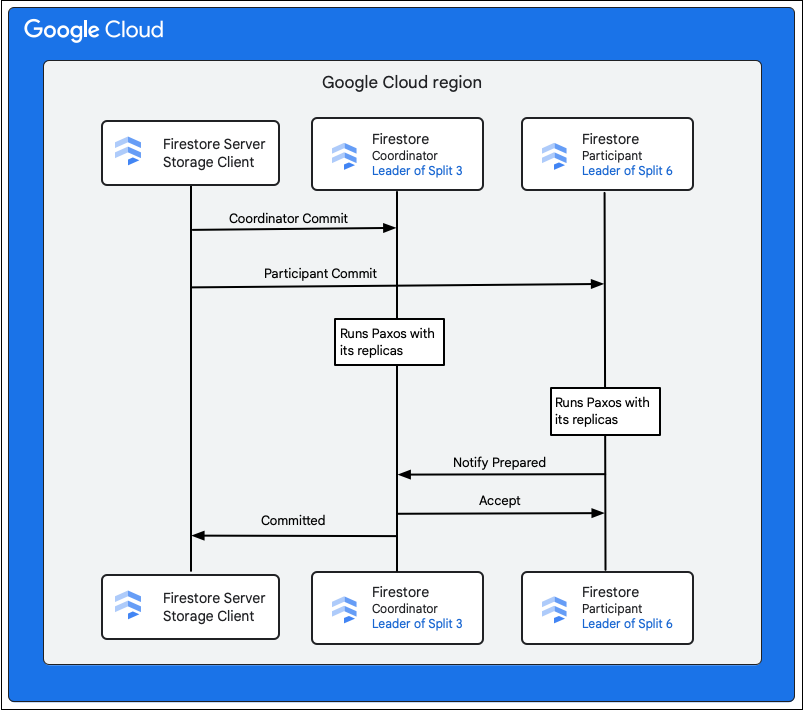
কমিটের অংশ হিসেবে কী হয় তা নিম্নলিখিত ধাপগুলিতে বর্ণনা করা হয়েছে:
- স্টোরেজ ক্লায়েন্ট একটি কমিট ইস্যু করে। কমিটে M1-M5 মিউটেশন রয়েছে।
- এই ট্রানজ্যাকশনে স্প্লিট ৩ ও ৬ অংশগ্রহণকারী। অংশগ্রহণকারীদের মধ্যে একজনকে সমন্বয়কারী হিসেবে বেছে নেওয়া হয়, যেমন Split 3। কোঅর্ডিনেটরের কাজ হল, সব অংশগ্রহণকারীর মধ্যে ট্রানজ্যাকশনটি সম্পূর্ণ বা বাতিল করা হয়েছে কিনা তা নিশ্চিত করা।
- এইসব স্প্লিটের লিডার রেপ্লিকা, অংশগ্রহণকারী ও কোঅর্ডিনেটরের করা কাজের জন্য দায়ী।
- প্রত্যেক অংশগ্রহণকারী এবং কোঅর্ডিনেটর তাদের নিজ নিজ রেপ্লিকার সাথে একটি প্যাক্সোস অ্যালগরিদম রান করে।
- লিডার রেপ্লিকার সাথে প্যাক্সোস অ্যালগরিদম রান করে। বেশিরভাগ রেপ্লিকা লিডারকে
ok to commitউত্তর দিলে কোরাম সম্পূর্ণ হয়। - প্রত্যেক অংশগ্রহণকারী প্রস্তুত (টু-ফেজ কমিটের প্রথম ফেজ) হলে কোঅর্ডিনেটরকে জানান। কোনও অংশগ্রহণকারী ট্রানজ্যাকশন সম্পূর্ণ করতে না পারলে, পুরো ট্রানজ্যাকশন
aborts।
- লিডার রেপ্লিকার সাথে প্যাক্সোস অ্যালগরিদম রান করে। বেশিরভাগ রেপ্লিকা লিডারকে
- কোঅর্ডিনেটর যখন জানতে পারে যে সে নিজে সহ সব অংশগ্রহণকারী প্রস্তুত, তখন সে সব অংশগ্রহণকারীকে
acceptট্রানজ্যাকশনের ফলাফল জানায় (দুই-পর্যায়ের কমিটের দ্বিতীয় পর্যায়)। এই পর্যায়ে, প্রতিটি অংশগ্রহণকারী স্টেবল স্টোরেজে কমিট সংক্রান্ত সিদ্ধান্ত রেকর্ড করে এবং ট্রানজ্যাকশন কমিট করা হয়। - ট্রানজ্যাকশন সম্পূর্ণ হয়েছে বলে কোঅর্ডিনেটর Cloud Firestore-এ স্টোরেজ ক্লায়েন্টকে উত্তর দেয়। একই সাথে, কোঅর্ডিনেটর এবং সব অংশগ্রহণকারী ডেটায় মিউটেশন প্রয়োগ করেন।
Cloud Firestore ডেটাবেস ছোট হলে, এমন হতে পারে যে একটি স্প্লিট মিউটেশন M1-M5-এর সব কী-এর মালিক। এই ধরনের ক্ষেত্রে, ট্রানজ্যাকশনে শুধুমাত্র একজন অংশগ্রহণকারী থাকেন এবং আগে উল্লেখ করা দুই-পর্যায়ের কমিটের প্রয়োজন হয় না, যার ফলে লেখার কাজ দ্রুত হয়।
একাধিক-অঞ্চলে রাইট করে
একাধিক অঞ্চলে ডেপ্লয়মেন্টের ক্ষেত্রে, বিভিন্ন অঞ্চল জুড়ে রেপ্লিকা ছড়িয়ে দেওয়ার ফলে উপলভ্যতা বাড়ে, তবে পারফর্ম্যান্সের খরচও বাড়ে। বিভিন্ন অঞ্চলে রেপ্লিকার মধ্যে কমিউনিকেশনের জন্য যাওয়া আসার সময় বেশি লাগে। তাই, Cloud Firestore অপারেশনের জন্য বেসলাইন লেটেন্সি, সিঙ্গেল রিজিয়ন ডেপ্লয়মেন্টের তুলনায় সামান্য বেশি।
আমরা রেপ্লিকা এমনভাবে কনফিগার করি যাতে স্প্লিটের লিডারশিপ সবসময় প্রাইমারি অঞ্চলে থাকে। প্রাথমিক অঞ্চল হল সেই অঞ্চল যেখান থেকে Cloud Firestore সার্ভারে ট্রাফিক আসছে। লিডারশিপের এই সিদ্ধান্ত Cloud Firestore-এ স্টোরেজ ক্লায়েন্ট এবং রেপ্লিকা লিডারের (বা মাল্টি-স্প্লিট ট্রানজ্যাকশনের কোঅর্ডিনেটর) মধ্যে কমিউনিকেশনে রাউন্ড-ট্রিপ বিলম্ব কমায়।
Cloud Firestore-এ প্রতিটি লেখার সাথে Cloud Firestore-এর রিয়েল-টাইম ইঞ্জিনের কিছু ইন্টার্যাকশনও জড়িত থাকে। রিয়েল-টাইম কোয়েরি সম্পর্কে আরও জানতে, স্কেলে রিয়েল-টাইম কোয়েরি বোঝা নিবন্ধটি দেখুন।
Cloud Firestore-এ রিডের লাইফ সম্পর্কে বোঝা
এই বিভাগে Cloud Firestore-এ স্ট্যান্ড-অ্যালোন, রিয়েল-টাইম নয় এমন রিড সম্পর্কে বিস্তারিত আলোচনা করা হয়েছে। অভ্যন্তরীণভাবে, Cloud Firestore সার্ভার দুটি প্রধান ধাপে এইসব কোয়েরির বেশিরভাগই ম্যানেজ করে:
- Indexes টেবিল জুড়ে একটি রেঞ্জ স্ক্যান
- আগের স্ক্যানের ফলাফলের উপর ভিত্তি করে ডকুমেন্ট টেবিলে পয়েন্ট লুকআপ
স্টোরেজ লেয়ার থেকে ডেটা রিড করার কাজটি ইন্টার্নালি ডেটাবেস ট্রানজ্যাকশন ব্যবহার করে করা হয় যাতে রিড করার কাজটি ধারাবাহিকভাবে করা যায়। তবে, লেখার জন্য ব্যবহৃত ট্রানজ্যাকশনের মতো, এই ট্রানজ্যাকশনগুলি লক নেয় না। পরিবর্তে, তারা একটি টাইমস্ট্যাম্প বেছে নিয়ে কাজ করে, তারপর সেই টাইমস্ট্যাম্পে সমস্ত রিড এক্সিকিউট করে। যেহেতু তারা লক অর্জন করে না, তাই তারা সমবর্তী রিড-রাইট ট্রানজ্যাকশন ব্লক করে না। এই ট্রানজ্যাকশনটি কার্যকর করতে, Cloud Firestore-এ স্টোরেজ ক্লায়েন্ট একটি টাইমস্ট্যাম্প বাউন্ড নির্দিষ্ট করে, যা স্টোরেজ লেয়ারকে বলে যে কীভাবে একটি রিড টাইমস্ট্যাম্প বেছে নিতে হয়। Cloud Firestore-এ স্টোরেজ ক্লায়েন্টের বেছে নেওয়া টাইমস্ট্যাম্প বাউন্ডের ধরন, Read অনুরোধের জন্য রিড বিকল্পের মাধ্যমে নির্ধারণ করা হয়।
স্টোরেজ লেয়ারে রিড ট্রানজ্যাকশন সম্পর্কে বোঝা
এই বিভাগে রিডের ধরন এবং Cloud Firestore-এর স্টোরেজ লেয়ারে সেগুলি কীভাবে প্রসেস করা হয় তা বর্ণনা করা হয়েছে।
খুব ভালো রিডিং
ডিফল্ট হিসেবে, Cloud Firestore রিড দৃঢ়ভাবে সামঞ্জস্যপূর্ণ। এই শক্তিশালী সামঞ্জস্যের অর্থ হল, Cloud Firestore রিড ডেটার লেটেস্ট ভার্সন ফিরিয়ে দেয় যা রিড শুরু হওয়া পর্যন্ত কমিট করা সব রাইটকে প্রতিফলিত করে।
সিঙ্গেল স্প্লিট রিড
Cloud Firestore-এ স্টোরেজ ক্লায়েন্ট সেই স্প্লিটগুলি খোঁজে যেগুলি পড়তে হবে এমন সারির কী-এর মালিক। ধরা যাক, আগের বিভাগ থেকে স্প্লিট ৩-এ এটি রিড করতে হবে। রাউন্ড ট্রিপ লেটেন্সি কমাতে ক্লায়েন্ট সবচেয়ে কাছের রেপ্লিকায় রিড রিকোয়েস্ট পাঠায়।
এই মুহূর্তে, বেছে নেওয়া রেপ্লিকার উপর নির্ভর করে নিম্নলিখিত ঘটনা ঘটতে পারে:
- রিড রিকোয়েস্ট লিডার রেপ্লিকায় (জোন A) যায়।
- লিডার সবসময় আপ-টু-ডেট থাকে বলে, রিড সরাসরি এগিয়ে যেতে পারে।
- পড়ার অনুরোধ নন-লিডার রেপ্লিকায় যায় (যেমন, জোন B)
- স্প্লিট ৩ তার ইন্টার্নাল স্টেট থেকে জানতে পারে যে রিড করার জন্য তার কাছে পর্যাপ্ত তথ্য আছে এবং স্প্লিট সেটি করে।
- Split 3 লেটেস্ট ডেটা দেখেছে কিনা তা নিশ্চিত নয়। এটি লিডারকে একটি মেসেজ পাঠায় যাতে শেষ ট্রানজ্যাকশনের টাইমস্ট্যাম্প জানতে চাওয়া হয়, যা রিড করার জন্য প্রয়োজন। সেই ট্রানজ্যাকশন প্রয়োগ করা হয়ে গেলে, রিড প্রসেস করা যাবে।
Cloud Firestore তারপর তার ক্লায়েন্টকে উত্তর পাঠায়।
মাল্টি-স্প্লিট রিড
একাধিক স্প্লিট থেকে ডেটা রিড করতে হলে, সব স্প্লিট জুড়ে একই মেকানিজম কাজ করে। সব স্প্লিট থেকে ডেটা ফেরত পাওয়ার পরে, Cloud Firestore-এর স্টোরেজ ক্লায়েন্ট ফলাফল একত্রিত করে। Cloud Firestore তারপর এই ডেটা সহ তার ক্লায়েন্টকে উত্তর দেয়।
পুরানো রিড
Cloud Firestore-এ স্ট্রং রিড হল ডিফল্ট মোড। তবে, লিডারের সাথে যোগাযোগ করার প্রয়োজন হতে পারে বলে সম্ভাব্য বেশি লেটেন্সি হতে পারে। প্রায়ই আপনার Cloud Firestore অ্যাপ্লিকেশনকে ডেটার লেটেস্ট ভার্সন পড়তে হয় না এবং কয়েক সেকেন্ড পুরনো ডেটার সাথেও ফাংশনালিটি ভালভাবে কাজ করে।
এই ধরনের ক্ষেত্রে, ক্লায়েন্ট read_time রিড বিকল্প ব্যবহার করে বাসি রিড পাওয়ার বিকল্প বেছে নিতে পারেন। এই ক্ষেত্রে, read_time-এ ডেটা যেভাবে ছিল সেভাবেই রিড করা হয় এবং সবচেয়ে কাছাকাছি রেপ্লিকাটি নির্দিষ্ট read_time-এ ডেটা আছে কিনা তা যাচাই করে নেওয়ার সম্ভাবনা খুব বেশি।
উল্লেখযোগ্যভাবে আরও ভালো পারফর্ম্যান্সের জন্য, ১৫ সেকেন্ড হল একটি যুক্তিসঙ্গত স্টেলনেস ভ্যালু। এমনকি বাসি রিডের ক্ষেত্রেও, সারিগুলি একে অপরের সাথে সামঞ্জস্যপূর্ণ।
হটস্পট এড়িয়ে চলুন
Cloud Firestore-এ স্প্লিট অটোমেটিক ছোট ছোট অংশে ভাগ করা হয় যাতে প্রয়োজন হলে বা কী স্পেস বড় হলে আরও স্টোরেজ সার্ভারে ট্রাফিক পরিবেশন করার কাজ ডিস্ট্রিবিউট করা যায়। অতিরিক্ত ট্রাফিক ম্যানেজ করার জন্য তৈরি করা স্প্লিট ট্রাফিক কমে গেলেও প্রায় ~২৪ ঘণ্টা পর্যন্ত রেখে দেওয়া হয়। তাই, ট্রাফিক স্পাইক বারবার হলে, স্প্লিট বজায় রাখা হয় এবং প্রয়োজন হলে আরও স্প্লিট চালু করা হয়। এইসব মেকানিজম ট্রাফিক লোড বা ডেটাবেসের সাইজ বাড়ার সাথে সাথে Cloud Firestore ডেটাবেসকে অটোস্কেল করতে সাহায্য করে। তবে, কিছু সীমাবদ্ধতা আছে যেগুলি সম্পর্কে আপনাকে সচেতন থাকতে হবে, যেমন নিচে ব্যাখ্যা করা হয়েছে।
স্টোরেজ ও লোড স্প্লিট করতে সময় লাগে এবং খুব দ্রুত ট্রাফিক বাড়ালে হাই লেটেন্সি বা সময়সীমা পেরিয়ে যাওয়ার মতো সমস্যা হতে পারে, পরিষেবা অ্যাডজাস্ট করার সময় সাধারণত একে হটস্পট বলা হয়। সবচেয়ে ভালো পদ্ধতি হল, প্রতি সেকেন্ডে ৫০০টি অপারেশন সহ ডেটাবেসে কোনও কালেকশনে ট্রাফিক বাড়ানোর সময়, কী রেঞ্জ জুড়ে অপারেশন ডিস্ট্রিবিউট করা। এইভাবে ধীরে ধীরে ট্রাফিক বাড়ানোর পরে, প্রতি পাঁচ মিনিটে ৫০% পর্যন্ত ট্রাফিক বাড়ান। এই প্রসেসকে ৫০০/৫০/৫ নিয়ম বলা হয় এবং এটি আপনার ওয়ার্কলোড অনুযায়ী ডেটাবেসকে সবচেয়ে ভালভাবে স্কেল করার জন্য প্রস্তুত করে।
লোড বাড়ার সাথে সাথে স্প্লিট অটোমেটিক তৈরি হলেও, Cloud Firestore শুধুমাত্র ততক্ষণ পর্যন্ত কী রেঞ্জ স্প্লিট করতে পারে যতক্ষণ পর্যন্ত এটি রেপ্লিকেট করা স্টোরেজ সার্ভারের ডেডিকেটেড সেট ব্যবহার করে একটি ডকুমেন্ট পরিবেশন করছে। এর ফলে, একটি ডকুমেন্টে একসাথে অনেক অপারেশন করা হলে, সেই ডকুমেন্টে হটস্পট তৈরি হতে পারে। আপনি যদি কোনও একটি ডকুমেন্টে ক্রমাগত বেশি লেটেন্সি দেখতে পান, তাহলে একাধিক ডকুমেন্ট জুড়ে ডেটা স্প্লিট বা রেপ্লিকেট করার জন্য আপনার ডেটা মডেল পরিবর্তন করার কথা বিবেচনা করা উচিত।
একাধিক অপারেশন একই ডকুমেন্ট একই সাথে রিড এবং/অথবা রাইট করার চেষ্টা করলে কনটেনশন সংক্রান্ত সমস্যা হয়।
হটস্পটিংয়ের আরেকটি বিশেষ ঘটনা ঘটে যখন Cloud Firestore-এ ডকুমেন্ট আইডি হিসেবে ক্রমানুসারে ক্রমবর্ধমান/হ্রাসমান কী ব্যবহার করা হয় এবং প্রতি সেকেন্ডে উল্লেখযোগ্যভাবে বেশি সংখ্যক অপারেশন হয়। এখানে আরও স্প্লিট তৈরি করলে কোনও লাভ হয় না, কারণ ট্রাফিকের চাপ নতুন তৈরি করা স্প্লিটে চলে যায়। যেহেতু Cloud Firestore ডিফল্ট হিসেবে ডকুমেন্টের সব ফিল্ড অটোমেটিক ইন্ডেক্স করে, তাই এই ধরনের মুভিং হটস্পট ডকুমেন্টের ফিল্ডের ইন্ডেক্স স্পেসেও তৈরি হতে পারে, যাতে টাইমস্ট্যাম্পের মতো ক্রমানুসারে বাড়া/কমার ভ্যালু থাকে।
মনে রাখবেন, উপরে উল্লেখ করা পদ্ধতি অনুসরণ করে, Cloud Firestore কোনও কনফিগারেশন অ্যাডজাস্ট না করেই ইচ্ছামতো বড় ওয়ার্কলোড ম্যানেজ করতে পারে।
সমস্যার সমাধান
Cloud Firestore, কী ভিজ্যুয়ালাইজারকে একটি ডায়াগনস্টিক টুল হিসেবে প্রদান করে যা ব্যবহারের প্যাটার্ন বিশ্লেষণ করতে এবং হটস্পটিং সংক্রান্ত সমস্যার সমাধান করতে ডিজাইন করা হয়েছে।
এরপর কী
- আরও পেশাদার পদ্ধতি সম্পর্কে পড়ুন
- রিয়েল-টাইম কোয়েরি অ্যাট স্কেল সম্পর্কে জানুন