

Lisez ce document pour savoir comment faire évoluer votre application sans serveur au-delà de milliers d'opérations par seconde ou de centaines de milliers d'utilisateurs simultanés. Ce document aborde des sujets avancés pour vous aider à comprendre le système en détail. Si vous débutez avec Cloud Firestore, consultez plutôt le guide de démarrage rapide.
Cloud Firestore et les SDK Firebase pour mobile/Web fournissent un modèle puissant pour développer des applications sans serveur dans lesquelles le code côté client accède directement à la base de données. Les SDK permettent aux clients d'écouter les mises à jour des données en temps réel. Vous pouvez utiliser les mises à jour en temps réel pour créer des applications responsives qui ne nécessitent pas d'infrastructure de serveur. Bien qu'il soit très facile de mettre en place un système, il est utile de comprendre les contraintes des systèmes qui composent Cloud Firestore afin que votre application sans serveur évolue et fonctionne correctement lorsque le trafic augmente.
Consultez les sections suivantes pour obtenir des conseils sur le scaling de votre application.
Choisir un emplacement de base de données proche de vos utilisateurs
Le schéma suivant illustre l'architecture d'une application en temps réel :
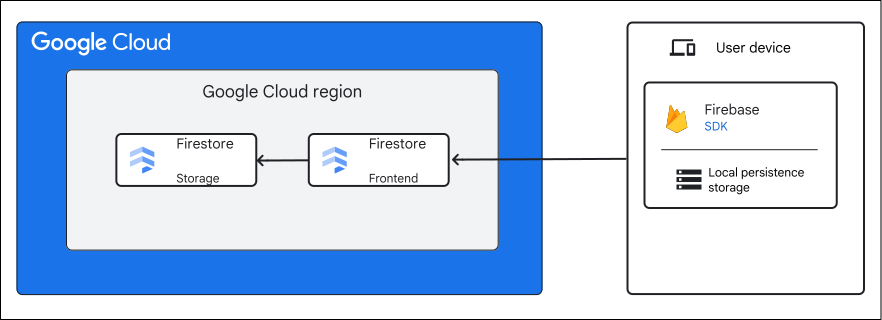
Lorsqu'une application exécutée sur l'appareil d'un utilisateur (mobile ou Web) établit une connexion à Cloud Firestore, la connexion est acheminée vers un serveur d'interface Cloud Firestore dans la même région que celle où se trouve votre base de données. Par exemple, si votre base de données se trouve dans us-east1, la connexion est également établie avec une interface Cloud Firestore également située dans us-east1. Ces connexions sont de longue durée et restent ouvertes jusqu'à ce qu'elles soient explicitement fermées par l'application. L'interface lit les données des systèmes de stockage Cloud Firestore sous-jacents.
La distance entre l'emplacement physique d'un utilisateur et l'emplacement de la base de données Cloud Firestore affecte la latence subie par l'utilisateur. Par exemple, un utilisateur en Inde dont l'application communique avec une base de données située dans une région Google Cloud en Amérique du Nord peut trouver l'expérience plus lente et l'application moins réactive que si la base de données était située plus près, par exemple en Inde ou dans une autre partie de l'Asie.
Concevoir des solutions fiables
Les sujets suivants améliorent ou affectent la fiabilité de votre application :
Activer le mode hors connexion
Les SDK Firebase assurent la persistance des données hors connexion. Si l'application sur l'appareil de l'utilisateur ne peut pas se connecter à Cloud Firestore, elle reste utilisable en utilisant les données mises en cache localement. Cela garantit l'accès aux données même lorsque les utilisateurs rencontrent des problèmes de connexion Internet ou perdent complètement l'accès pendant plusieurs heures ou jours. Pour en savoir plus sur le mode hors connexion, consultez Activer les données hors connexion.
Comprendre les nouvelles tentatives automatiques
Les SDK Firebase se chargent de relancer les opérations et de rétablir les connexions interrompues. Cela permet de contourner les erreurs temporaires causées par le redémarrage des serveurs ou les problèmes de réseau entre le client et la base de données.
Choisir entre des emplacements régionaux et multirégionaux
Le choix entre un emplacement régional et un emplacement multirégional implique plusieurs compromis. La principale différence réside dans la façon dont les données sont répliquées. Cela détermine les garanties de disponibilité de votre application. Une instance multirégionale offre une plus grande fiabilité de diffusion et augmente la durabilité de vos données, mais elle est plus coûteuse.
Comprendre le système de requêtes en temps réel
Les requêtes en temps réel, également appelées écouteurs d'instantanés, permettent à l'application d'écouter les modifications apportées à la base de données et de recevoir des notifications à faible latence dès que les données changent. Une application peut obtenir le même résultat en interrogeant régulièrement la base de données pour obtenir des mises à jour, mais cette méthode est souvent plus lente, plus coûteuse et nécessite plus de code. Pour obtenir des exemples de configuration et d'utilisation des requêtes en temps réel, consultez Recevoir des mises à jour en temps réel. Les sections suivantes expliquent en détail le fonctionnement des écouteurs d'instantanés et décrivent certaines des bonnes pratiques pour faire évoluer les requêtes en temps réel tout en conservant les performances.
Imaginons deux utilisateurs qui se connectent à Cloud Firestore via une application de chat créée avec l'un des SDK mobiles.
Le client A écrit dans la base de données pour ajouter et mettre à jour des documents dans une collection appelée chatroom :
collection chatroom:
    document message1:
      from: 'Sparky'
      message: 'Welcome to Cloud Firestore!'

    document message2:
      from: 'Santa'
      message: 'Presents are coming'
Le client B écoute les mises à jour dans la même collection à l'aide d'un écouteur d'instantanés. Le client B reçoit une notification immédiate chaque fois qu'un utilisateur crée un message. Le schéma suivant illustre l'architecture d'un écouteur d'instantanés :
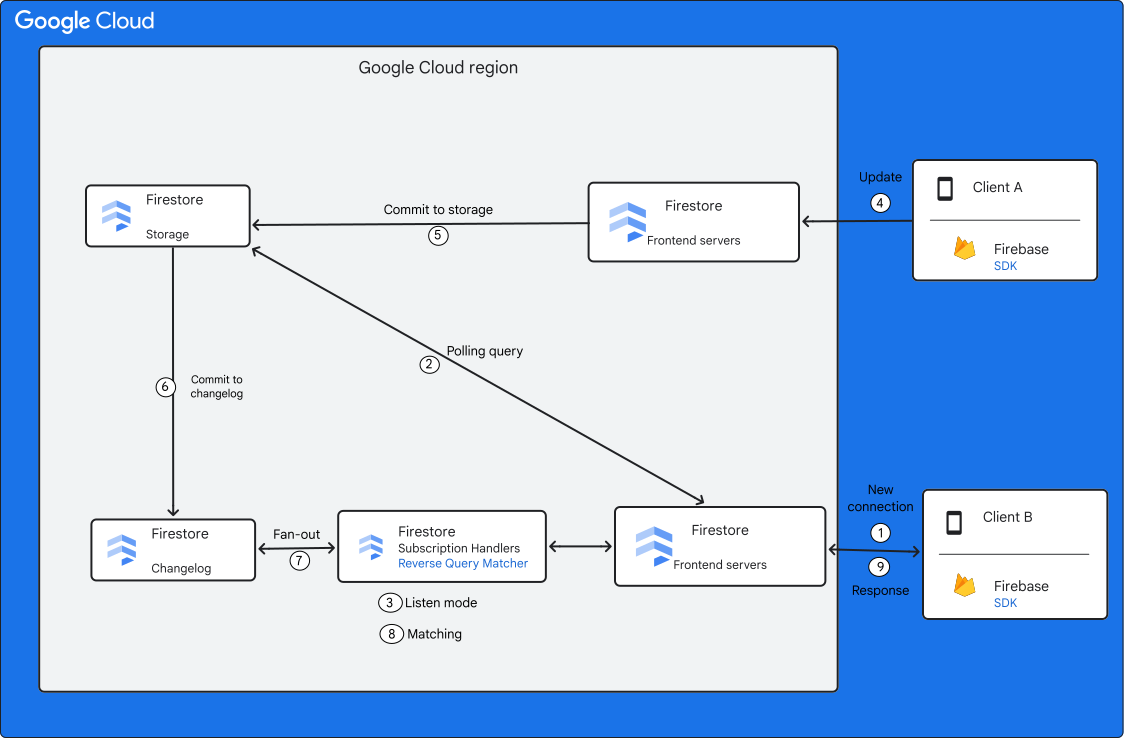
La séquence d'événements suivante se produit lorsque le client B connecte un écouteur d'instantanés à la base de données :
- Le client B ouvre une connexion à Cloud Firestore et enregistre un écouteur en appelant
onSnapshot(collection("chatroom"))via le SDK Firebase. Cet écouteur peut rester actif pendant des heures. - L'interface Cloud Firestore interroge le système de stockage sous-jacent pour amorcer l'ensemble de données. Il charge l'ensemble des résultats des documents correspondants. C'est ce que nous appelons une requête d'interrogation. Le système évalue ensuite les règles de sécurité Firebase de la base de données pour vérifier que l'utilisateur peut accéder à ces données. Si l'utilisateur est autorisé, la base de données lui renvoie les données.
- La requête du client B passe ensuite en mode d'écoute. L'écouteur s'enregistre auprès d'un gestionnaire d'abonnement et attend les mises à jour des données.
- Le client A envoie maintenant une opération d'écriture pour modifier un document.
- La base de données valide la modification du document dans son système de stockage.
- De manière transactionnelle, le système valide la même mise à jour dans un journal des modifications interne. Le journal des modifications établit un ordre strict des modifications au fur et à mesure qu'elles se produisent.
- Le journal des modifications transmet à son tour les données mises à jour à un pool de gestionnaires d'abonnements.
- Un outil de mise en correspondance de requêtes inversées s'exécute pour vérifier si le document mis à jour correspond à l'un des écouteurs d'instantanés actuellement enregistrés. Dans cet exemple, le document correspond à l'écouteur d'instantanés du client B. Comme son nom l'indique, vous pouvez considérer l'outil de mise en correspondance des requêtes inversées comme une requête de base de données normale, mais effectuée à l'envers. Au lieu de rechercher dans les documents ceux qui correspondent à une requête, il recherche efficacement dans les requêtes celles qui correspondent à un document entrant. Lorsqu'une correspondance est trouvée, le système transmet le document en question aux écouteurs d'instantanés. Ensuite, le système évalue les règles de sécurité Firebase de la base de données pour s'assurer que seuls les utilisateurs autorisés reçoivent les données.
- Le système transfère la mise à jour du document au SDK sur l'appareil du client B, et le rappel
onSnapshotse déclenche. Si la persistance locale est activée, le SDK applique également la mise à jour au cache local.
Un aspect essentiel de l'évolutivité de Cloud Firestore dépend de la distribution du journal des modifications aux gestionnaires d'abonnement et aux serveurs d'interface. La distribution ramifiée permet de propager efficacement une seule modification de données pour répondre à des millions de requêtes en temps réel et d'utilisateurs connectés. En exécutant de nombreuses instances répliquées de tous ces composants dans plusieurs zones (ou plusieurs régions dans le cas d'un déploiement multirégional), Cloud Firestore offre une haute disponibilité et une grande évolutivité.
Il convient de noter que toutes les opérations de lecture émises à partir des SDK mobiles et Web suivent le modèle ci-dessus. Ils effectuent une requête d'interrogation suivie d'un mode d'écoute pour maintenir les garanties de cohérence. Cela s'applique également aux écouteurs en temps réel, aux appels pour récupérer un document et aux requêtes ponctuelles. Vous pouvez considérer les récupérations de documents uniques et les requêtes ponctuelles comme des écouteurs d'instantanés de courte durée, qui sont soumis à des contraintes de performances similaires.
Appliquer les bonnes pratiques pour le scaling des requêtes en temps réel
Appliquez les bonnes pratiques suivantes pour concevoir des requêtes en temps réel évolutives.
Comprendre le trafic d'écriture élevé dans le système
Cette section vous aide à comprendre comment le système répond à un nombre croissant de requêtes d'écriture.
Les journaux de modifications Cloud Firestore qui gèrent les requêtes en temps réel évoluent automatiquement de manière horizontale à mesure que le trafic d'écriture augmente. À mesure que le taux d'écriture d'une base de données augmente au-delà de ce qu'un seul serveur peut gérer, le journal des modifications est réparti sur plusieurs serveurs, et le traitement des requêtes commence à consommer des données provenant de plusieurs gestionnaires d'abonnement au lieu d'un seul. Du point de vue du client et du SDK, tout cela est transparent et aucune action n'est requise de la part de l'application lorsque des divisions se produisent. Le diagramme suivant illustre le scaling des requêtes en temps réel :
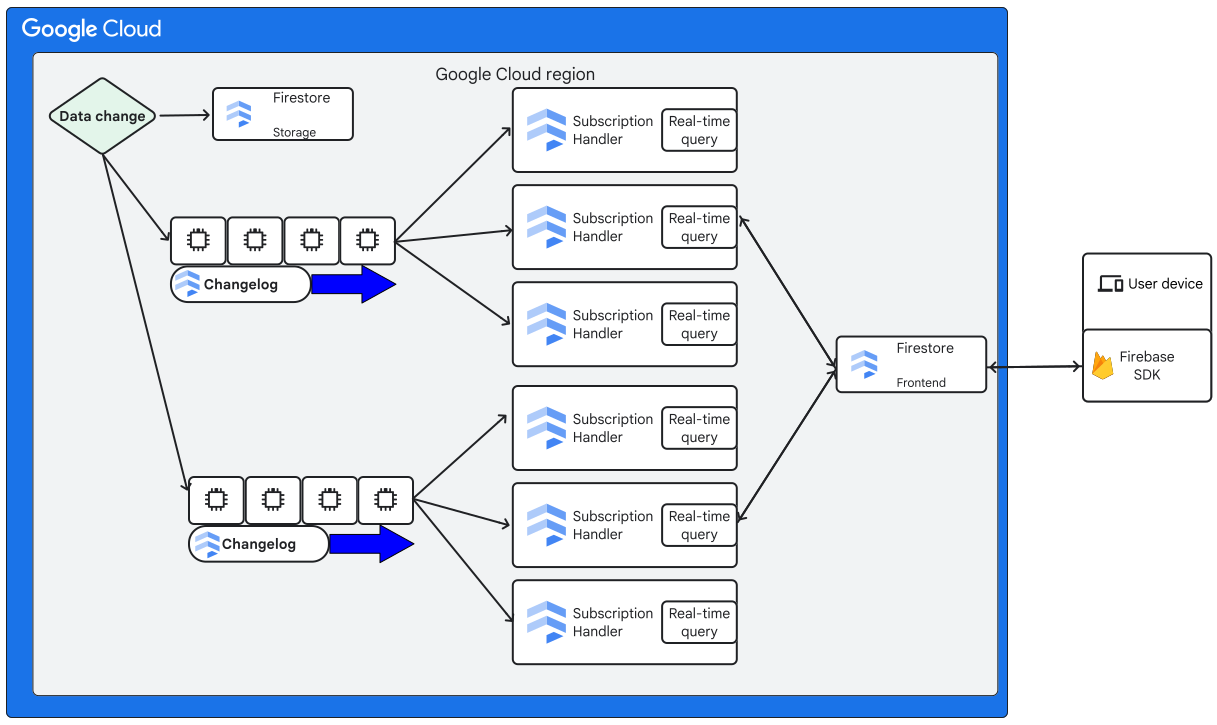
L'autoscaling vous permet d'augmenter votre trafic d'écriture sans limites, mais à mesure que le trafic augmente, le système peut mettre un certain temps à répondre. Suivez les recommandations de la règle 5-5-5 pour éviter de créer un hotspot d'écriture. Key Visualizer est un outil utile pour analyser les hotspots d'écriture.
De nombreuses applications ont une croissance organique prévisible, que Cloud Firestore peut gérer sans précautions particulières. Toutefois, les charges de travail par lot, comme l'importation d'un ensemble de données volumineux, peuvent augmenter les écritures trop rapidement. Lorsque vous concevez votre application, tenez compte de la provenance de votre trafic d'écriture.
Comprendre l'interaction entre les écritures et les lectures
Vous pouvez considérer le système de requêtes en temps réel comme un pipeline reliant les opérations d'écriture aux lecteurs. Chaque fois qu'un document est créé, mis à jour ou supprimé, la modification se propage du système de stockage aux écouteurs actuellement enregistrés. La structure du journal des modifications de Cloud Firestore garantit une cohérence forte, ce qui signifie que votre application ne reçoit jamais de notifications de mises à jour qui ne sont pas dans l'ordre par rapport au moment où la base de données a validé les modifications de données. Cela simplifie le développement d'applications en éliminant les cas particuliers liés à la cohérence des données.
Ce pipeline connecté signifie qu'une opération d'écriture provoquant des hotspots ou des conflits de verrouillage peut avoir un impact négatif sur les opérations de lecture. Lorsque les opérations d'écriture échouent ou sont limitées, une lecture peut être bloquée en attendant des données cohérentes du journal des modifications. Si cela se produit dans votre application, vous pouvez constater à la fois des opérations d'écriture lentes et des temps de réponse corrélés lents pour les requêtes. Pour éviter ce problème, il est essentiel d'éviter les hotspots.
Limiter la taille des documents et des opérations d'écriture
Lorsque vous créez des applications avec des écouteurs d'instantanés, vous souhaitez généralement que les utilisateurs soient rapidement informés des modifications de données. Pour ce faire, essayez de limiter la taille des éléments. Le système peut traiter très rapidement de petits documents comportant des dizaines de champs. Le traitement des documents plus volumineux contenant des centaines de champs et des données volumineuses prend plus de temps.
De même, privilégiez les opérations de commit et d'écriture courtes et rapides pour maintenir une faible latence. Les lots volumineux peuvent vous offrir un débit plus élevé du point de vue du rédacteur, mais peuvent en réalité augmenter le temps de notification pour les écouteurs d'instantanés. Cela est souvent contre-intuitif par rapport à l'utilisation d'autres systèmes de base de données où vous pouvez utiliser le traitement par lot pour améliorer les performances.
Utiliser des écouteurs efficaces
À mesure que les taux d'écriture de votre base de données augmentent, Cloud Firestore répartit le traitement des données sur de nombreux serveurs. L'algorithme de segmentation de Cloud Firestore tente de colocaliser les données d'une même collection ou d'un même groupe de collections sur le même serveur de journal des modifications. Le système tente de maximiser le débit d'écriture possible tout en maintenant le nombre de serveurs impliqués dans le traitement d'une requête aussi bas que possible.
Cependant, certains modèles peuvent toujours entraîner un comportement non optimal pour les écouteurs d'instantanés. Par exemple, si votre application stocke la plupart de ses données dans une seule grande collection, l'écouteur peut avoir besoin de se connecter à de nombreux serveurs pour recevoir toutes les données dont il a besoin. Cela reste vrai même si vous appliquez un filtre de requête. La connexion à de nombreux serveurs augmente le risque de ralentissement des réponses.
Pour éviter ces réponses plus lentes, concevez votre schéma et votre application de manière à ce que le système puisse diffuser les écouteurs sans avoir à accéder à de nombreux serveurs différents. Il peut être préférable de diviser vos données en collections plus petites avec des taux d'écriture plus faibles.
Cela revient à réfléchir aux performances des requêtes dans une base de données relationnelle qui nécessitent des analyses de table complètes. Dans une base de données relationnelle, une requête qui nécessite une analyse complète de la table équivaut à un écouteur d'instantanés qui surveille une collection à fort taux de renouvellement. Elle peut s'exécuter lentement par rapport à une requête que la base de données peut diffuser à l'aide d'un index plus spécifique. Une requête avec un index plus spécifique est semblable à un écouteur d'instantanés qui surveille un seul document ou une collection qui change moins souvent. Vous devez tester la charge de votre application pour mieux comprendre le comportement et les besoins de votre cas d'utilisation.
Maintenir la rapidité des requêtes d'interrogation
Un autre aspect essentiel des requêtes réactives en temps réel consiste à s'assurer que la requête d'interrogation permettant d'amorcer les données est rapide et efficace. La première fois qu'un nouvel écouteur d'instantanés se connecte, il doit charger l'ensemble des résultats et l'envoyer à l'appareil de l'utilisateur. Les requêtes lentes rendent votre application moins réactive. Cela inclut, par exemple, les requêtes qui tentent de lire de nombreux documents ou celles qui n'utilisent pas les index appropriés.
Dans certains cas, un écouteur peut également passer de l'état d'écoute à l'état d'interrogation. Cela se produit automatiquement et de manière transparente pour les SDK et votre application. Les conditions suivantes peuvent déclencher un état d'interrogation :
- Le système rééquilibre un journal des modifications en raison de changements de charge.
- Les hotspots entraînent l'échec ou le retard des écritures dans la base de données.
- Les redémarrages temporaires du serveur affectent temporairement les écouteurs.
Si vos requêtes d'interrogation sont suffisamment rapides, l'état d'interrogation devient transparent pour les utilisateurs de votre application.
Privilégiez les écouteurs de longue durée
Ouvrir et maintenir les écouteurs actifs aussi longtemps que possible est souvent le moyen le plus économique de créer une application qui utilise Cloud Firestore. Lorsque vous utilisez Cloud Firestore, vous êtes facturé pour les documents renvoyés à votre application, et non pour le maintien d'une connexion ouverte. Un écouteur d'instantanés de longue durée ne lit que les données dont il a besoin pour diffuser la requête tout au long de sa durée de vie. Cela inclut une opération d'interrogation initiale suivie de notifications lorsque les données changent réellement. En revanche, les requêtes ponctuelles relisent des données qui n'ont peut-être pas changé depuis la dernière exécution de la requête par l'application.
Si votre application doit consommer un volume élevé de données, les écouteurs d'instantanés peuvent ne pas être adaptés. Par exemple, si votre cas d'utilisation transmet de nombreux documents par seconde via une connexion pendant une période prolongée, il peut être préférable d'opter pour des requêtes ponctuelles qui s'exécutent à une fréquence inférieure.
Étape suivante
- Découvrez comment utiliser des écouteurs d'instantanés.
- Découvrez d'autres bonnes pratiques.