

In diesem Dokument finden Sie Informationen zum Skalieren Ihrer serverlosen Anwendung auf mehr als Tausende von Vorgängen pro Sekunde oder Hunderttausende von gleichzeitigen Nutzern. Dieses Dokument enthält weiterführende Themen, die Ihnen helfen, das System im Detail zu verstehen. Wenn Sie gerade erst mit Cloud Firestore beginnen, lesen Sie stattdessen die Kurzanleitung.
Cloud Firestore und die Firebase-SDKs für Mobilgeräte und das Web bieten ein leistungsstarkes Modell für die Entwicklung serverloser Anwendungen, bei denen clientseitiger Code direkt auf die Datenbank zugreift. Mit den SDKs können Clients in Echtzeit auf Aktualisierungen der Daten warten. Mit Echtzeitaktualisierungen können Sie responsive Anwendungen erstellen, die keine Serverinfrastruktur erfordern. Es ist zwar sehr einfach, etwas zum Laufen zu bringen, aber es ist hilfreich, die Einschränkungen in den Systemen zu verstehen, aus denen Cloud Firestore besteht, damit Ihre serverlose Anwendung bei steigendem Traffic gut skaliert und funktioniert.
In den folgenden Abschnitten finden Sie Hinweise zur Skalierung Ihrer Anwendung.
Datenbankspeicherort in der Nähe Ihrer Nutzer auswählen
Das folgende Diagramm zeigt die Architektur einer Echtzeit-App:
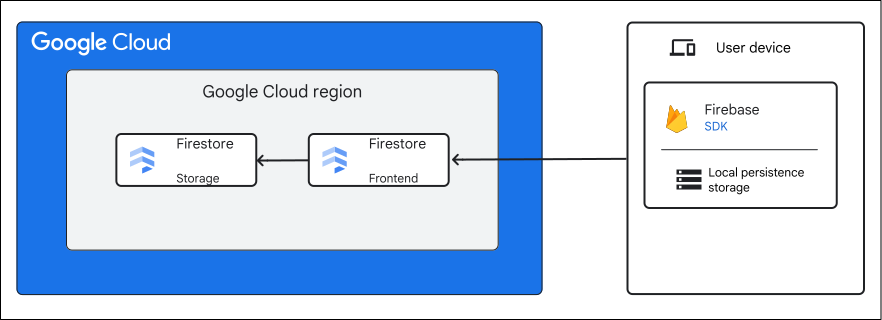
Wenn eine App, die auf dem Gerät eines Nutzers (Mobilgerät oder Web) ausgeführt wird, eine Verbindung zu Cloud Firestore herstellt, wird die Verbindung an einen Cloud Firestore-Frontend-Server in derselben Region weitergeleitet, in der sich Ihre Datenbank befindet. Wenn sich Ihre Datenbank beispielsweise in us-east1 befindet, wird die Verbindung auch zu einem Cloud Firestore-Frontend in us-east1 hergestellt. Diese Verbindungen sind langlebig und bleiben offen, bis sie von der Anwendung explizit geschlossen werden. Das Frontend liest Daten aus den zugrunde liegenden Cloud Firestore-Speichersystemen.
Die Entfernung zwischen dem physischen Standort eines Nutzers und dem Standort der Cloud Firestore-Datenbank wirkt sich auf die Latenz aus, die der Nutzer erfährt. Ein Nutzer in Indien, dessen App mit einer Datenbank in einer Google Cloud-Region in Nordamerika kommuniziert, könnte beispielsweise feststellen, dass die App langsamer und weniger reaktionsschnell ist, als wenn sich die Datenbank stattdessen in der Nähe, z. B. in Indien oder in einem anderen Teil Asiens, befinden würde.
Einhaltung von Zuverlässigkeitsvorgaben
Die folgenden Themen verbessern oder beeinflussen die Zuverlässigkeit Ihrer App:
Offlinemodus aktivieren
Die Firebase SDKs bieten Offlinedatenpersistenz. Wenn die App auf dem Gerät des Nutzers keine Verbindung zu Cloud Firestore herstellen kann, bleibt sie durch die Arbeit mit lokal im Cache gespeicherten Daten nutzbar. So ist der Datenzugriff auch dann möglich, wenn die Internetverbindung der Nutzer unregelmäßig ist oder sie mehrere Stunden oder Tage lang gar keinen Zugriff haben. Weitere Informationen zum Offlinemodus finden Sie unter Offlinedaten aktivieren.
Automatische Wiederholungsversuche
Die Firebase SDKs übernehmen die Wiederholung von Vorgängen und die Wiederherstellung unterbrochener Verbindungen. So können vorübergehende Fehler umgangen werden, die durch den Neustart von Servern oder Netzwerkprobleme zwischen dem Client und der Datenbank verursacht werden.
Zwischen regionalen und multiregionalen Standorten wählen
Bei der Wahl zwischen regionalen und multiregionalen Standorten gibt es mehrere Vor- und Nachteile. Der Hauptunterschied besteht darin, wie Daten repliziert werden. Dies bestimmt die Verfügbarkeitsgarantien Ihrer Anwendung. Eine multiregionale Instanz bietet eine höhere Zuverlässigkeit bei der Bereitstellung und erhöht die Langlebigkeit Ihrer Daten, ist aber auch teurer.
Echtzeit-Abfragesystem
Mit Echtzeitabfragen, auch Snapshot-Listener genannt, kann die App Änderungen in der Datenbank überwachen und Benachrichtigungen mit niedriger Latenz erhalten, sobald sich die Daten ändern. Eine App kann dasselbe Ergebnis erzielen, indem sie die Datenbank regelmäßig nach Aktualisierungen abfragt. Das ist jedoch oft langsamer, teurer und erfordert mehr Code. Beispiele für das Einrichten und Verwenden von Echtzeitabfragen finden Sie unter Echtzeitaktualisierungen abrufen. In den folgenden Abschnitten wird ausführlich beschrieben, wie Snapshot-Listener funktionieren. Außerdem werden einige Best Practices für die Skalierung von Echtzeitabfragen bei gleichbleibender Leistung vorgestellt.
Stellen Sie sich zwei Nutzer vor, die sich über eine Messaging-App, die mit einem der mobilen SDKs erstellt wurde, mit Cloud Firestore verbinden.
Client A schreibt in die Datenbank, um Dokumente in einer Sammlung namens chatroom hinzuzufügen und zu aktualisieren:
collection chatroom:
    document message1:
      from: 'Sparky'
      message: 'Welcome to Cloud Firestore!'

    document message2:
      from: 'Santa'
      message: 'Presents are coming'
Client B wartet mithilfe eines Snapshot-Listeners auf Aktualisierungen in derselben Sammlung. Client B erhält sofort eine Benachrichtigung, wenn jemand eine neue Nachricht erstellt. Das folgende Diagramm zeigt die Architektur hinter einem Snapshot-Listener:
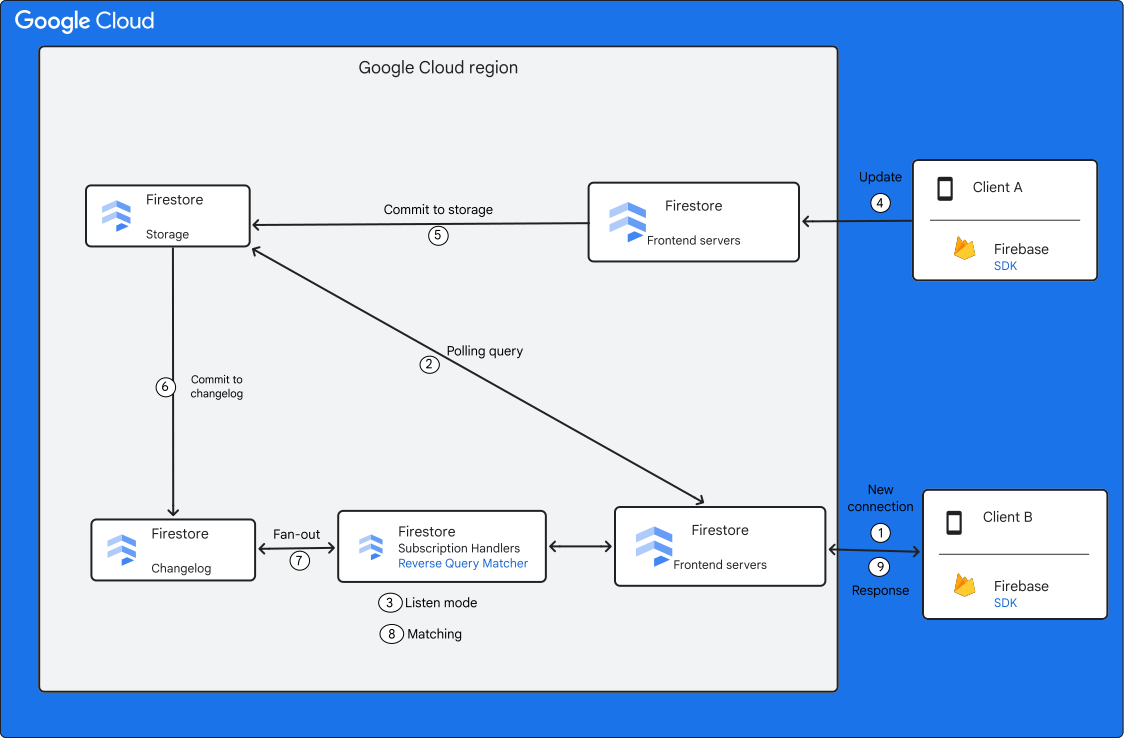
Die folgende Ereignisabfolge findet statt, wenn Client B einen Snapshot-Listener mit der Datenbank verbindet:
- Client B öffnet eine Verbindung zu Cloud Firestore und registriert einen Listener, indem er über das Firebase SDK einen Aufruf an
onSnapshot(collection("chatroom"))sendet. Dieser Listener kann stundenlang aktiv bleiben. - Das Cloud Firestore-Frontend fragt das zugrunde liegende Speichersystem ab, um das Dataset zu bootstrappen. Es wird die gesamte Ergebnismenge der übereinstimmenden Dokumente geladen. Wir bezeichnen dies als Abfrage. Das System wertet dann die Firebase-Sicherheitsregeln der Datenbank aus, um zu prüfen, ob der Nutzer auf diese Daten zugreifen kann. Wenn der Nutzer autorisiert ist, gibt die Datenbank die Daten an den Nutzer zurück.
- Die Abfrage von Client B wechselt dann in den Überwachungsmodus. Der Listener registriert sich bei einem Abo-Handler und wartet auf Aktualisierungen der Daten.
- Client A sendet nun einen Schreibvorgang, um ein Dokument zu ändern.
- Die Datenbank schreibt die Dokumentänderung in ihr Speichersystem.
- Transaktional schreibt das System dieselbe Aktualisierung in ein internes Änderungsprotokoll. Das Änderungsprotokoll legt eine strikte Reihenfolge der Änderungen fest, wie sie auftreten.
- Das Änderungsprotokoll wiederum verteilt die aktualisierten Daten an einen Pool von Abo-Handlern.
- Ein Reverse Query Matcher wird ausgeführt, um zu prüfen, ob das aktualisierte Dokument mit derzeit registrierten Snapshot-Listenern übereinstimmt. In diesem Beispiel entspricht das Dokument dem Snapshot-Listener von Client B. Wie der Name schon sagt, können Sie sich den Reverse Query Matcher als normale Datenbankabfrage vorstellen, die jedoch umgekehrt ausgeführt wird. Anstatt Dokumente nach Übereinstimmungen mit einer Abfrage zu durchsuchen, werden Abfragen effizient nach Übereinstimmungen mit einem eingehenden Dokument durchsucht. Wenn eine Übereinstimmung gefunden wird, leitet das System das betreffende Dokument an die Snapshot-Listener weiter. Anschließend wertet das System die Firebase-Sicherheitsregeln der Datenbank aus, um sicherzustellen, dass nur autorisierte Nutzer die Daten erhalten.
- Das System leitet die Dokumentaktualisierung an das SDK auf dem Gerät von Client B weiter und der Callback
onSnapshotwird ausgelöst. Wenn die lokale Persistenz aktiviert ist, wendet das SDK die Aktualisierung auch auf den lokalen Cache an.
Ein wichtiger Teil der Skalierbarkeit von Cloud Firestore hängt vom Fan-out vom Änderungsprotokoll zu den Abo-Handlern und den Frontend-Servern ab. Durch das Fan-out kann eine einzelne Datenänderung effizient weitergegeben werden, um Millionen von Echtzeitabfragen und verbundenen Nutzern zu bedienen. Durch die Ausführung vieler Replikate aller dieser Komponenten in mehreren Zonen (oder mehreren Regionen im Fall einer multiregionalen Bereitstellung) erreicht Cloud Firestore eine Hochverfügbarkeit und Skalierbarkeit.
Alle Lesevorgänge, die von mobilen und Web-SDKs ausgegeben werden, folgen dem obigen Modell. Sie führen eine Abfrage aus, gefolgt vom Überwachungsmodus, um die Konsistenzgarantien aufrechtzuerhalten. Dies gilt auch für Echtzeit-Listener, Aufrufe zum Abrufen eines Dokuments und One-Shot-Abfragen. Sie können sich das Abrufen einzelner Dokumente und One-Shot-Abfragen als kurzlebige Snapshot-Listener vorstellen, die ähnliche Einschränkungen in Bezug auf die Leistung haben.
Best Practices für die Skalierung von Echtzeitabfragen anwenden
Wenden Sie die folgenden Best Practices an, um skalierbare Echtzeitabfragen zu entwerfen.
Hohen Schreib-Traffic im System verstehen
In diesem Abschnitt erfahren Sie, wie das System auf eine zunehmende Anzahl von Schreibanfragen reagiert.
Die Cloud Firestore-Änderungslogs, die die Echtzeitabfragen steuern, werden automatisch horizontal skaliert, wenn der Schreibtraffic zunimmt. Wenn die Schreibrate für eine Datenbank die Kapazität eines einzelnen Servers übersteigt, wird das Änderungsprotokoll auf mehrere Server aufgeteilt und die Abfrageverarbeitung beginnt, Daten von mehreren Abo-Handlern statt von einem zu nutzen. Aus Sicht des Clients und des SDK ist dies alles transparent und die App muss bei Aufteilungen nichts unternehmen. Das folgende Diagramm zeigt, wie Echtzeitabfragen skaliert werden:
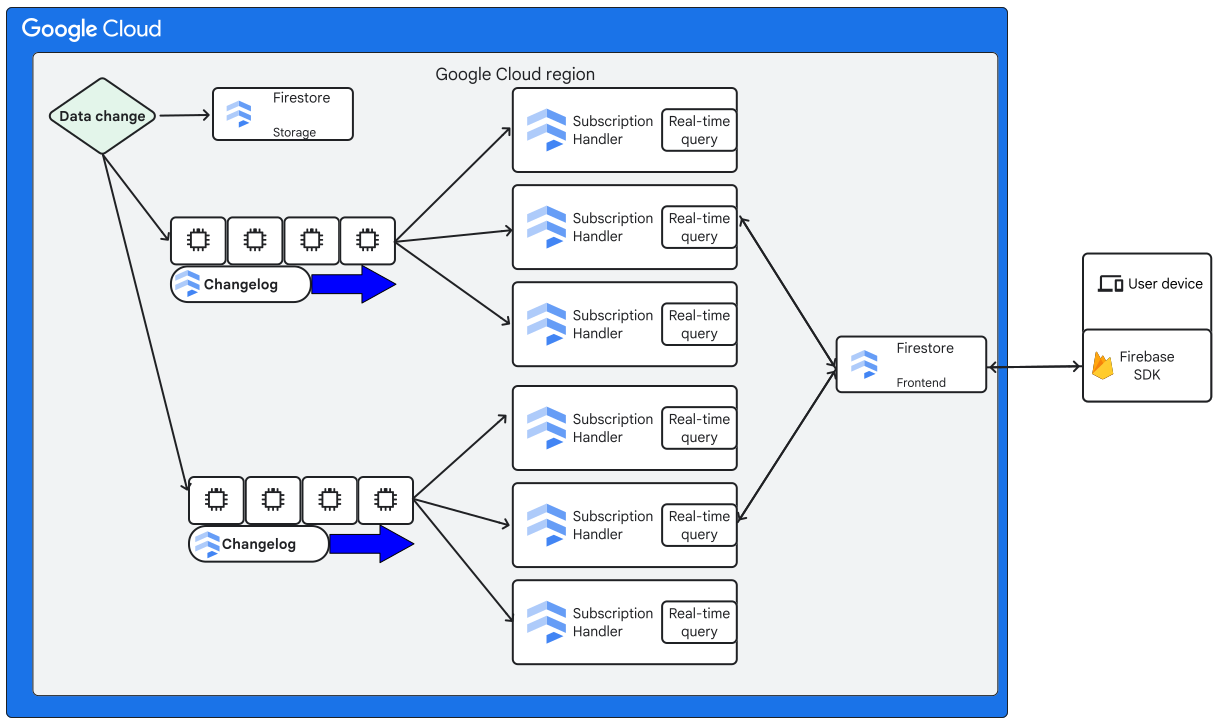
Mit der automatischen Skalierung können Sie den Schreibtraffic unbegrenzt erhöhen. Wenn der Traffic jedoch zunimmt, kann es einige Zeit dauern, bis das System reagiert. Folgen Sie den Empfehlungen der 5-5-5-Regel, um einen Schreib-Hotspot zu vermeiden. Key Visualizer ist ein nützliches Tool zum Analysieren von Schreib-Hotspots.
Viele Anwendungen haben ein vorhersehbares organisches Wachstum, das Cloud Firestore ohne Vorsichtsmaßnahmen bewältigen kann. Bei Batcharbeitslasten wie dem Importieren eines großen Datasets können Schreibvorgänge jedoch zu schnell hochgefahren werden. Behalten Sie beim Entwerfen Ihrer Anwendung im Blick, woher der Schreibtraffic stammt.
Interaktion von Schreib- und Lesevorgängen verstehen
Sie können sich das Echtzeit-Abfragesystem als eine Pipeline vorstellen, die Schreibvorgänge mit Lesevorgängen verbindet. Wenn ein Dokument erstellt, aktualisiert oder gelöscht wird, wird die Änderung vom Speichersystem an die aktuell registrierten Listener weitergegeben. Die Struktur des Änderungsprotokolls von Cloud Firestore garantiert strikte Konsistenz. Das bedeutet, dass Ihre Anwendung nie Benachrichtigungen zu Aktualisierungen erhält, die nicht der Reihenfolge entsprechen, in der die Datenbank die Datenänderungen übernommen hat. Dies vereinfacht die App-Entwicklung, da Grenzfälle im Zusammenhang mit der Datenkonsistenz vermieden werden.
Diese verbundene Pipeline bedeutet, dass ein Schreibvorgang, der Hotspots oder Sperrkonflikte verursacht, sich negativ auf Lesevorgänge auswirken kann. Wenn Schreibvorgänge fehlschlagen oder gedrosselt werden, kann ein Lesevorgang ins Stocken geraten, während auf konsistente Daten aus dem Änderungsprotokoll gewartet wird. Wenn dies in Ihrer Anwendung der Fall ist, werden möglicherweise sowohl langsame Schreibvorgänge als auch korrelierte langsame Antwortzeiten für Abfragen angezeigt. Die Vermeidung von Hotspots ist der Schlüssel, um dieses Problem zu umgehen.
Dokumente und Schreibvorgänge klein halten
Wenn Sie Anwendungen mit Snapshot-Listenern erstellen, möchten Sie in der Regel, dass Nutzer schnell über Datenänderungen informiert werden. Um dies zu erreichen, sollten Sie die Dinge klein halten. Das System kann kleine Dokumente mit Dutzenden von Feldern sehr schnell durch das System leiten. Größere Dokumente mit Hunderten von Feldern und großen Datenmengen benötigen mehr Zeit für die Verarbeitung.
Bevorzugen Sie außerdem kurze, schnelle Commit- und Schreibvorgänge, um die Latenz niedrig zu halten. Große Batches können aus Sicht des Schreibers einen höheren Durchsatz ermöglichen, aber die Benachrichtigungszeit für Snapshot-Listener erhöhen. Dies ist oft kontraintuitiv im Vergleich zu anderen Datenbanksystemen, bei denen Sie die Leistung durch Batching verbessern können.
Effiziente Listener verwenden
Wenn die Schreibraten für Ihre Datenbank steigen, verteilt Cloud Firestore die Datenverarbeitung auf viele Server. Der Sharding-Algorithmus von Cloud Firestore versucht, Daten aus derselben Sammlung oder Sammlungsgruppe auf demselben Änderungsprotokollserver zu speichern. Das System versucht, den möglichen Schreibdurchsatz zu maximieren und gleichzeitig die Anzahl der an der Verarbeitung einer Abfrage beteiligten Server so gering wie möglich zu halten.
Bestimmte Muster können jedoch weiterhin zu einem suboptimalen Verhalten für Snapshot-Listener führen. Wenn Ihre App beispielsweise die meisten Daten in einer großen Sammlung speichert, muss der Listener möglicherweise eine Verbindung zu vielen Servern herstellen, um alle erforderlichen Daten zu erhalten. Das gilt auch dann, wenn Sie einen Abfragefilter anwenden. Wenn Sie eine Verbindung zu vielen Servern herstellen, erhöht sich das Risiko langsamerer Antworten.
Um diese langsameren Antworten zu vermeiden, sollten Sie Ihr Schema und Ihre Anwendung so entwerfen, dass das System Listener bedienen kann, ohne viele verschiedene Server aufrufen zu müssen. Am besten ist es, die Daten in kleinere Sammlungen mit niedrigeren Schreibraten aufzuteilen.
Das ist vergleichbar mit Leistungsabfragen in einer relationalen Datenbank, die vollständige Tabellenscans erfordern. In einer relationalen Datenbank entspricht eine Abfrage, die einen vollständigen Tabellenscan erfordert, einem Snapshot-Listener, der eine Sammlung mit hoher Fluktuation überwacht. Sie kann im Vergleich zu einer Abfrage, die die Datenbank mit einem spezifischeren Index verarbeiten kann, langsam sein. Eine Abfrage mit einem spezifischeren Index ist wie ein Snapshot-Listener, der ein einzelnes Dokument oder eine Sammlung überwacht, die sich seltener ändert. Sie sollten Ihre Anwendung einem Lasttest unterziehen, um das Verhalten und die Anforderungen Ihres Anwendungsfalls besser zu verstehen.
Abfrageintervalle kurz halten
Ein weiterer wichtiger Teil von responsiven Echtzeitabfragen besteht darin, dafür zu sorgen, dass die Abfrage zum Bootstrapping der Daten schnell und effizient ist. Wenn ein neuer Snapshot-Listener zum ersten Mal eine Verbindung herstellt, muss er die gesamte Ergebnismenge laden und an das Gerät des Nutzers senden. Langsame Abfragen verringern die Reaktionsfähigkeit Ihrer Anwendung. Dazu gehören beispielsweise Abfragen, die versuchen, viele Dokumente zu lesen, oder Abfragen, die nicht die entsprechenden Indexe verwenden.
Ein Listener kann unter bestimmten Umständen auch von einem Listening-Status in einen Abfragestatus zurückkehren. Dies geschieht automatisch und ist für die SDKs und Ihre App transparent. Die folgenden Bedingungen können einen Abfragestatus auslösen:
- Das System gleicht ein Änderungsprotokoll aufgrund von Laständerungen neu aus.
- Hotspots führen zu fehlgeschlagenen oder verzögerten Schreibvorgängen in der Datenbank.
- Vorübergehende Serverneustarts wirken sich vorübergehend auf Listener aus.
Wenn Ihre Abfrageanfragen schnell genug sind, wird ein Abfragestatus für die Nutzer Ihrer Anwendung transparent.
Langlebige Listener bevorzugen
Das Öffnen und Offenhalten von Listenern so lange wie möglich ist oft die kostengünstigste Methode, um eine App zu erstellen, die Cloud Firestore verwendet. Wenn Sie Cloud Firestore verwenden, werden Ihnen die an Ihre Anwendung zurückgegebenen Dokumente in Rechnung gestellt, nicht die Aufrechterhaltung einer offenen Verbindung. Ein langlebiger Snapshot-Listener liest nur die Daten, die er benötigt, um die Abfrage während seiner Lebensdauer zu verarbeiten. Dazu gehört ein anfänglicher Abrufvorgang, gefolgt von Benachrichtigungen, wenn sich die Daten tatsächlich ändern. Bei One-Shot-Abfragen werden dagegen Daten noch einmal gelesen, die sich seit der letzten Ausführung der Abfrage durch die App möglicherweise nicht geändert haben.
In Fällen, in denen Ihre App eine hohe Datenrate verarbeiten muss, sind Snapshot-Listener möglicherweise nicht geeignet. Wenn Ihr Anwendungsfall beispielsweise über einen längeren Zeitraum viele Dokumente pro Sekunde über eine Verbindung überträgt, ist es möglicherweise besser, One-Shot-Abfragen zu verwenden, die mit einer niedrigeren Frequenz ausgeführt werden.