

במסמך הזה מוסבר איך להרחיב את האפליקציה ללא שרת (serverless) ליותר מאלפי פעולות בשנייה או למאות אלפי משתמשים בו-זמנית. המסמך הזה כולל נושאים מתקדמים שיעזרו לכם להבין את המערכת לעומק. אם אתם רק מתחילים להשתמש ב-Cloud Firestore, כדאי לעיין במדריך למתחילים.
Cloud Firestore וערכות ה-SDK של Firebase לנייד ולאינטרנט מספקים מודל יעיל לפיתוח אפליקציות ללא שרת (serverless), שבהן קוד בצד הלקוח ניגש ישירות למסד הנתונים. ערכות ה-SDK מאפשרות ללקוחות להאזין לעדכונים של הנתונים בזמן אמת. אתם יכולים להשתמש בעדכונים בזמן אמת כדי ליצור אפליקציות רספונסיביות שלא דורשות תשתית שרתים. קל מאוד להפעיל את המערכת, אבל כדאי להבין את המגבלות של המערכות שמרכיבות את Cloud Firestore כדי שהאפליקציה בלי שרת תתאים את עצמה לעומס ותפעל היטב כשתעבורת הנתונים תגדל.
בקטעים הבאים מפורטות עצות להרחבת האפליקציה.
בחירת מיקום למסד הנתונים שקרוב למשתמשים
התרשים הבא מציג את הארכיטקטורה של אפליקציה בזמן אמת:

כשאפליקציה שפועלת במכשיר של משתמש (נייד או אינטרנט) יוצרת חיבור ל-Cloud Firestore, החיבור מנותב לשרת קצה קדמי של Cloud Firestore באותו אזור שבו נמצא מסד הנתונים. לדוגמה, אם מסד הנתונים נמצא ב-us-east1, החיבור עובר גם ל-frontend של Cloud Firestore שנמצא גם ב-us-east1. החיבורים האלה נשארים פתוחים עד שהאפליקציה סוגרת אותם באופן מפורש. ממשק המשתמש קורא נתונים ממערכות האחסון הבסיסיות של Cloud Firestore.
המרחק בין המיקום הפיזי של המשתמש לבין המיקום של מסד הנתונים של Cloud Firestore משפיע על זמן האחזור שהמשתמש חווה. לדוגמה, משתמש בהודו שהאפליקציה שלו מתקשרת עם מסד נתונים באזור Google Cloud בצפון אמריקה, עשוי לגלות שהחוויה איטית יותר והאפליקציה פחות מהירה מאשר אם מסד הנתונים היה ממוקם קרוב יותר, למשל בהודו או בחלק אחר של אסיה.
תכנון למטרת אמינות
הנושאים הבאים משפרים את האמינות של האפליקציה או משפיעים עליה:
הפעלת מצב אופליין
ערכות ה-SDK של Firebase מספקות שמירת נתונים אופליין. אם האפליקציה במכשיר של המשתמש לא יכולה להתחבר ל-Cloud Firestore, האפליקציה ממשיכה לפעול באמצעות נתונים ששמורים במטמון המקומי. כך אפשר לגשת לנתונים גם כשהחיבור לאינטרנט לא יציב או כשהגישה לאינטרנט נחסמת לכמה שעות או ימים. למידע נוסף על מצב אופליין, ראו הפעלת נתונים ממקורות אופליין.
הסבר על ניסיונות חוזרים אוטומטיים
ערכות ה-SDK של Firebase מטפלות בניסיונות חוזרים של פעולות ובחידוש חיבורים מנותקים. כך אפשר לעקוף שגיאות זמניות שנגרמות כתוצאה מהפעלה מחדש של שרתים או מבעיות ברשת בין הלקוח למסד הנתונים.
בחירה בין מיקומים אזוריים למיקומים במספר אזורים
יש כמה שיקולים שצריך להביא בחשבון כשבוחרים בין מיקומים אזוריים לבין מיקומים במספר אזורים. ההבדל העיקרי הוא באופן שבו נוצרות רפליקות של הנתונים. הבחירה הזו משפיעה על הזמינות של האפליקציה. מכונה בכמה אזורים מספקת אמינות גבוהה יותר של הצגת הנתונים ומגדילה את העמידות של הנתונים, אבל העלות גבוהה יותר.
הסבר על מערכת השאילתות בזמן אמת
שאילתות בזמן אמת, שנקראות גם מאזינים לתמונות מצב, מאפשרות לאפליקציה להאזין לשינויים במסד הנתונים ולקבל התראות בזמן אחזור קצר ברגע שהנתונים משתנים. אפליקציה יכולה להגיע לאותה תוצאה על ידי דגימה תקופתית של מסד הנתונים כדי לקבל עדכונים, אבל בדרך כלל זה איטי יותר, יקר יותר ודורש יותר קוד. במאמר קבלת עדכונים בזמן אמת מוסבר איך להגדיר שאילתות בזמן אמת ולהשתמש בהן. בקטעים הבאים נסביר בפירוט איך פועלים מאזינים לתמונות מצב, ונתאר כמה מהשיטות המומלצות להרחבת שאילתות בזמן אמת תוך שמירה על הביצועים.
נניח ששני משתמשים מתחברים אל Cloud Firestore דרך אפליקציית הודעות שנבנתה באמצעות אחת מערכות ה-SDK לנייד.
לקוח א' כותב למסד הנתונים כדי להוסיף ולעדכן מסמכים באוסף שנקרא chatroom:
collection chatroom:
    document message1:
      from: 'Sparky'
      message: 'Welcome to Cloud Firestore!'

    document message2:
      from: 'Santa'
      message: 'Presents are coming'
לקוח ב' מאזין לעדכונים באותו אוסף באמצעות מאזין לתמונת מצב. לקוח ב' מקבל התראה מיידית בכל פעם שמישהו יוצר הודעה חדשה. התרשים הבא מציג את הארכיטקטורה שמאחורי מאזין לתמונת מצב:
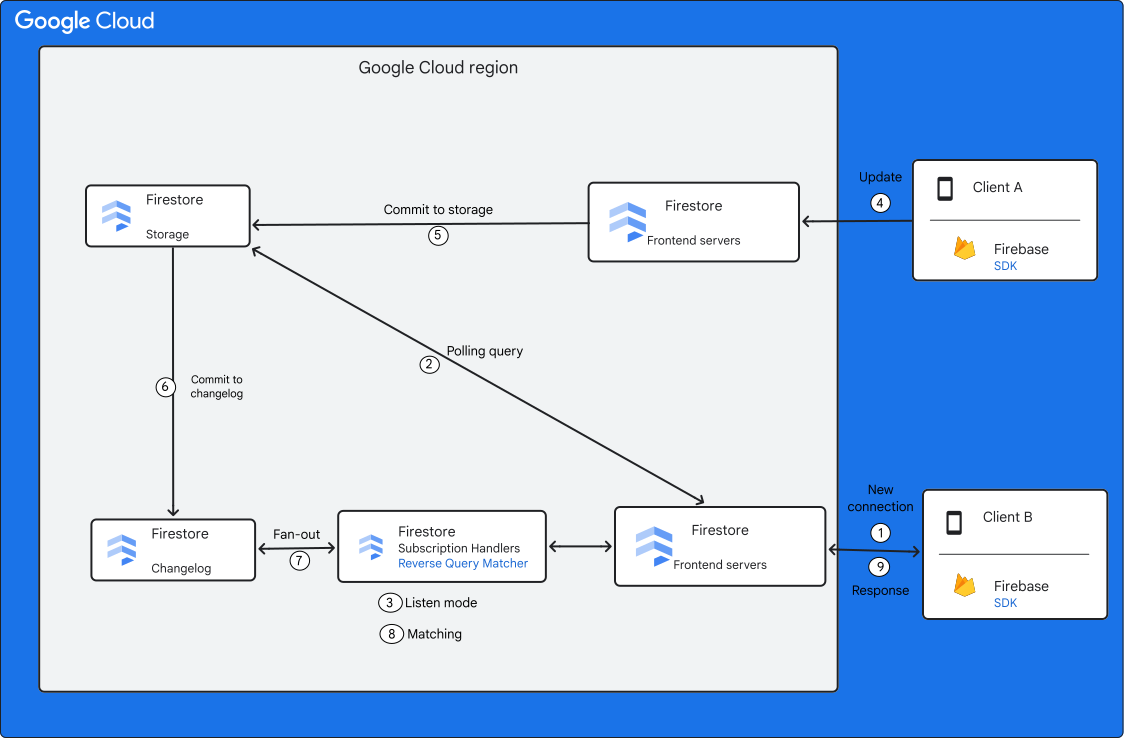
רצף האירועים הבא מתרחש כשלקוח ב' מחבר מאזין של תמונת מצב למסד הנתונים:
- לקוח ב' פותח חיבור אל Cloud Firestore ורושם מאזין באמצעות קריאה ל-
onSnapshot(collection("chatroom"))דרך Firebase SDK. המאזין הזה יכול להישאר פעיל במשך שעות. - ממשק ה-frontend של Cloud Firestore שולח שאילתות למערכת האחסון הבסיסית כדי לאתחל את מערך הנתונים. הוא טוען את כל קבוצת התוצאות של המסמכים התואמים. אנחנו קוראים לזה שאילתת דגימה. לאחר מכן המערכת מעריכה את כללי האבטחה של Firebase במסד הנתונים כדי לוודא שהמשתמש יכול לגשת לנתונים האלה. אם המשתמש מורשה, מסד הנתונים מחזיר את הנתונים למשתמש.
- השאילתה של לקוח ב' עוברת למצב האזנה. המאזין נרשם באמצעות handler של מינויים וממתין לעדכונים בנתונים.
- עכשיו לקוח א' שולח פעולת כתיבה כדי לשנות מסמך.
- מסד הנתונים שומר את השינוי במסמך במערכת האחסון שלו.
- המערכת מבצעת את אותו עדכון ביומן שינויים פנימי. יומן השינויים קובע סדר קפדני של השינויים לפי זמן ההתרחשות שלהם.
- יומן השינויים מעביר את הנתונים המעודכנים למאגר של רכיבי handler של מינויים.
- התאמת שאילתה הפוכה מופעלת כדי לבדוק אם המסמך המעודכן תואם למאזינים של תמונת המצב שרשומים כרגע. בדוגמה הזו, המסמך תואם למאזין לתמונת המצב של לקוח ב'. כמו שהשם מרמז, אפשר לחשוב על התאמת שאילתות הפוכה כשאילתה רגילה במסד נתונים, אבל בסדר הפוך. במקום לחפש במסמכים כדי למצוא את אלה שתואמים לשאילתה, הוא מחפש ביעילות בשאילתות כדי למצוא את אלה שתואמות למסמך נכנס. כשהמערכת מוצאת התאמה, היא מעבירה את המסמך הרלוונטי למאזינים של תמונת המצב. לאחר מכן, המערכת בודקת את כללי האבטחה של Firebase במסד הנתונים כדי לוודא שרק משתמשים מורשים מקבלים את הנתונים.
- המערכת מעבירה את עדכון המסמך ל-SDK במכשיר של לקוח ב', והקריאה החוזרת (callback) של
onSnapshotמופעלת. אם מופעלת שמירה מקומית, ה-SDK מחיל את העדכון גם על המטמון המקומי.
חלק מרכזי ביכולת ההתאמה של Cloud Firestore לעומס תלוי בפיצול (fan-out) מיומן השינויים למטפלים במינויים ולשרתי החזית. ה-fan-out מאפשר לשינוי נתונים יחיד להתפשט ביעילות כדי לשרת מיליוני שאילתות בזמן אמת ומשתמשים מחוברים. כדי להשיג זמינות גבוהה ויכולת התאמה, ב-Cloud Firestore מריצים הרבה רפליקות של כל הרכיבים האלה בכמה אזורים (או בכמה אזורים במקרה של פריסה במספר אזורים).
חשוב לציין שכל פעולות הקריאה שמונפקות מערכות SDK לנייד ולאינטרנט פועלות לפי המודל שלמעלה. הם מבצעים שאילתת דגימה ואחריה מצב האזנה כדי לשמור על עקביות. זה נכון גם לגבי מאזינים בזמן אמת, קריאות לאחזור מסמך ושאילתות חד-פעמיות. אפשר לחשוב על שליפת מסמך יחיד ועל שאילתות חד-פעמיות כמאזינים לתמונות מצב לטווח קצר, עם אילוצים דומים לגבי הביצועים.
שיטות מומלצות להרחבת שאילתות בזמן אמת
כדי לתכנן שאילתות בזמן אמת שניתנות להתאמה לעומס, כדאי ליישם את השיטות המומלצות הבאות.
הסבר על תנועת כתיבה גבוהה במערכת
בקטע הזה נסביר איך המערכת מגיבה למספר הולך וגדל של בקשות כתיבה.
יומני השינויים של Cloud Firestore שמפעילים את השאילתות בזמן אמת מותאמים אוטומטית לעומס (autoscaling) באופן אופקי ככל שתנועת הכתיבה גדלה. ככל שקצב הכתיבה במסד נתונים עולה מעבר למה ששרת אחד יכול לטפל בו, יומן השינויים מפוצל בין כמה שרתים, ועיבוד השאילתות מתחיל לצרוך נתונים מכמה רכיבי טיפול במינויים במקום מאחד. מנקודת המבט של הלקוח ושל ה-SDK, הכל שקוף ולא נדרשת שום פעולה מהאפליקציה כשהפיצולים מתרחשים. התרשים הבא מדגים איך מתבצעת התאמה לעומס (scaling) של שאילתות בזמן אמת:

התאמה אוטומטית לעומס (automatic scaling) מאפשרת להגדיל את תנועת הכתיבה ללא הגבלה, אבל ככל שהתנועה גדלה, יכול להיות שלמערכת ייקח זמן להגיב. כדי להימנע מיצירת נקודה חמה לכתיבה, כדאי לפעול לפי ההמלצות של כלל 5-5-5. Key Visualizer הוא כלי שימושי לניתוח נקודות חמות של כתיבה.
לאפליקציות רבות יש צמיחה אורגנית צפויה, ש-Cloud Firestore יכולה להתמודד איתה בלי אמצעי זהירות. עם זאת, עומסי עבודה באצווה, כמו ייבוא של קבוצת נתונים גדולה, יכולים להגדיל את מספר פעולות הכתיבה מהר מדי. כשאתם מתכננים את האפליקציה, חשוב שתהיו מודעים למקור של תנועת הכתיבה.
איך פעולות כתיבה וקריאה פועלות יחד
אפשר לחשוב על מערכת השאילתות בזמן אמת כצינור שמחבר בין פעולות כתיבה לבין קוראים. בכל פעם שנוצר, מתעדכן או נמחק מסמך, השינוי מופץ ממערכת האחסון למאזינים שרשומים כרגע. מבנה יומן השינויים של Cloud Firestore מבטיח עקביות חזקה, כלומר האפליקציה אף פעם לא מקבלת התראות על עדכונים שלא תואמים לסדר שבו מסד הנתונים ביצע את השינויים בנתונים. כך פיתוח האפליקציות פשוט יותר, כי אין צורך להתמודד עם מקרי קצה שקשורים לעקביות הנתונים.
הצינור המקושר הזה אומר שפעולת כתיבה שגורמת לנקודות חמות או לתחרות על נעילה יכולה להשפיע לרעה על פעולות קריאה. כשפעולות כתיבה נכשלות או מוגבלות, יכול להיות שפעולת קריאה תתעכב בזמן שהיא ממתינה לנתונים עקביים מיומן השינויים. אם זה קורה באפליקציה, יכול להיות שתראו גם פעולות כתיבה איטיות וגם זמני תגובה איטיים לשאילתות. כדי להימנע מהבעיה הזו, חשוב לא להשאיר את המכשיר במקומות חמים.
שמירה על מסמכים ופעולות כתיבה קטנות
כשמפתחים אפליקציות עם מאזינים לתמונות מצב, בדרך כלל רוצים שהמשתמשים יקבלו מידע על שינויים בנתונים במהירות. כדי להשיג את זה, כדאי לנסות לשמור על דברים קטנים. המערכת יכולה להעביר מסמכים קטנים עם עשרות שדות במהירות רבה. מסמכים גדולים יותר עם מאות שדות ונתונים רבים דורשים יותר זמן עיבוד.
באופן דומה, כדאי להעדיף פעולות קצרות ומהירות של ביצוע שינויים וכתיבה כדי לשמור על זמן אחזור קצר. אצוות גדולות עשויות להגדיל את התפוקה מנקודת המבט של הכותב, אבל הן עלולות להאריך את זמן ההתראה למאזינים של תמונת המצב. זה לעיתים קרובות מנוגד לאינטואיציה בהשוואה לשימוש במערכות אחרות של מסדי נתונים, שבהן אפשר להשתמש באצווה כדי לשפר את הביצועים.
שימוש במאזינים יעילים
ככל שקצב הכתיבה במסד הנתונים עולה, Cloud Firestore מפצל את עיבוד הנתונים בין שרתים רבים. אלגוריתם הפיצול של Cloud Firestore מנסה למקם יחד נתונים מאותו אוסף או מאותה קבוצת אוספים באותו שרת של יומן שינויים. המערכת מנסה למקסם את קצב העברת הנתונים האפשרי של הכתיבה, תוך שמירה על מספר נמוך ככל האפשר של שרתים שמעורבים בעיבוד של שאילתה.
עם זאת, דפוסים מסוימים עדיין עלולים להוביל להתנהגות לא אופטימלית של מאזינים לתמונות מצב. לדוגמה, אם האפליקציה מאחסנת את רוב הנתונים שלה באוסף אחד גדול, יכול להיות שהמאזין יצטרך להתחבר לשרתים רבים כדי לקבל את כל הנתונים שהוא צריך. התנאי הזה חל גם אם מפעילים מסנן שאילתות. חיבור לשרתים רבים מגדיל את הסיכון לתגובות איטיות יותר.
כדי למנוע את התגובות האיטיות האלה, תכננו את הסכימה והאפליקציה כך שהמערכת תוכל לשרת מאזינים בלי לעבור בין הרבה שרתים שונים. יכול להיות שעדיף לפצל את הנתונים לאוספים קטנים יותר עם קצבי כתיבה קטנים יותר.
זה דומה לחשיבה על שאילתות ביצועים במסד נתונים רלציוני שדורשות סריקות מלאות של הטבלה. במסד נתונים רלציוני, שאילתה שדורשת סריקה מלאה של הטבלה מקבילה למאזין לתמונת מצב שצופה באוסף עם שיעור נטישה גבוה. היא עשויה לפעול לאט בהשוואה לשאילתה שמסד הנתונים יכול להציג באמצעות אינדקס ספציפי יותר. שאילתה עם אינדקס ספציפי יותר דומה למאזין לתמונת מצב שצופה במסמך יחיד או באוסף שמשתנה בתדירות נמוכה יותר. כדאי לבצע בדיקת עומסים באפליקציה כדי להבין טוב יותר את ההתנהגות והצרכים של התרחיש לדוגמה שלכם.
שמירה על מהירות השאילתות לדגימה
חלק חשוב נוסף בשאילתות רספונסיביות בזמן אמת הוא לוודא ששאילתת הסקר לאתחול הנתונים מהירה ויעילה. בפעם הראשונה שמאזין חדש לתמונת מצב מתחבר, הוא צריך לטעון את כל קבוצת התוצאות ולשלוח אותה למכשיר של המשתמש. שאילתות איטיות גורמות לאפליקציה להגיב לאט יותר. לדוגמה, שאילתות שמנסות לקרוא מסמכים רבים או שאילתות שלא משתמשות באינדקסים המתאימים.
בנסיבות מסוימות, מאזין יכול גם לחזור ממצב האזנה למצב דגימה. התהליך הזה מתרחש באופן אוטומטי והוא שקוף לערכות ה-SDK ולאפליקציה. התנאים הבאים עשויים להפעיל מצב דגימה:
- המערכת מאזנת מחדש את יומן השינויים בגלל שינויים בעומס.
- נקודות חמות גורמות לכשלים או לעיכובים בכתיבה למסד הנתונים.
- הפעלה מחדש של שרת זמני משפיעה באופן זמני על המאזינים.
אם שאילתות הסקר מהירות מספיק, מצב הסקר הופך לשקוף למשתמשי האפליקציה.
העדפת מאזינים לטווח ארוך
פתיחת מאזינים והשארתם פעילים למשך זמן רב ככל האפשר היא לרוב הדרך החסכונית ביותר ליצור אפליקציה שמשתמשת ב-Cloud Firestore. כשמשתמשים ב-Cloud Firestore, החיוב הוא על המסמכים שמוחזרים לאפליקציה ולא על שמירת החיבור פתוח. מאזין לתמונת מצב שפועל לאורך זמן קורא רק את הנתונים שדרושים לו כדי להציג את השאילתה במהלך כל משך החיים שלו. הפעולה הזו כוללת פעולת דגימה ראשונית, ואחריה התראות כשהנתונים משתנים בפועל. לעומת זאת, שאילתות חד-פעמיות קוראות מחדש נתונים שאולי לא השתנו מאז שהאפליקציה הריצה את השאילתה בפעם האחרונה.
במקרים שבהם האפליקציה צריכה לצרוך קצב גבוה של נתונים, יכול להיות שמאזינים לתמונת מצב לא יתאימו. לדוגמה, אם בתרחיש לדוגמה שלכם נשלחים מסמכים רבים בשנייה דרך חיבור למשך פרק זמן ארוך, יכול להיות שעדיף לבחור בשאילתות חד-פעמיות שפועלות בתדירות נמוכה יותר.