

В этом документе вы найдете рекомендации по масштабированию бессерверного приложения, которое обрабатывает тысячи операций в секунду или сотни тысяч одновременных пользователей. В этом документе рассматриваются дополнительные темы, которые помогут вам лучше понять систему. Если вы только начинаете работать с Cloud Firestore, ознакомьтесь с кратким руководством.
Cloud Firestore и Firebase SDK для мобильных и веб-приложений предоставляют мощную модель для разработки бессерверных приложений, в которых клиентский код напрямую обращается к базе данных. SDK позволяют клиентам отслеживать обновления данных в реальном времени. Обновления в реальном времени позволяют создавать адаптивные приложения, не требующие серверной инфраструктуры. Хотя запустить приложение очень просто, полезно понимать ограничения систем, из которых состоит Cloud Firestore. Это поможет вам обеспечить масштабируемость и высокую производительность вашего бессерверного приложения при увеличении трафика.
Ниже приведены советы по масштабированию приложения.
Выберите местоположение базы данных, близкое к вашим пользователям
На схеме ниже показана архитектура приложения, работающего в реальном времени.
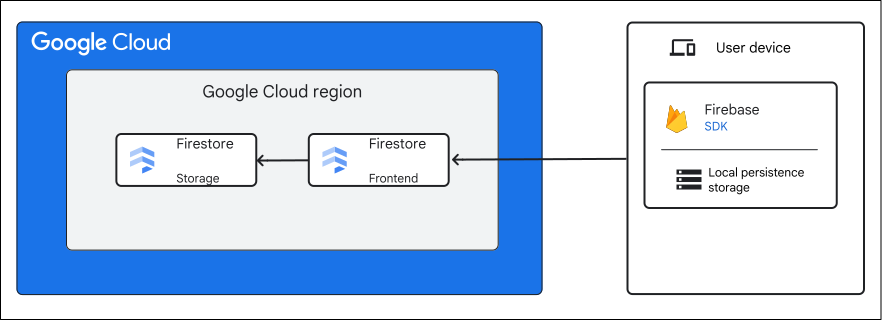
Когда приложение, запущенное на устройстве пользователя (мобильном или веб-устройстве), устанавливает подключение к Cloud Firestore, подключение направляется на внешний сервер Cloud Firestore в том же регионе, где находится ваша база данных. Например, если ваша база данных находится в регионе us-east1, подключение также будет установлено с интерфейсом Cloud Firestore в регионе us-east1. Эти подключения являются долгосрочными и остаются открытыми, пока приложение не закроет их явным образом. Фронтенд считывает данные из базовых систем хранения Cloud Firestore.
Расстояние между физическим местоположением пользователя и местоположением базы данных Cloud Firestore влияет на задержку, с которой сталкивается пользователь. Например, если пользователь находится в Индии, а база данных приложения – в регионе Google Cloud в Северной Америке, то приложение может работать медленнее, чем если бы база данных находилась ближе, например в Индии или другой части Азии.
Надежность
На надежность приложения влияют следующие факторы:
Включить офлайн-режим
Firebase SDK обеспечивает сохранение офлайн-данных. Если приложение на устройстве пользователя не может подключиться к Cloud Firestore, оно продолжает работать с локально кешированными данными. Это обеспечивает доступ к данным, даже если у пользователей нестабильное подключение к интернету или они полностью теряют доступ на несколько часов или дней. Подробнее о включении офлайн-режима…
Как работают автоматические повторные попытки
Firebase SDK берет на себя повторные попытки выполнения операций и восстановление разорванных соединений. Это помогает обойти временные ошибки, вызванные перезапуском серверов или проблемами с сетью между клиентом и базой данных.
Выберите региональное или мультирегиональное местоположение
При выборе между региональным и мультирегиональным местоположением необходимо учитывать несколько факторов. Основное различие заключается в способе репликации данных. От этого зависит доступность вашего приложения. Экземпляр в нескольких регионах обеспечивает более высокую надежность обслуживания и увеличивает долговечность ваших данных, но стоит дороже.
Как работает система запросов в реальном времени
Запросы в реальном времени, также называемые прослушивателями снимков, позволяют приложению отслеживать изменения в базе данных и получать уведомления с низкой задержкой, как только данные меняются. Приложение может получить тот же результат, периодически опрашивая базу данных на предмет обновлений, но это часто происходит медленнее, дороже и требует больше кода. Примеры настройки и использования запросов в реальном времени приведены в разделе Получение обновлений в реальном времени. В следующих разделах подробно рассказывается о том, как работают прослушиватели снимков, и описываются некоторые из лучших практик масштабирования запросов в реальном времени с сохранением производительности.
Представьте двух пользователей, которые подключаются к Cloud Firestore через приложение для обмена сообщениями, созданное с помощью одного из мобильных SDK.
Клиент А записывает данные в базу данных, чтобы добавить и обновить документы в коллекции chatroom:
collection chatroom:
    document message1:
      from: 'Sparky'
      message: 'Welcome to Cloud Firestore!'

    document message2:
      from: 'Santa'
      message: 'Presents are coming'
Клиент B прослушивает обновления в той же коллекции, используя прослушиватель снимков. Клиент Б получает уведомление сразу же, как только кто-то создает новое сообщение. На следующей диаграмме показана архитектура прослушивателя снимков:
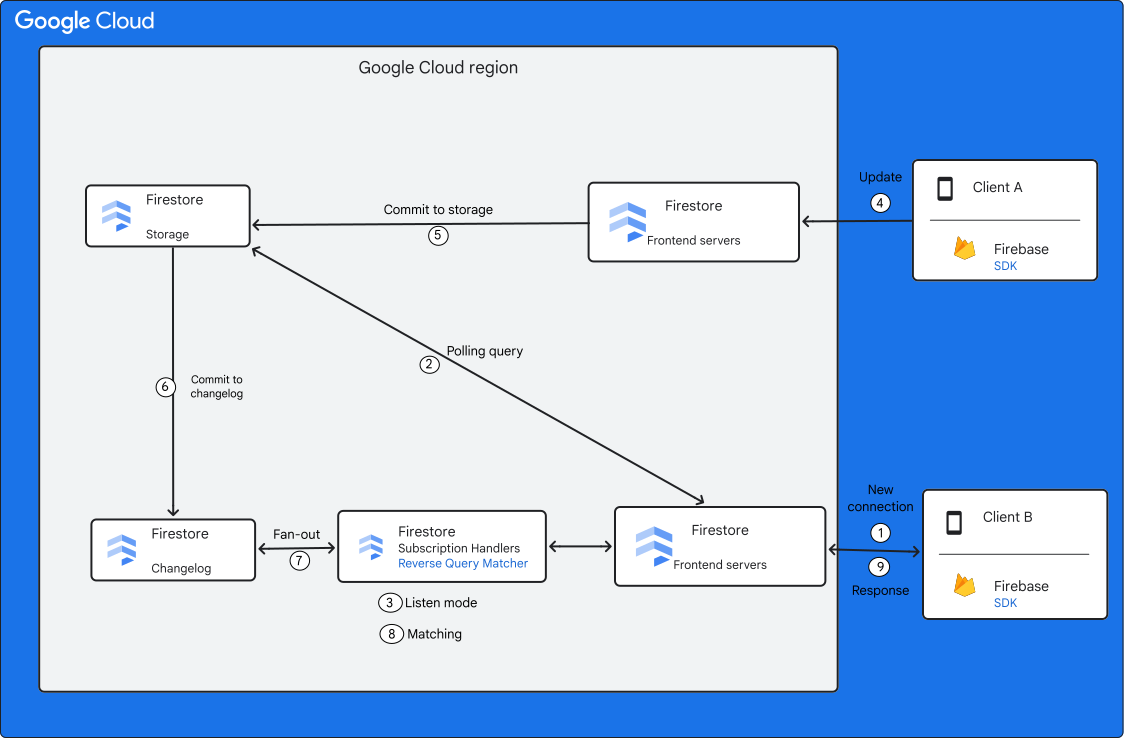
Когда клиент B подключает к базе данных прослушиватель снимков, происходит следующее:
- Клиент Б открывает подключение к Cloud Firestore и регистрирует прослушиватель, вызывая
onSnapshot(collection("chatroom"))через Firebase SDK. Этот прослушиватель может оставаться активным в течение нескольких часов. - Фронтенд Cloud Firestore запрашивает у базовой системы хранения данных набор данных для начальной загрузки. Он загружает весь набор результатов, состоящий из соответствующих документов. Такой запрос называется опросным. Затем система оценивает правила безопасности Firebase для базы данных, чтобы убедиться, что у пользователя есть доступ к этим данным. Если пользователь авторизован, база данных возвращает ему данные.
- Затем запрос клиента Б переходит в режим прослушивания. Прослушиватель регистрируется в обработчике подписки и ожидает обновления данных.
- Клиент А отправляет операцию записи, чтобы изменить документ.
- База данных фиксирует изменение документа в своей системе хранения.
- Система фиксирует это изменение во внутреннем журнале изменений. Журнал изменений устанавливает строгий порядок изменений по мере их возникновения.
- Журнал изменений, в свою очередь, передает обновленные данные в пул обработчиков подписок.
- Выполняется обратное сопоставление запросов, чтобы проверить, соответствует ли обновленный документ каким-либо зарегистрированным в настоящее время прослушивателям снимков. В этом примере документ соответствует слушателю снимков клиента B. Как следует из названия, сопоставитель обратных запросов можно рассматривать как обычный запрос к базе данных, но выполняемый в обратном порядке. Вместо того чтобы искать документы, соответствующие запросу, он ищет запросы, соответствующие входящему документу. При обнаружении совпадения система пересылает документ слушателям снимков. Затем система оценивает правила безопасности Firebase для базы данных, чтобы убедиться, что данные получают только авторизованные пользователи.
- Система передает обновленный документ в SDK на устройстве клиента Б, и срабатывает обратный вызов
onSnapshot. Если включено локальное сохранение, SDK также применяет обновление к локальному кешу.
Масштабируемость Cloud Firestore во многом зависит от разветвления, которое происходит при передаче данных из журнала изменений обработчикам подписок и серверам интерфейса. Благодаря этому одно изменение данных может эффективно распространяться для обслуживания миллионов запросов в реальном времени и подключенных пользователей. Запуская множество реплик всех этих компонентов в нескольких зонах (или нескольких регионах в случае мультирегионального развертывания), Cloud Firestore достигает высокой доступности и масштабируемости.
Стоит отметить, что все операции чтения, выполняемые из SDK для мобильных устройств и веб-приложений, следуют описанной выше модели. Они выполняют опросный запрос, а затем переходят в режим прослушивания, чтобы гарантировать согласованность. Это также относится к прослушивателям в реальном времени, вызовам для получения документа и однократным запросам. Вы можете думать об извлечении отдельных документов и однократных запросах как о кратковременных прослушивателях снимков, которые имеют аналогичные ограничения по производительности.
Рекомендации по масштабированию запросов в реальном времени
Чтобы создавать масштабируемые запросы в реальном времени, следуйте приведенным ниже рекомендациям.
Как понять, что в системе высокий трафик записи
В этом разделе рассказывается, как система реагирует на увеличение количества запросов на запись.
Журналы изменений Cloud Firestore, которые управляют запросами в реальном времени, автоматически масштабируются по горизонтали по мере увеличения трафика записи. Если скорость записи в базу данных превышает возможности одного сервера, журнал изменений распределяется между несколькими серверами, а обработка запросов начинает использовать данные из нескольких обработчиков подписок вместо одного. С точки зрения клиента и SDK это происходит незаметно, и при разделении от приложения не требуется никаких действий. На следующей диаграмме показано, как масштабируются запросы в реальном времени:
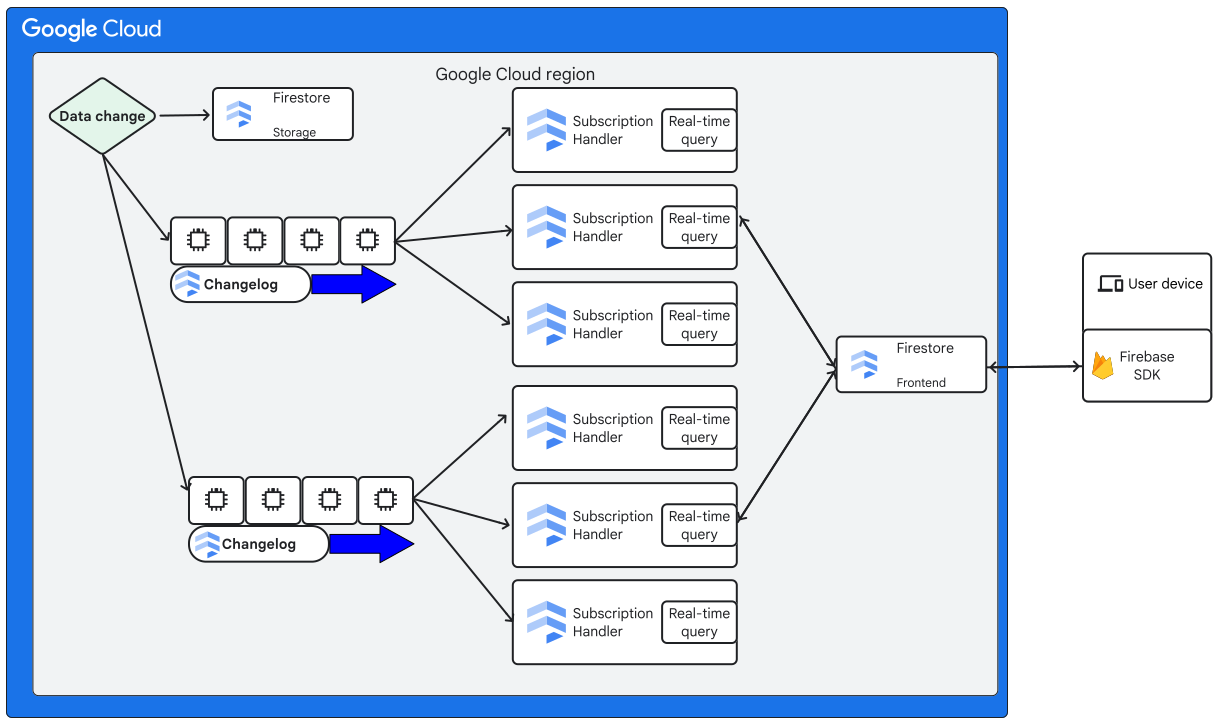
Автоматическое масштабирование позволяет увеличивать трафик записи без ограничений, но по мере его роста системе может потребоваться некоторое время для ответа. Чтобы избежать создания горячей точки записи, следуйте рекомендациям правила 5-5-5. Key Visualizer – полезный инструмент для анализа горячих точек записи.
Многие приложения имеют предсказуемый органический рост, который Cloud Firestore может обеспечить без мер предосторожности. Однако пакетные рабочие нагрузки, такие как импорт большого набора данных, могут слишком быстро увеличить количество операций записи. При разработке приложения следите за тем, откуда поступает трафик записи.
Как взаимодействуют операции чтения и записи
Систему запросов в реальном времени можно представить как конвейер, соединяющий операции записи с читателями. При создании, обновлении или удалении документа изменения передаются из системы хранения в зарегистрированные прослушиватели. Структура журнала изменений Cloud Firestore гарантирует полную согласованность. Это значит, что ваше приложение никогда не будет получать уведомления об обновлениях, которые не соответствуют порядку, в котором база данных зафиксировала изменения данных. Это упрощает разработку приложений, устраняя пограничные случаи, связанные с согласованностью данных.
Это означает, что операция записи, вызывающая появление горячих точек или конфликты блокировок, может негативно повлиять на операции чтения. Если операции записи завершаются сбоем или регулируются, чтение может приостановиться в ожидании согласованных данных из журнала изменений. Если это происходит в вашем приложении, вы можете увидеть как медленные операции записи, так и связанные с ними медленные ответы на запросы. Чтобы избежать этой проблемы, не используйте точки доступа.
Документы и операции записи должны быть небольшими
При создании приложений со слушателями снимков вы обычно хотите, чтобы пользователи быстро узнавали об изменениях данных. Чтобы добиться этого, старайтесь делать вещи маленькими. Система может очень быстро обрабатывать небольшие документы с десятками полей. Обработка больших документов с сотнями полей и большим объемом данных занимает больше времени.
Аналогично, отдавайте предпочтение коротким и быстрым операциям фиксации и записи, чтобы задержка была низкой. Большие пакеты могут обеспечить более высокую пропускную способность с точки зрения записи, но могут увеличить время уведомления для слушателей снимков. Это может показаться нелогичным, если вы привыкли к другим системам баз данных, где пакетная обработка используется для повышения производительности.
Используйте эффективные прослушиватели
По мере увеличения скорости записи в базу данных Cloud Firestore распределяет обработку данных между несколькими серверами. Алгоритм сегментирования Cloud Firestore пытается разместить данные из одной коллекции или группы коллекций на одном сервере журнала изменений. Система пытается максимально увеличить пропускную способность записи, сохраняя при этом как можно меньшее количество серверов, участвующих в обработке запроса.
Однако определенные шаблоны все равно могут привести к неоптимальному поведению слушателей снимков. Например, если ваше приложение хранит большую часть своих данных в одной большой коллекции, слушателю может потребоваться подключиться ко многим серверам, чтобы получить все необходимые данные. Это правило действует, даже если вы применяете фильтр запросов. Подключение к большому количеству серверов увеличивает риск задержки ответов.
Чтобы избежать задержек, разработайте схему и приложение так, чтобы система могла обслуживать слушателей без обращения к множеству разных серверов. Возможно, вам будет удобнее разбить данные на несколько коллекций с меньшей частотой записи.
Это похоже на запросы производительности в реляционной базе данных, которые требуют полного сканирования таблицы. В реляционной базе данных запрос, требующий полного сканирования таблицы, эквивалентен прослушивателю снимков, который отслеживает коллекцию с высокой текучестью. Он может выполняться медленнее, чем запрос, который база данных может обработать с помощью более конкретного индекса. Запрос с более конкретным индексом похож на прослушиватель снимков, который отслеживает один документ или коллекцию, которая меняется реже. Чтобы лучше понять поведение и потребности вашего приложения, проведите нагрузочное тестирование.
Обеспечьте высокую скорость выполнения запросов на опрос
Ещё один важный аспект работы с запросами в реальном времени – обеспечение быстрого и эффективного выполнения запроса на получение данных. При первом подключении нового прослушивателя снимков он должен загрузить весь набор результатов и отправить его на устройство пользователя. Медленные запросы снижают скорость отклика приложения. Например, это могут быть запросы, которые пытаются прочитать много документов или не используют подходящие индексы.
В некоторых случаях слушатель может вернуться из состояния прослушивания в состояние опроса. Это происходит автоматически и незаметно для SDK и вашего приложения. Переход в режим опроса может быть вызван следующими причинами:
- Система перераспределяет журнал изменений из-за изменений в нагрузке.
- Из-за горячих точек запись в базу данных может выполняться с задержкой или сбоем.
- Перезапуск сервера временно влияет на прослушиватели.
Если запросы выполняются достаточно быстро, пользователи не заметят задержки.
Отдавайте предпочтение долгоживущим прослушивателям
Открытие и поддержание активности слушателей как можно дольше часто является наиболее экономически эффективным способом создания приложения, использующего Cloud Firestore. При использовании Cloud Firestore вы платите за документы, возвращенные в приложение, а не за поддержание открытого подключения. Долгоживущий прослушиватель снимков считывает только те данные, которые ему нужны для обработки запроса в течение всего времени его существования. Это включает в себя начальную операцию опроса, за которой следуют уведомления, когда данные действительно изменяются. При однократных запросах данные считываются повторно, даже если они не изменились с момента последнего выполнения запроса.
Если ваше приложение должно потреблять большой объем данных, прослушиватели снимков могут не подойти. Например, если вы передаете много документов в секунду через одно подключение в течение длительного времени, лучше использовать однократные запросы, которые выполняются реже.
Что дальше
- Подробнее о том, как использовать прослушиватели снимков…
- Ознакомьтесь с другими рекомендациями.