

Interfejs Codable API, wprowadzony w Swift 4, umożliwia wykorzystanie możliwości kompilatora do łatwiejszego mapowania danych z formatów zserializowanych na typy Swift.
Być może używasz protokołu Codable do mapowania danych z internetowego interfejsu API na model danych aplikacji (i odwrotnie), ale jest on znacznie bardziej elastyczny.
W tym przewodniku przyjrzymy się, jak można używać protokołu Codable do mapowania danych z Cloud Firestore na typy Swift i odwrotnie.
Podczas pobierania dokumentu z Cloud Firestore aplikacja otrzyma słownik par klucz-wartość (lub tablicę słowników, jeśli używasz jednej z operacji zwracających wiele dokumentów).
Możesz oczywiście nadal bezpośrednio używać słowników w języku Swift. Zapewniają one dużą elastyczność, która może być dokładnie tym, czego potrzebujesz. To podejście nie jest jednak bezpieczne pod względem typów i łatwo wprowadzić trudne do wykrycia błędy, błędnie wpisując nazwy atrybutów lub zapominając o zmapowaniu nowego atrybutu dodanego przez zespół podczas wdrażania nowej funkcji w zeszłym tygodniu.
W przeszłości wielu deweloperów radziło sobie z tymi niedociągnięciami, wdrażając prostą warstwę mapowania, która umożliwiała mapowanie słowników na typy Swift. Jednak większość tych implementacji opiera się na ręcznym określaniu mapowania między dokumentami Cloud Firestore a odpowiednimi typami modelu danych aplikacji.
Dzięki obsłudze interfejsu Codable API języka Swift w Cloud Firestore jest to znacznie łatwiejsze:
- Nie musisz już ręcznie implementować kodu mapowania.
- Możesz łatwo określić, jak mapować atrybuty o różnych nazwach.
- Ma wbudowaną obsługę wielu typów Swift.
- Można też łatwo dodać obsługę mapowania typów niestandardowych.
- Co najlepsze, w przypadku prostych modeli danych nie musisz pisać żadnego kodu mapowania.
Mapowanie danych
Cloud Firestore przechowuje dane w dokumentach, które mapują klucze na wartości. Aby pobrać dane z pojedynczego dokumentu, możemy wywołać funkcję DocumentSnapshot.data(), która zwraca słownik mapujący nazwy pól na Any: func data() -> [String : Any]?.
Oznacza to, że możemy używać składni indeksu dolnego Swift, aby uzyskać dostęp do poszczególnych pól.
import FirebaseFirestore

#warning("DO NOT MAP YOUR DOCUMENTS MANUALLY. USE CODABLE INSTEAD.")
func fetchBook(documentId: String) {
  let docRef = db.collection("books").document(documentId)

  docRef.getDocument { document, error in
    if let error = error as NSError? {
      self.errorMessage = "Error getting document: \(error.localizedDescription)"
    }
    else {
      if let document = document {
        let id = document.documentID
        let data = document.data()
        let title = data?["title"] as? String ?? ""
        let numberOfPages = data?["numberOfPages"] as? Int ?? 0
        let author = data?["author"] as? String ?? ""
        self.book = Book(id:id, title: title, numberOfPages: numberOfPages, author: author)
      }
    }
  }
}
Chociaż może się wydawać, że jest to proste i łatwe do wdrożenia, ten kod jest niestabilny, trudny w utrzymaniu i podatny na błędy.
Jak widać, przyjmujemy założenia dotyczące typów danych pól dokumentu. Mogą one być poprawne lub nie.
Pamiętaj, że ponieważ nie ma schematu, możesz łatwo dodać nowy dokument do kolekcji i wybrać inny typ pola. Możesz przypadkowo wybrać ciąg znaków dla pola numberOfPages, co spowoduje trudny do znalezienia problem z mapowaniem. Poza tym musisz aktualizować kod mapowania za każdym razem, gdy dodajesz nowe pole, co jest dość uciążliwe.
Nie zapominajmy też, że nie wykorzystujemy silnego systemu typów Swift, który dokładnie zna prawidłowy typ każdej właściwości Book.
Czym właściwie jest Codable?
Zgodnie z dokumentacją Apple Codable to „typ, który może przekonwertować się na reprezentację zewnętrzną i z powrotem”. W rzeczywistości Codable to alias typu dla protokołów Encodable i Decodable. Dzięki dostosowaniu typu Swift do tego protokołu kompilator zsyntetyzuje kod potrzebny do zakodowania/zdekodowania instancji tego typu z formatu zserializowanego, takiego jak JSON.
Prosty typ do przechowywania danych o książce może wyglądać tak:
struct Book: Codable {
  var title: String
  var numberOfPages: Int
  var author: String
}
Jak widać, dostosowanie typu do protokołu Codable jest minimalnie inwazyjne. Musieliśmy tylko dodać zgodność z protokołem. Żadne inne zmiany nie były wymagane.
Teraz możemy łatwo zakodować książkę w obiekcie JSON:
do {
  let book = Book(title: "The Hitchhiker's Guide to the Galaxy",
                  numberOfPages: 816,
                  author: "Douglas Adams")
  let encoder = JSONEncoder()
  let data = try encoder.encode(book)
}
catch {
  print("Error when trying to encode book: \(error)")
}
Dekodowanie obiektu JSON do instancji Book działa w ten sposób:
let decoder = JSONDecoder()
let data = /* fetch data from the network */
let decodedBook = try decoder.decode(Book.self, from: data)
Mapowanie na proste typy i z prostych typów w dokumentach Cloud Firestore za pomocą Codable
Cloud Firestore obsługuje szeroki zakres typów danych, od prostych ciągów znaków po zagnieżdżone mapy. Most of these correspond directly to Swift's built-in types. Zanim przejdziemy do bardziej złożonych typów danych, przyjrzyjmy się mapowaniu kilku prostych typów.
Aby zmapować dokumenty Cloud Firestore na typy Swift, wykonaj te czynności:
- Upewnij się, że do projektu dodano platformę
FirebaseFirestore. Możesz to zrobić za pomocą narzędzia Swift Package Manager lub CocoaPods. - Zaimportuj
FirebaseFirestoredo pliku Swift. - Dostosuj typ do
Codable. - (Opcjonalnie, jeśli chcesz używać typu w widoku
List) Dodaj do typu właściwośćidi użyj@DocumentID, aby poinformować Cloud Firestore, że ma to zostać zmapowane na identyfikator dokumentu. Poniżej omówimy to bardziej szczegółowo. - Użyj
documentReference.data(as: ), aby zmapować odwołanie do dokumentu na typ Swift. - Użyj
documentReference.setData(from: ), aby zmapować dane z typów Swift na dokument Cloud Firestore. - (Opcjonalnie, ale zdecydowanie zalecane) Wdróż prawidłową obsługę błędów.
Zaktualizujmy odpowiednio typ Book:
struct Book: Codable {
  @DocumentID var id: String?
  var title: String
  var numberOfPages: Int
  var author: String
}
Ponieważ ten typ był już możliwy do zakodowania, musieliśmy tylko dodać właściwość id i opatrzyć ją adnotacją za pomocą opakowania właściwości @DocumentID.
Jeśli weźmiemy poprzedni fragment kodu do pobierania i mapowania dokumentu, możemy zastąpić cały kod mapowania ręcznego jedną linijką:
func fetchBook(documentId: String) {
  let docRef = db.collection("books").document(documentId)

  docRef.getDocument { document, error in
    if let error = error as NSError? {
      self.errorMessage = "Error getting document: \(error.localizedDescription)"
    }
    else {
      if let document = document {
        do {
          self.book = try document.data(as: Book.self)
        }
        catch {
          print(error)
        }
      }
    }
  }
}
Możesz to zapisać jeszcze bardziej zwięźle, określając typ dokumentu podczas wywoływania funkcji getDocument(as:). Spowoduje to wykonanie mapowania i zwrócenie typu Result zawierającego zmapowany dokument lub błąd w przypadku niepowodzenia dekodowania:
private func fetchBook(documentId: String) {
  let docRef = db.collection("books").document(documentId)

  docRef.getDocument(as: Book.self) { result in
    switch result {
    case .success(let book):
      // A Book value was successfully initialized from the DocumentSnapshot.
      self.book = book
      self.errorMessage = nil
    case .failure(let error):
      // A Book value could not be initialized from the DocumentSnapshot.
      self.errorMessage = "Error decoding document: \(error.localizedDescription)"
    }
  }
}
Aktualizowanie istniejącego dokumentu jest tak proste jak wywołanie documentReference.setData(from: ). Oto kod, który zapisuje instancję Book, wraz z podstawową obsługą błędów:
func updateBook(book: Book) {
  if let id = book.id {
    let docRef = db.collection("books").document(id)
    do {
      try docRef.setData(from: book)
    }
    catch {
      print(error)
    }
  }
}
Podczas dodawania nowego dokumentu Cloud Firestore automatycznie przypisze mu nowy identyfikator. Działa to nawet wtedy, gdy aplikacja jest offline.
func addBook(book: Book) {
  let collectionRef = db.collection("books")
  do {
    let newDocReference = try collectionRef.addDocument(from: self.book)
    print("Book stored with new document reference: \(newDocReference)")
  }
  catch {
    print(error)
  }
}
Oprócz mapowania prostych typów danych Cloud Firestore obsługuje też wiele innych typów danych, z których niektóre są typami uporządkowanymi, których można używać do tworzenia zagnieżdżonych obiektów w dokumencie.
Zagnieżdżone typy niestandardowe
Większość atrybutów, które chcemy zmapować w naszych dokumentach, to proste wartości, takie jak tytuł książki lub imię i nazwisko autora. Ale co w przypadku, gdy musimy zapisać bardziej złożony obiekt? Możemy na przykład przechowywać adresy URL okładki książki w różnych rozdzielczościach.
Najłatwiejszym sposobem na to w Cloud Firestore jest użycie mapy:

Podczas pisania odpowiedniej struktury Swift możemy wykorzystać fakt, że Cloud Firestore obsługuje adresy URL – gdy przechowujemy pole zawierające adres URL, zostanie ono przekonwertowane na ciąg znaków i odwrotnie:
struct CoverImages: Codable {
  var small: URL
  var medium: URL
  var large: URL
}

struct BookWithCoverImages: Codable {
  @DocumentID var id: String?
  var title: String
  var numberOfPages: Int
  var author: String
  var cover: CoverImages?
}
Zwróć uwagę, że w dokumencie Cloud Firestore zdefiniowaliśmy strukturę CoverImages dla mapy pokrycia. Oznaczając właściwość okładki w BookWithCoverImages jako opcjonalną, możemy obsłużyć fakt, że niektóre dokumenty mogą nie zawierać atrybutu okładki.
Jeśli zastanawiasz się, dlaczego nie ma fragmentu kodu do pobierania lub aktualizowania danych, z przyjemnością informujemy, że nie trzeba dostosowywać kodu do odczytu lub zapisu z/do Cloud Firestore: wszystko działa z kodem, który napisaliśmy w sekcji początkowej.
Tablice
Czasami chcemy przechowywać w dokumencie kolekcję wartości. Dobrym przykładem są gatunki książek: książka taka jak Autostopem przez Galaktykę może należeć do kilku kategorii – w tym przypadku „Sci-Fi” i „Komedia”:

W Cloud Firestore możemy to modelować za pomocą tablicy wartości. Jest to obsługiwane w przypadku dowolnego typu, który można zakodować (np. String, Int itp.). Poniżej pokazujemy, jak dodać tablicę gatunków do modelu Book:
public struct BookWithGenre: Codable {
  @DocumentID var id: String?
  var title: String
  var numberOfPages: Int
  var author: String
  var genres: [String]
}
Ponieważ działa to w przypadku dowolnego typu, który można zakodować, możemy też używać typów niestandardowych. Załóżmy, że chcemy przechowywać listę tagów dla każdej książki. Oprócz nazwy tagu chcemy też przechowywać jego kolor, na przykład w ten sposób:
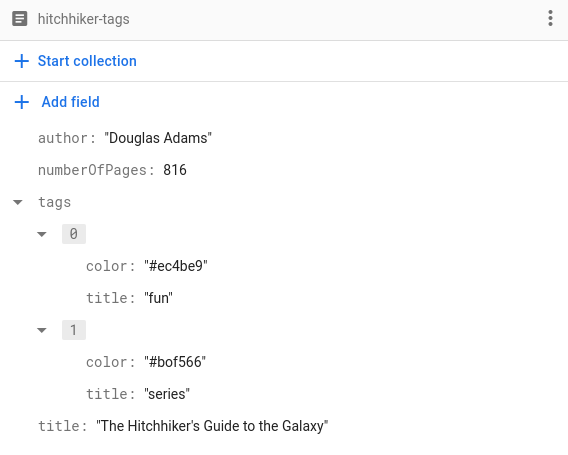
Aby przechowywać tagi w ten sposób, wystarczy zaimplementować strukturę Tag, która będzie reprezentować tag i umożliwi jego kodowanie:
struct Tag: Codable, Hashable {
  var title: String
  var color: String
}
W ten sposób możemy przechowywać tablicę Tags w dokumentach Book.
struct BookWithTags: Codable {
  @DocumentID var id: String?
  var title: String
  var numberOfPages: Int
  var author: String
  var tags: [Tag]
}
Kilka słów o mapowaniu identyfikatorów dokumentów
Zanim przejdziemy do mapowania kolejnych typów, porozmawiajmy przez chwilę o mapowaniu identyfikatorów dokumentów.
W niektórych z poprzednich przykładów użyliśmy opakowania właściwości @DocumentID, aby zmapować identyfikator dokumentu Cloud Firestore na właściwość id naszych typów Swift. Jest to ważne z kilku powodów:
- Dzięki temu wiemy, który dokument zaktualizować, gdy użytkownik wprowadzi zmiany lokalne.
Listw SwiftUI wymaga, aby elementy byłyIdentifiable, co zapobiega ich przeskakiwaniu podczas wstawiania.
Warto zauważyć, że atrybut oznaczony jako @DocumentID nie zostanie zakodowany przez koder Cloud Firestore podczas ponownego zapisywania dokumentu. Dzieje się tak, ponieważ identyfikator dokumentu nie jest atrybutem samego dokumentu, więc zapisanie go w dokumencie byłoby błędem.
Podczas pracy z typami zagnieżdżonymi (takimi jak tablica tagów w Book we wcześniejszym przykładzie w tym przewodniku) nie trzeba dodawać właściwości @DocumentID: właściwości zagnieżdżone są częścią dokumentu Cloud Firestore i nie stanowią osobnego dokumentu. Z tego względu nie potrzebują identyfikatora dokumentu.
Daty i godziny
Cloud Firestore ma wbudowany typ danych do obsługi dat i godzin, a dzięki obsłudze Codable w Cloud Firestore ich używanie jest proste.
Spójrzmy na ten dokument, który reprezentuje matkę wszystkich języków programowania, Adę, wynalezioną w 1843 roku:

Typ Swift do mapowania tego dokumentu może wyglądać tak:
struct ProgrammingLanguage: Codable {
  @DocumentID var id: String?
  var name: String
  var year: Date
}
Nie możemy zakończyć tej sekcji o datach i godzinach bez omówienia @ServerTimestamp. Ten wrapper właściwości jest bardzo przydatny, gdy chodzi o obsługę sygnatur czasowych w aplikacji.
W każdym systemie rozproszonym istnieje prawdopodobieństwo, że zegary poszczególnych systemów nie są przez cały czas w pełni zsynchronizowane. Może się wydawać, że to nic wielkiego, ale wyobraź sobie konsekwencje, jakie może mieć zegar, który nie jest idealnie zsynchronizowany z systemem giełdowym: nawet milisekundowe odchylenie może spowodować różnicę rzędu milionów dolarów podczas realizacji transakcji.
Cloud Firestore obsługuje atrybuty oznaczone jako @ServerTimestamp w następujący sposób: jeśli atrybut ma wartość nil, gdy go przechowujesz (np. za pomocą addDocument()), Cloud Firestore wypełni pole bieżącą sygnaturą czasową serwera w momencie zapisywania go w bazie danych. Jeśli podczas wywoływania metody addDocument() lub updateData() pole nie ma wartości nil, Cloud Firestore nie zmieni wartości atrybutu. Dzięki temu można łatwo wdrożyć pola takie jak createdAt i lastUpdatedAt.
Punkty geograficzne
Geolokalizacja jest powszechnie stosowana w naszych aplikacjach. Dzięki temu możesz korzystać z wielu ciekawych funkcji. Może być na przykład przydatne zapisanie lokalizacji zadania, aby aplikacja mogła przypomnieć o nim, gdy dotrzesz do celu.
Cloud Firestore ma wbudowany typ danych GeoPoint, który może przechowywać długość i szerokość geograficzną dowolnej lokalizacji. Aby zmapować lokalizacje z dokumentu Cloud Firestore lub do niego, możemy użyć typu GeoPoint:
struct Office: Codable {
  @DocumentID var id: String?
  var name: String
  var location: GeoPoint
}
Odpowiedni typ w języku Swift to CLLocationCoordinate2D. Możemy mapować te 2 typy za pomocą tej operacji:
CLLocationCoordinate2D(latitude: office.location.latitude,
                      longitude: office.location.longitude)
Więcej informacji o wysyłaniu zapytań o dokumenty według lokalizacji fizycznej znajdziesz w tym przewodniku po rozwiązaniach.
Wartości w polu enum
Typy wyliczeniowe to prawdopodobnie jedna z najbardziej niedocenianych funkcji języka Swift.
Są znacznie bardziej złożone, niż się wydaje. Typowym zastosowaniem typów wyliczeniowych
jest modelowanie stanów dyskretnych. Możemy na przykład pisać aplikację
do zarządzania artykułami. Aby śledzić stan artykułu, możemy użyć typu wyliczeniowego Status:
enum Status: String, Codable {
  case draft
  case inReview
  case approved
  case published
}
Cloud Firestore nie obsługuje natywnie typów wyliczeniowych (tzn. nie może wymusić zbioru wartości), ale możemy wykorzystać fakt, że typy wyliczeniowe można typować, i wybrać typ, który można zakodować. W tym przykładzie wybraliśmy String, co oznacza, że wszystkie wartości typu wyliczeniowego będą mapowane na ciąg znaków lub z ciągu znaków, gdy będą przechowywane w dokumencie Cloud Firestore.
A ponieważ Swift obsługuje niestandardowe wartości nieprzetworzone, możemy nawet dostosować, które wartości odnoszą się do którego przypadku typu wyliczeniowego. Jeśli na przykład zdecydujemy się zapisać przypadek Status.inReview jako „w trakcie sprawdzania”, możemy po prostu zaktualizować powyższy typ wyliczeniowy w ten sposób:
enum Status: String, Codable {
  case draft
  case inReview = "in review"
  case approved
  case published
}
Dostosowywanie mapowania
Czasami nazwy atrybutów dokumentów Cloud Firestore, które chcemy zmapować, nie pasują do nazw właściwości w naszym modelu danych w Swift. Na przykład jeden z naszych współpracowników może być programistą Pythona i zdecydować się na używanie stylu snake_case we wszystkich nazwach atrybutów.
Nie martw się: Codable ma wszystko, czego potrzebujemy.
W takich przypadkach możemy użyć CodingKeys. Jest to typ wyliczeniowy, który możemy dodać do struktury, aby określić, jak będą mapowane niektóre atrybuty.
Weźmy pod uwagę ten dokument:

Aby zmapować ten dokument na strukturę, która ma właściwość name typu String, musimy dodać typ wyliczeniowy CodingKeys do struktury ProgrammingLanguage i określić nazwę atrybutu w dokumencie:
struct ProgrammingLanguage: Codable {
  @DocumentID var id: String?
  var name: String
  var year: Date

  enum CodingKeys: String, CodingKey {
    case id
    case name = "language_name"
    case year
  }
}
Domyślnie interfejs Codable API używa nazw właściwości naszych typów Swift do określania nazw atrybutów w dokumentach Cloud Firestore, które próbujemy zmapować. Jeśli nazwy atrybutów są zgodne, nie trzeba dodawać CodingKeys do typów, które można kodować. Jeśli jednak użyjemy CodingKeys w przypadku konkretnego typu, musimy dodać wszystkie nazwy właściwości, które chcemy zmapować.
W powyższym fragmencie kodu zdefiniowaliśmy właściwość id, której możemy użyć jako identyfikatora w widoku List SwiftUI. Jeśli nie określimy go w CodingKeys, nie zostanie on zmapowany podczas pobierania danych i będzie miał wartość nil.
Spowoduje to wypełnienie widoku List pierwszym dokumentem.
Każda właściwość, która nie jest wymieniona jako przypadek w odpowiednim typie wyliczeniowym CodingKeys, zostanie zignorowana podczas procesu mapowania. Może to być wygodne, jeśli chcemy wykluczyć niektóre właściwości z mapowania.
Jeśli na przykład chcemy wykluczyć właściwość reasonWhyILoveThis z mapowania, wystarczy usunąć ją z wyliczenia CodingKeys:
struct ProgrammingLanguage: Identifiable, Codable {
  @DocumentID var id: String?
  var name: String
  var year: Date
  var reasonWhyILoveThis: String = ""

  enum CodingKeys: String, CodingKey {
    case id
    case name = "language_name"
    case year
  }
}
Czasami możemy chcieć zapisać pusty atrybut z powrotem w dokumencie Cloud Firestore. Swift ma pojęcie opcji, które oznaczają brak wartości, a Cloud Firestore obsługuje też wartości null.
Jednak działanie domyślne w przypadku kodowania opcjonalnych pól, które mają wartość nil, polega na ich pomijaniu. @ExplicitNull daje nam pewną kontrolę nad tym, jak typy opcjonalne Swift są obsługiwane podczas kodowania: oznaczając właściwość opcjonalną jako @ExplicitNull, możemy poinstruować Cloud Firestore, aby zapisał tę właściwość w dokumencie z wartością null, jeśli zawiera wartość nil.
Używanie niestandardowego kodera i dekodera do mapowania kolorów
Ostatnim tematem w naszym omówieniu mapowania danych za pomocą protokołu Codable są niestandardowe kodery i dekodery. W tej sekcji nie omawiamy natywnego typu danych Cloud Firestore, ale niestandardowe kodery i dekodery są bardzo przydatne w aplikacjach Cloud Firestore.
„Jak mogę mapować kolory” to jedno z najczęściej zadawanych przez deweloperów pytań, nie tylko w przypadku Cloud Firestore, ale też mapowania między Swift i JSON. Istnieje wiele rozwiązań, ale większość z nich koncentruje się na formacie JSON i prawie wszystkie mapują kolory jako zagnieżdżony słownik składający się z komponentów RGB.
Powinno być jakieś lepsze, prostsze rozwiązanie. Dlaczego nie używamy kolorów internetowych (a dokładniej szesnastkowego kodu koloru CSS)? Są łatwe w użyciu (to w zasadzie tylko ciąg znaków) i obsługują nawet przezroczystość.
Aby móc zmapować Swift Color na jego wartość szesnastkową, musimy utworzyć rozszerzenie Swift, które dodaje Codable do Color.
extension Color {

 init(hex: String) {
    let rgba = hex.toRGBA()

    self.init(.sRGB,
              red: Double(rgba.r),
              green: Double(rgba.g),
              blue: Double(rgba.b),
              opacity: Double(rgba.alpha))
    }

    //... (code for translating between hex and RGBA omitted for brevity)

}

extension Color: Codable {

  public init(from decoder: Decoder) throws {
    let container = try decoder.singleValueContainer()
    let hex = try container.decode(String.self)

    self.init(hex: hex)
  }

  public func encode(to encoder: Encoder) throws {
    var container = encoder.singleValueContainer()
    try container.encode(toHex)
  }

}
Używając decoder.singleValueContainer(), możemy zdekodować String do odpowiednika Color bez konieczności zagnieżdżania komponentów RGBA. Możesz też używać tych wartości w interfejsie internetowym aplikacji bez konieczności ich wcześniejszego konwertowania.
Dzięki temu możemy zaktualizować kod mapowania tagów, co ułatwi obsługę kolorów tagów bezpośrednio, zamiast konieczności ręcznego mapowania ich w kodzie interfejsu aplikacji:
struct Tag: Codable, Hashable {
  var title: String
  var color: Color
}

struct BookWithTags: Codable {
  @DocumentID var id: String?
  var title: String
  var numberOfPages: Int
  var author: String
  var tags: [Tag]
}
Obsługa błędów
W powyższych fragmentach kodu celowo ograniczyliśmy obsługę błędów do minimum, ale w aplikacji produkcyjnej należy zadbać o prawidłową obsługę wszystkich błędów.
Oto fragment kodu, który pokazuje, jak obsługiwać błędy, które mogą wystąpić:
class MappingSimpleTypesViewModel: ObservableObject {
  @Published var book: Book = .empty
  @Published var errorMessage: String?

  private var db = Firestore.firestore()

  func fetchAndMap() {
    fetchBook(documentId: "hitchhiker")
  }

  func fetchAndMapNonExisting() {
    fetchBook(documentId: "does-not-exist")
  }

  func fetchAndTryMappingInvalidData() {
    fetchBook(documentId: "invalid-data")
  }

  private func fetchBook(documentId: String) {
    let docRef = db.collection("books").document(documentId)

    docRef.getDocument(as: Book.self) { result in
      switch result {
      case .success(let book):
        // A Book value was successfully initialized from the DocumentSnapshot.
        self.book = book
        self.errorMessage = nil
      case .failure(let error):
        // A Book value could not be initialized from the DocumentSnapshot.
        switch error {
        case DecodingError.typeMismatch(_, let context):
          self.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
        case DecodingError.valueNotFound(_, let context):
          self.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
        case DecodingError.keyNotFound(_, let context):
          self.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
        case DecodingError.dataCorrupted(let key):
          self.errorMessage = "\(error.localizedDescription): \(key)"
        default:
          self.errorMessage = "Error decoding document: \(error.localizedDescription)"
        }
      }
    }
  }
}
Obsługa błędów w aktualizacjach na żywo
Poprzedni fragment kodu pokazuje, jak obsługiwać błędy podczas pobierania pojedynczego dokumentu. Oprócz jednorazowego pobierania danych Cloud Firestore obsługuje też dostarczanie aktualizacji do aplikacji w miarę ich pojawiania się za pomocą tzw. detektorów zrzutów. Możemy zarejestrować detektor zrzutów w kolekcji (lub zapytaniu), a Cloud Firestore będzie wywoływać nasz detektor za każdym razem, gdy pojawi się aktualizacja.
Oto fragment kodu, który pokazuje, jak zarejestrować detektor zrzutów, zmapować dane za pomocą protokołu Codable i obsłużyć ewentualne błędy. Pokazuje też, jak dodać do kolekcji nowy dokument. Jak zobaczysz, nie ma potrzeby samodzielnego aktualizowania lokalnej tablicy zawierającej zmapowane dokumenty, ponieważ zajmuje się tym kod w detektorze zrzutów.
class MappingColorsViewModel: ObservableObject {
  @Published var colorEntries = [ColorEntry]()
  @Published var newColor = ColorEntry.empty
  @Published var errorMessage: String?

  private var db = Firestore.firestore()
  private var listenerRegistration: ListenerRegistration?

  public func unsubscribe() {
    if listenerRegistration != nil {
      listenerRegistration?.remove()
      listenerRegistration = nil
    }
  }

  func subscribe() {
    if listenerRegistration == nil {
      listenerRegistration = db.collection("colors")
        .addSnapshotListener { [weak self] (querySnapshot, error) in
          guard let documents = querySnapshot?.documents else {
            self?.errorMessage = "No documents in 'colors' collection"
            return
          }

          self?.colorEntries = documents.compactMap { queryDocumentSnapshot in
            let result = Result { try queryDocumentSnapshot.data(as: ColorEntry.self) }

            switch result {
            case .success(let colorEntry):
              if let colorEntry = colorEntry {
                // A ColorEntry value was successfully initialized from the DocumentSnapshot.
                self?.errorMessage = nil
                return colorEntry
              }
              else {
                // A nil value was successfully initialized from the DocumentSnapshot,
                // or the DocumentSnapshot was nil.
                self?.errorMessage = "Document doesn't exist."
                return nil
              }
            case .failure(let error):
              // A ColorEntry value could not be initialized from the DocumentSnapshot.
              switch error {
              case DecodingError.typeMismatch(_, let context):
                self?.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
              case DecodingError.valueNotFound(_, let context):
                self?.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
              case DecodingError.keyNotFound(_, let context):
                self?.errorMessage = "\(error.localizedDescription): \(context.debugDescription)"
              case DecodingError.dataCorrupted(let key):
                self?.errorMessage = "\(error.localizedDescription): \(key)"
              default:
                self?.errorMessage = "Error decoding document: \(error.localizedDescription)"
              }
              return nil
            }
          }
        }
    }
  }

  func addColorEntry() {
    let collectionRef = db.collection("colors")
    do {
      let newDocReference = try collectionRef.addDocument(from: newColor)
      print("ColorEntry stored with new document reference: \(newDocReference)")
    }
    catch {
      print(error)
    }
  }
}
Wszystkie fragmenty kodu użyte w tym poście pochodzą z przykładowej aplikacji, którą możesz pobrać z tego repozytorium na GitHubie.
Zacznij korzystać z protokołu Codable.
Interfejs Codable API języka Swift zapewnia zaawansowany i elastyczny sposób mapowania danych z formatów zserializowanych na model danych aplikacji i odwrotnie. Z tego przewodnika dowiesz się, jak łatwo jest używać tej usługi w aplikacjach, które korzystają z Cloud Firestore jako magazynu danych.
Zaczęliśmy od podstawowego przykładu z prostymi typami danych, a następnie stopniowo zwiększaliśmy złożoność modelu danych, cały czas korzystając z implementacji Codable i Firebase do mapowania.
Więcej informacji o protokole Codable znajdziesz w tych materiałach:
- John Sundell napisał ciekawy artykuł o podstawach protokołu Codable.
- Jeśli wolisz książki, zapoznaj się z Flight School Guide to Swift Codable Mattta.
- Donny Wals przygotował całą serię o protokole Codable.
Dołożyliśmy wszelkich starań, aby przygotować kompleksowy przewodnik po mapowaniu dokumentów Cloud Firestore, ale nie jest on wyczerpujący i możesz używać innych strategii mapowania typów. Kliknij przycisk Prześlij opinię poniżej i daj nam znać, jakich strategii używasz do mapowania innych typów danych Cloud Firestore lub reprezentowania danych w Swift.
Nie ma żadnego powodu, aby nie korzystać z obsługi protokołu Codable w Cloud Firestore.