

閱讀這份文件,即可做出明智決策,打造高效能、高可靠性的應用程式架構。本文件包含進階 Cloud Firestore 主題。如果您剛開始使用 Cloud Firestore,請改為參閱快速入門指南。
Cloud Firestore 是 Firebase 和 Google Cloud 提供的資料庫,具備彈性與擴充性,適用於行動裝置、網頁和伺服器開發。Cloud Firestore 容易上手,助您輕鬆打造功能豐富強大的應用程式。
為確保應用程式在資料庫大小和流量增加時仍能正常運作,建議您瞭解 Cloud Firestore 後端的讀取和寫入機制。此外,您也必須瞭解讀取和寫入作業與儲存層的互動,以及可能影響效能的基礎限制。
在架構應用程式之前,請參閱下列各節的最佳做法。
瞭解高階元件
下圖顯示 Cloud Firestore API 要求涉及的高階元件。
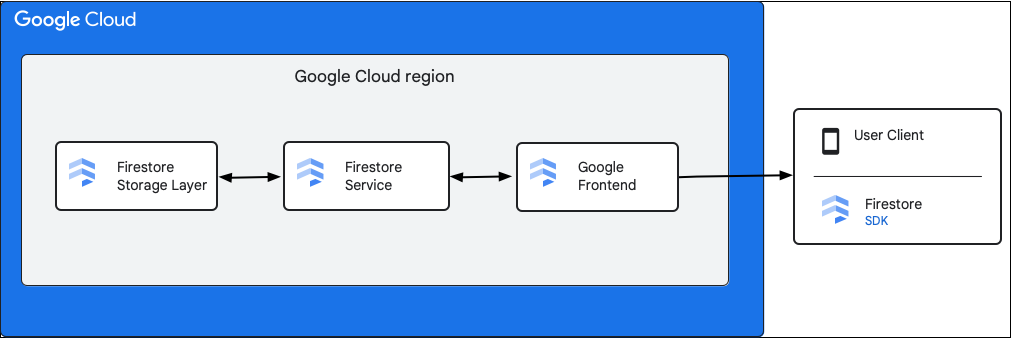
Cloud Firestore SDK 和用戶端程式庫
Cloud Firestore 支援不同平台的 SDK 和用戶端程式庫。雖然應用程式可以直接向 Cloud Firestore API 發出 HTTP 和 RPC 呼叫,但用戶端程式庫提供抽象層,可簡化 API 使用方式並實作最佳做法。也可能提供離線存取、快取等額外功能。
Google Front End (GFE)
這是所有 Google Cloud 服務通用的基礎架構服務。GFE 會接受傳入的要求,並將要求轉送至相關的 Google 服務 (在本例中為 Cloud Firestore 服務)。此外,GFE 也提供其他重要功能,包括防範阻斷服務攻擊。
Cloud Firestore 項服務
Cloud Firestore 服務會檢查 API 要求,包括驗證、授權、配額檢查和安全性規則,並管理交易。這項 Cloud Firestore 服務包含儲存空間用戶端,可與儲存空間層互動,進行資料讀取和寫入。
Cloud Firestore 儲存層
Cloud Firestore 儲存層負責儲存資料和中繼資料,以及 Cloud Firestore 提供的相關資料庫功能。以下各節說明 Cloud Firestore 儲存層如何整理資料,以及系統如何擴充。瞭解資料的組織方式,有助於設計可擴充的資料模型,並進一步瞭解 Cloud Firestore 的最佳做法。
按鍵範圍和分割
Cloud Firestore 是 NoSQL 文件導向資料庫。資料會儲存在文件中,並依集合階層結構整理。集合階層和文件 ID 會轉譯為每份文件的單一鍵。文件會以邏輯方式儲存,並依這個單一索引鍵的字母順序排列。我們使用「金鑰範圍」一詞,來指稱按字母順序排列的連續金鑰範圍。
一般的 Cloud Firestore 資料庫太大,無法容納在單一實體機器中。有時資料工作負載過重,單一機器無法處理。為了處理大量工作負載,Cloud Firestore 會將資料分割成多個部分,並儲存在多部機器或儲存伺服器上,以便提供服務。這些分區是在資料庫資料表中建立,以鍵範圍區塊為單位,稱為「分割區」。
同步複製
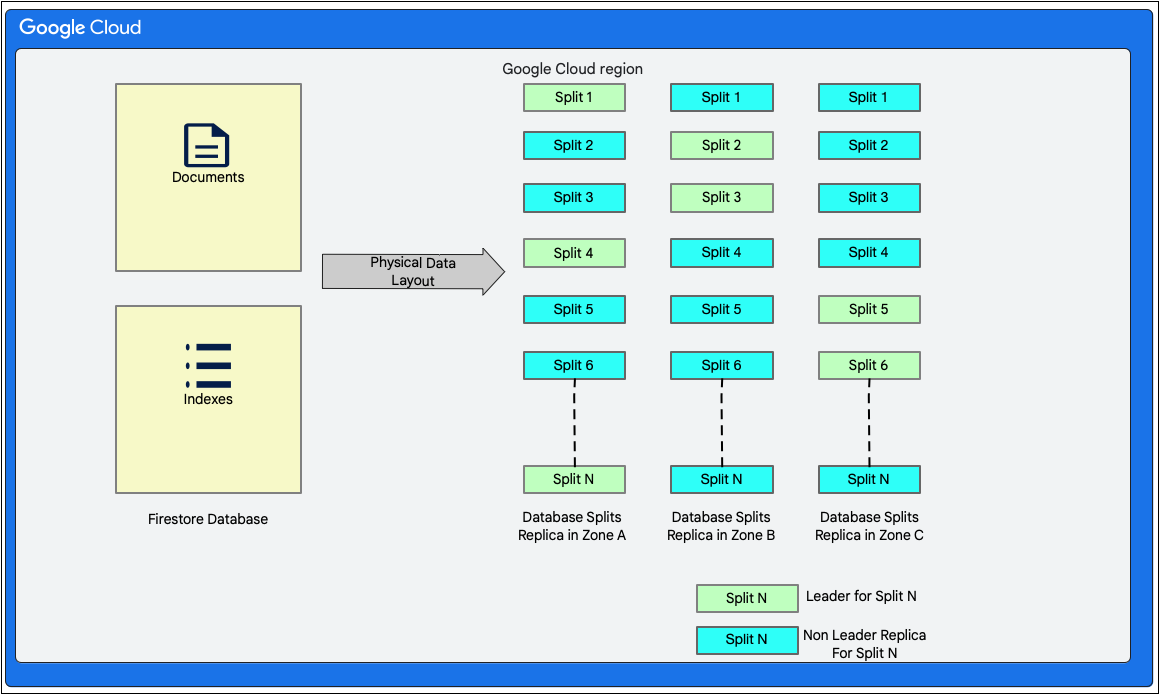
請注意,資料庫一律會自動同步複製。資料分割在不同可用區中都有副本,因此即使某個可用區無法存取,資料仍可使用。Paxos 共識演算法會管理分割區不同副本的一致複製作業。系統會選出每個分割區的一個副本做為 Paxos 領導者,負責處理該分割區的寫入作業。同步複製功能可讓您隨時從 Cloud Firestore 讀取最新版本的資料。
整體而言,這個系統可擴充且具備高可用性,無論工作負載多重、規模多大,都能提供低延遲的讀寫服務。
資料版面配置
Cloud Firestore 是無結構定義的文件資料庫。不過,在內部,它主要會將資料配置在儲存層中的兩個關聯式資料庫樣式資料表中,如下所示:
- Documents 資料表:文件會儲存在這個資料表。
- 索引資料表:這個資料表會儲存索引項目,以便有效率地取得結果,並依索引值排序。
下圖顯示 Cloud Firestore 資料庫的資料表在分割後的可能樣貌。分割區會複製到三個不同的可用區,且每個分割區都會指派 Paxos 領導者。
單一區域與多區域
單一區域位置是指特定地理位置,例如 us-west1。如前所述,Cloud Firestore 資料庫的資料分割在所選區域內的不同可用區中都有副本。
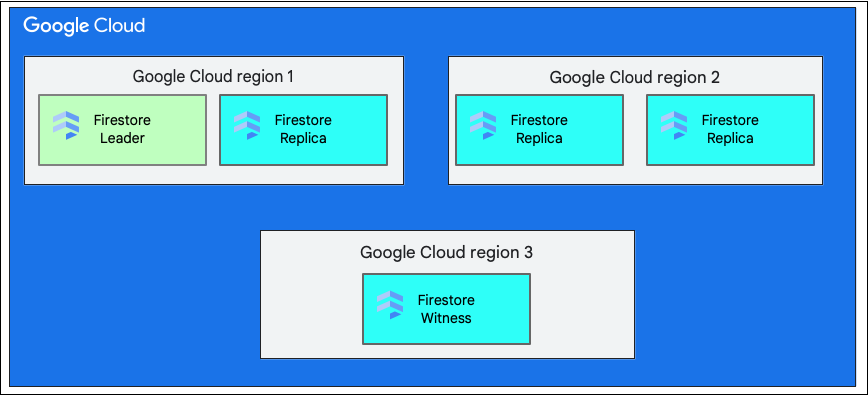
多區域位置是由一組定義的區域組成,用於儲存資料庫副本。在 Cloud Firestore 的多區域部署中,有兩個區域具有資料庫中完整資料的完整副本。第三個區域則有見證副本,不會維護完整資料集,但會參與複製作業。在多個區域之間複製資料後,即使整個區域遺失,資料仍可供寫入和讀取。
如要進一步瞭解區域的位置,請參閱「Cloud Firestore 位置」。
瞭解 Cloud Firestore 中的寫入作業生命週期
Cloud Firestore 用戶端可以建立、更新或刪除單一文件,藉此寫入資料。寫入單一文件時,必須在儲存層中以不可分割的方式更新文件及其相關聯的索引項目。Cloud Firestore 也支援不可分割作業,可對一或多份文件執行多項讀取和/或寫入作業。
對於所有類型的寫入作業,Cloud Firestore 都會提供關聯式資料庫的 ACID 屬性 (不可分割性、一致性、隔離性和耐用性)。Cloud Firestore 也提供序列化,這表示所有交易都會以序列順序執行。
寫入交易的大致步驟
當 Cloud Firestore 用戶端使用上述任一方法發出寫入或提交交易時,系統會在儲存層中以資料庫讀寫交易的形式執行。交易可讓 Cloud Firestore 提供前述的 ACID 屬性。
Cloud Firestore 會先讀取現有文件,並判斷要對 Documents 資料表中的資料進行哪些異動,這是交易的第一步。
這也包括對「索引」表格進行必要更新,如下所示:
- 新增至文件的欄位必須在「Indexes」資料表中有對應的插入項目。
- 從文件中移除的欄位,必須在「Indexes」資料表中刪除對應項目。
- 在文件中修改的欄位,必須在索引資料表中同時刪除 (舊值) 和插入 (新值)。
為計算上述異動,Cloud Firestore 會讀取資料庫的索引設定。索引設定會儲存資料庫的索引資訊。Cloud Firestore 使用兩種索引:單一欄位和複合式。如要進一步瞭解在 Cloud Firestore 中建立的索引,請參閱「Cloud Firestore 中的索引類型」。
計算完異動後,Cloud Firestore 會在交易中收集這些異動,然後提交。
瞭解儲存層中的寫入交易
如先前所述,Cloud Firestore 中的寫入作業涉及儲存層的讀寫交易。視資料版面配置而定,寫入作業可能涉及一或多個分割,如資料版面配置所示。
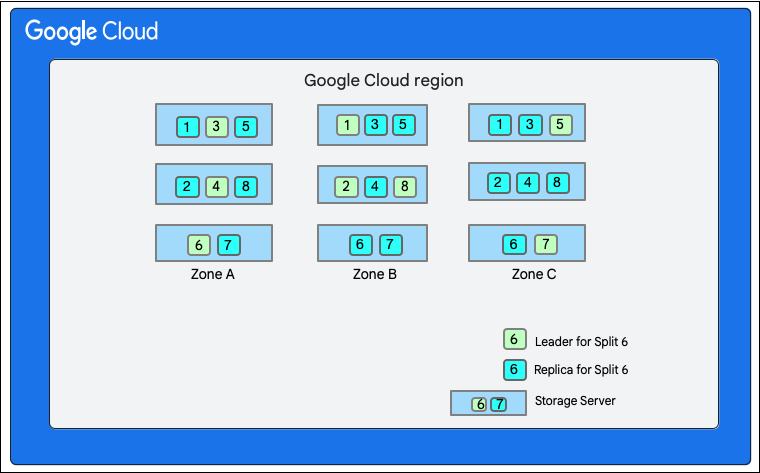
在下圖中,Cloud Firestore 資料庫有八個分割 (標示為 1 至 8),託管於單一可用區的三個不同儲存伺服器,每個分割都會複製到 3 個(或更多) 不同的可用區。每個分割區都有 Paxos 領導者,不同分割區的領導者可能位於不同可用區。
 Cloud Firestore 資料庫分割">
假設 Cloud Firestore 資料庫有 Restaurants 集合,如下所示:
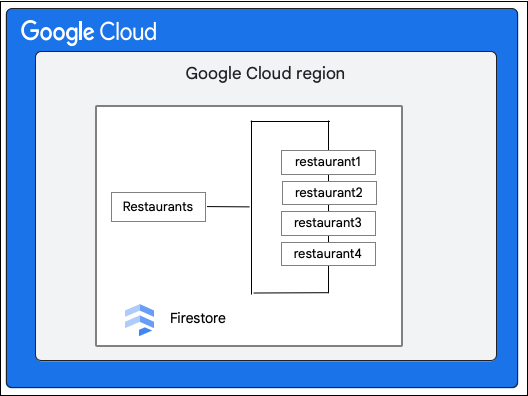
Cloud Firestore 用戶端要求變更 Restaurant 集合中的文件,方法是更新 priceCategory 欄位的值。
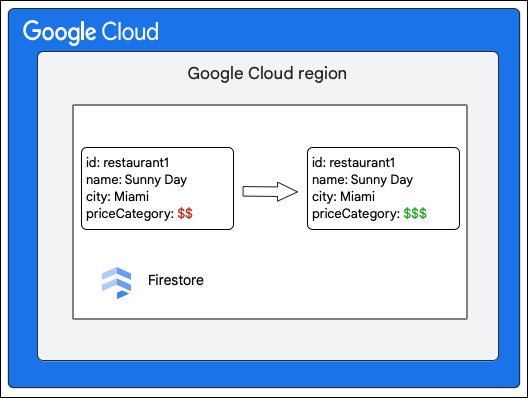
以下大致說明寫入作業的步驟:
- 建立讀寫交易。
- 從儲存層的「Documents」資料表,讀取
Restaurants集合中的restaurant1文件。 - 從 Indexes 資料表讀取文件的索引。
- 計算要對資料進行的異動。在這個例子中,有五個異動:
- M1:更新文件資料表中
restaurant1的資料列,反映priceCategory欄位的值變更。 - M2 和 M3:在「Indexes」資料表中,刪除遞減和遞增索引的
priceCategory舊值資料列。 - M4 和 M5:在「Indexes」資料表中,為
priceCategory的新值插入遞減和遞增索引的資料列。
- M1:更新文件資料表中
- 提交這些異動。
Cloud Firestore 服務中的儲存用戶端會查詢擁有要變更資料列金鑰的分割。假設 Split 3 放送 M1,Split 6 放送 M2-M5。分散式交易會將所有分割視為參與者。參與者分割也可能包含先前在讀寫交易中讀取資料的其他分割。
下列步驟說明修訂時會發生的情況:
- 儲存空間用戶端會發出修訂版本。修訂版本包含 M1 至 M5 變異。
- 拆分 3 和 6 是這筆交易的參與者。其中一個參與者會獲選為「協調者」,例如分割 3。協調者的工作是確保交易在所有參與者之間以不可分割的方式提交或取消。
- 這些分割的主要副本負責參與者和協調者執行的工作。
- 每位參與者和協調者都會使用各自的副本執行 Paxos 演算法。
- 領導者會與副本一起執行 Paxos 演算法。如果大多數副本都向領導者回覆
ok to commit,即達成共識。 - 接著,每位參與者會在準備就緒時通知協調者 (兩階段修訂版本的第一階段)。如果有任何參與者無法提交交易,整個交易就會
aborts。
- 領導者會與副本一起執行 Paxos 演算法。如果大多數副本都向領導者回覆
- 協調者確認所有參與者 (包括自己) 都準備就緒後,就會將
accept交易結果傳達給所有參與者 (兩階段修訂的第二階段)。在這個階段,每位參與者都會將提交決策記錄到穩定儲存空間,並提交交易。 - 協調者會向 Cloud Firestore 中的儲存用戶端回覆交易已提交。同時,協調者和所有參與者都會對資料套用異動。
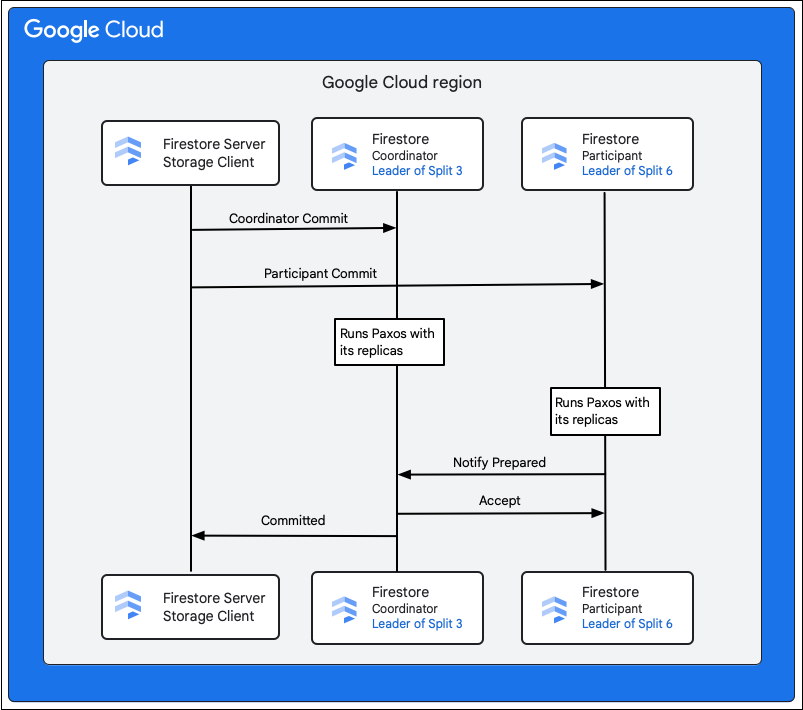
當 Cloud Firestore 資料庫很小時,單一分割區可能會擁有 M1 至 M5 變更中的所有索引鍵。在這種情況下,交易中只有一個參與者,不需要上述的兩階段修訂,因此寫入速度更快。
多區域寫入
在多區域部署中,副本分散在多個區域可提高可用性,但會影響效能。不同區域的副本之間通訊,需要較長的往返時間。因此,與單一區域部署相比,Cloud Firestore 作業的基準延遲時間會稍微長一些。
我們設定副本的方式,可確保分割區的主要副本一律位於主要區域。主要區域是指流量傳入 Cloud Firestore 伺服器的區域。這項領導權決策可減少 Cloud Firestore 中儲存空間用戶端與副本領導者 (或多重分割交易的協調者) 之間的來回通訊延遲。
Cloud Firestore 中的每次寫入作業,也會與 Cloud Firestore 中的即時引擎互動。如要進一步瞭解即時查詢,請參閱「瞭解大規模即時查詢」。
瞭解 Cloud Firestore 的讀取作業生命週期
本節將深入探討 Cloud Firestore 中的獨立非即時讀取作業。在內部,Cloud Firestore 伺服器會透過兩個主要階段處理大部分的查詢:
- 對 Indexes 資料表執行單一範圍掃描
- 根據先前掃描的結果,在 Documents 資料表中進行點查詢
系統會使用資料庫交易,在內部執行儲存層的資料讀取作業,確保讀取結果一致。不過,與用於寫入的交易不同,這些交易不會鎖定。而是選擇時間戳記,然後在該時間戳記執行所有讀取作業。由於這類作業不會取得鎖定,因此不會封鎖並行讀寫交易。如要執行這項交易,Cloud Firestore 中的儲存空間用戶端會指定時間戳記繫結,指示儲存空間層如何選擇讀取時間戳記。Cloud Firestore 中的儲存空間用戶端選擇的時間戳記繫結類型,取決於讀取要求的讀取選項。
瞭解儲存層中的讀取交易
本節說明讀取類型,以及 Cloud Firestore 儲存層如何處理這些讀取。
強烈建議閱讀
根據預設,Cloud Firestore 讀取作業同步一致。這種同步一致性代表 Cloud Firestore 讀取作業會傳回最新版本的資料,反映在讀取作業開始前已提交的所有寫入作業。
單一分割讀取
Cloud Firestore 中的儲存空間用戶端會查詢擁有要讀取資料列索引鍵的分割。假設需要從先前章節的分割 3 讀取資料。用戶端會將讀取要求傳送至最近的副本,縮短來回延遲時間。
此時,系統會根據所選副本,執行下列其中一項操作:
- 讀取要求會傳送至領導者副本 (可用區 A)。
- 由於領導者一律會更新,因此可以直接進行讀取。
- 讀取要求會傳送至非領導者副本 (例如可用區 B)
- 分割區 3 可能會根據內部狀態,判斷自己有足夠的資訊可提供讀取作業,並執行該作業。
- Split 3 不確定是否已看到最新資料。它會傳送訊息給領導者,要求提供最後一筆交易的時間戳記,以便套用該交易來提供讀取服務。套用該交易後,即可繼續讀取。
Cloud Firestore 接著會將回應傳回給用戶端。
多重分割讀取
如果必須從多個分割區讀取資料,所有分割區都會採用相同機制。所有分割區都傳回資料後,Cloud Firestore 中的儲存用戶端會合併結果。Cloud Firestore 接著會將這項資料回覆給用戶端。
過時讀取
Cloud Firestore 的預設模式為強式讀取。不過,由於可能需要與領導者通訊,因此延遲時間可能會較長。Cloud Firestore 應用程式通常不需要讀取最新版本的資料,即使資料可能過時幾秒,功能也能正常運作。
在這種情況下,用戶端可以選擇使用 read_time 讀取選項,接收過時讀取。在這種情況下,系統會讀取 read_time 的資料,而最接近的副本很可能已驗證其在指定 read_time 具有資料。如要大幅提升效能,15 秒是合理的過時值。即使是過時讀取,產生的資料列也彼此一致。
避開熱點
Cloud Firestore 中的分割會自動拆分為較小的部分,以便在需要時或鍵空間擴大時,將提供流量的工作分配給更多儲存伺服器。即使流量減少,為處理過多流量而建立的分割仍會保留約 24 小時。因此,如果流量反覆激增,系統會維持分割,並在必要時增加分割。這些機制可協助 Cloud Firestore 資料庫在流量負載或資料庫大小增加時,自動調度資源。不過,請留意下列限制。
分割儲存空間和負載需要時間,如果流量增加過快,可能會導致高延遲或超過期限錯誤,通常稱為熱點,而服務會進行調整。最佳做法是將作業分散到整個鍵範圍,同時在資料庫中以每秒 500 次作業的速度,逐步增加集合的流量。逐步提高流量後,每五分鐘最多可增加 50% 的流量。這項程序稱為 500/50/5 規則,可讓資料庫以最佳方式擴充,滿足工作負載需求。
雖然系統會隨著負載增加自動建立分割,但 Cloud Firestore 只能分割鍵範圍,直到使用一組專用的複製儲存伺服器提供單一文件為止。因此,如果對單一文件執行大量且持續的並行作業,可能會導致該文件出現熱點。如果單一文件持續出現高延遲,建議您修改資料模型,將資料分割或複製到多份文件。
如果多項作業嘗試同時讀取和/或寫入同一份文件,就會發生爭用錯誤。
另一種熱點特殊情況是,在 Cloud Firestore 中使用依序遞增/遞減的鍵做為文件 ID,且每秒作業數量相當多。建立更多分割區並無法解決這個問題,因為流量激增的情況只會轉移到新建立的分割區。根據預設,Cloud Firestore 會自動為文件中的所有欄位建立索引,因此這類移動熱點也可能建立在文件欄位的索引空間上,其中包含依序遞增/遞減的值,例如時間戳記。
請注意,只要遵循上述做法,Cloud Firestore 就能擴充規模,處理任意大型工作負載,您不必調整任何設定。
疑難排解
Cloud Firestore 提供 Key Visualizer 診斷工具,可分析使用模式並排解熱點問題。