
Cette page explique comment récupérer des informations sur l'exécution d'une requête.
Utiliser l'explication de la requête
Vous pouvez utiliser Query Explain pour comprendre comment vos requêtes sont exécutées. Vous y trouverez des informations qui vous permettront d'optimiser vos requêtes.
Vous pouvez utiliser "Expliquer la requête" dans la console Google Cloud ou avec la commande explain.
Console
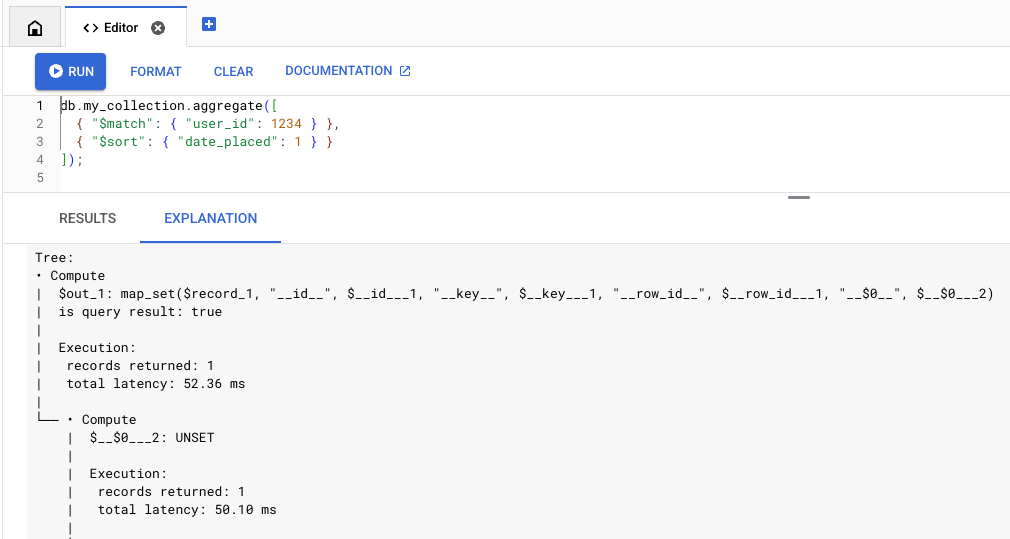
Exécutez une requête dans l'éditeur de requête et ouvrez l'onglet Explication :
-
Dans la console Google Cloud, accédez à la page Base de données.
- Dans la liste des bases de données, sélectionnez une base de données Cloud Firestore. La console Google Cloud ouvre l'explorateur Firestore pour cette base de données.
- Saisissez une requête dans l'éditeur de requête, puis cliquez sur Exécuter.
-
Cliquez sur l'onglet Explication pour afficher le résultat de l'analyse de la requête.
API MongoDB
La fonctionnalité "Explain" des requêtes dans l'API MongoDB est compatible avec la commande explain, que vous pouvez utiliser dans des outils tels que Mongo Shell et Compass.
La commande explain est compatible avec les commandes aggregate, find, distinct et count. Par exemple :
db.collection.explain('executionStats').find(...)
Vous pouvez également utiliser la méthode explain(), par exemple :
db.collection.find({QUERY}).explain('executionStats')Limites
Notez les limitations et différences suivantes :-
La fonctionnalité d'explication des requêtes n'est pas compatible avec les commandes qui renvoient un curseur. Par exemple, l'appel direct d'explain à l'aide de la commande suivante n'est pas pris en charge :
db.collection.aggregate(..., explain: true)
L'explication des requêtes n'est compatible qu'avec les commandes
find,aggregate,count,distinct,update,deleteetfindAndModify.-
La fonctionnalité d'explication des requêtes est compatible avec les modes de verbosité
executionStats,allPlansExecutionetqueryPlanner.queryPlanner: renvoie le plan d'exécution uniquement, sans exécuter la requête.executionStatsetallPlansExecution: renvoient le plan d'exécution ainsi que les statistiques de facturation, de mémoire et d'exécution.
Si aucun mode de verbosité n'est spécifié, le shell utilise
queryPlannerpar défaut. Pour afficher les statistiques d'exécution complètes, vous devez spécifier le mode de verbositéexecutionStatsouallPlansExecution.
Analyse
La sortie de l'explication de la requête contient deux composants principaux : les statistiques récapitulatives et l'arborescence d'exécution. Prenons la requête suivante comme exemple :
db.orders.aggregate(
 [
   { "$match": { "user_id": 1234 } },
   { "$sort": { "date_placed": 1 } }
 ]
)
Statistiques récapitulatives
Le haut de la sortie expliquée contient un récapitulatif des statistiques d'exécution. Utilisez ces statistiques pour déterminer si une requête présente une latence ou un coût élevés. Il contient également des statistiques sur la mémoire qui vous indiquent à quel point votre requête est proche des limites de mémoire.
Execution:
 results returned: 35
 query id: 7e7b37ea1a259d79
 request peak memory usage: 45.56 KiB (46,656 B)
 data bytes read: 24.58 KiB (25,175 B)
 entity row scanned: 265

Billing:
 read units: 7
Arborescence d'exécution
L'arborescence d'exécution décrit l'exécution de la requête sous la forme d'une série de nœuds. Les nœuds inférieurs (nœuds feuilles) récupèrent les données de la couche de stockage, qui remonte l'arborescence pour générer une réponse à la requête.
Pour en savoir plus sur chaque nœud d'exécution, consultez la documentation de référence sur l'exécution.
Pour savoir comment utiliser ces informations afin d'optimiser vos requêtes, consultez Optimiser l'exécution des requêtes.
Voici un exemple d'arborescence d'exécution :
Execution:
 results returned: 35
 query id: 7e7b37ea1a259d79
 request peak memory usage: 45.56 KiB (46,656 B)
 data bytes read: 24.58 KiB (25,175 B)
 entity row scanned: 265

Billing:
 read units: 7

Tree:
• Compute
|  $out_1: map_set($record_1, "__id__", $__id___1, "__key__", unset)
|  is query result: true
|
|  Execution:
|   records returned: 35
|   latency: 204.87 ms (local 7.64 ms)
|
└── • Compute
    |  $__id___1: _id($__key___2)
    |
    |  Execution:
    |   records returned: 35
    |   latency: 197.23 ms (local 2.04 ms)
    |
    └── • MajorSort
        |  fields: [$v_5 ASC]
        |  output: [$__key___2, $record_1]
        |
        |  Execution:
        |   records returned: 35
        |   latency: 195.20 ms (local 28.42 ms)
        |   peak memory usage: 45.56 KiB (46,656 B)
        |
        └── • Compute
            |  $v_5: offset($v_4, 0L)
            |
            |  Execution:
            |   records returned: 35
            |   latency: 166.78 ms (local 14.84 ms)
            |
            └── • Compute
                |  $v_4: sortPaths(array($date_placed_1), [date_placed ASC])
                |
                |  Execution:
                |   records returned: 35
                |   latency: 151.94 ms (local 5.43 ms)
                |
                └── • TableScan
                       source: **/orders
                       order: STABLE
                       filter: $eq($user_id_1, 1,234)
                       output bindings: {$__key___2=row().__key__, $date_placed_1=row().date_placed, $record_1=row[* - { __create_time__, __update_time__ }](), $user_id_1=row().user_id}
                       output: [$__key___2, $date_placed_1, $record_1]

                       Execution:
                        records returned: 35
                        latency: 146.50 ms
                        data bytes returned: 3.25 KiB (3,325 B)
                        post-filtered rows: 230
                        records scanned: 265
                        data bytes read: 24.58 KiB (25,175 B)
Étape suivante
- Pour en savoir plus sur les nœuds de l'arborescence d'exécution, consultez la documentation de référence sur l'exécution des requêtes.
- Pour savoir comment optimiser vos requêtes, consultez Optimiser l'exécution des requêtes.