

Lisez ce document pour prendre des décisions éclairées sur l'architecture de vos applications afin d'en optimiser les performances et la fiabilité. Ce document aborde des sujets avancés sur Cloud Firestore. Si vous débutez avec Cloud Firestore, consultez plutôt le guide de démarrage rapide.
Cloud Firestore est une base de données flexible et évolutive conçue pour le développement d'appareils mobiles, Web et serveur à partir de Firebase et de Google Cloud. Il est très facile de se lancer avec Cloud Firestore et d'écrire des applications riches et performantes.
Pour vous assurer que vos applications continuent de fonctionner correctement à mesure que la taille de votre base de données et le trafic augmentent, il est utile de comprendre les mécanismes de lecture et d'écriture dans le backend Cloud Firestore. Vous devez également comprendre l'interaction de vos lectures et écritures avec la couche de stockage et les contraintes sous-jacentes susceptibles d'affecter les performances.
Consultez les sections suivantes pour connaître les bonnes pratiques avant de concevoir l'architecture de votre application.
Comprendre les composants de haut niveau
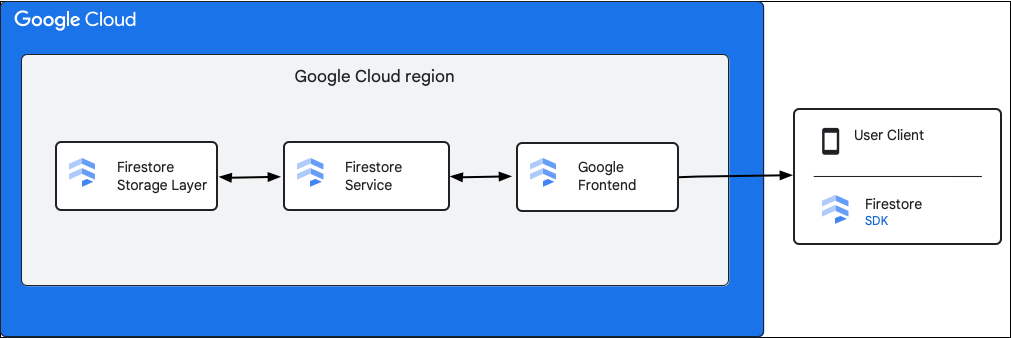
Le schéma suivant illustre les composants de haut niveau impliqués dans une requête API Cloud Firestore.
SDK et bibliothèques clientes Cloud Firestore
Cloud Firestore est compatible avec les SDK et les bibliothèques clientes pour différentes plates-formes. Bien qu'une application puisse effectuer des appels HTTP et RPC directs à l'API Cloud Firestore, les bibliothèques clientes fournissent une couche d'abstraction pour simplifier l'utilisation de l'API et mettre en œuvre les bonnes pratiques. Ils peuvent également fournir des fonctionnalités supplémentaires telles que l'accès hors connexion, les caches, etc.
Google Front End (GFE)
Il s'agit d'un service d'infrastructure commun à tous les services Google Cloud. Le GFE accepte les requêtes entrantes et les transfère au service Google concerné (le service Cloud Firestore dans ce contexte). Il fournit également d'autres fonctionnalités importantes, y compris la protection contre les attaques par déni de service.
Service Cloud Firestore
Le service Cloud Firestore effectue des vérifications sur la requête API, y compris l'authentification, l'autorisation, les vérifications de quotas et les règles de sécurité, et gère également les transactions. Ce service Cloud Firestore inclut un client de stockage qui interagit avec la couche de stockage pour les lectures et écritures de données.
Couche de stockage Cloud Firestore
La couche de stockage Cloud Firestore est chargée de stocker les données et les métadonnées, ainsi que les fonctionnalités de base de données associées fournies par Cloud Firestore. Les sections suivantes décrivent comment les données sont organisées dans la couche de stockage Cloud Firestore et comment le système évolue. En savoir plus sur l'organisation des données peut vous aider à concevoir un modèle de données évolutif et à mieux comprendre les bonnes pratiques dans Cloud Firestore.
Plages de clés et divisions
Cloud Firestore est une base de données NoSQL orientée document. Vous stockez les données dans des documents, qui sont organisés en hiérarchies de collections. La hiérarchie de la collection et l'ID du document sont traduits en une clé unique pour chaque document. Les documents sont stockés de manière logique et classés par ordre lexicographique à l'aide de cette clé unique. Nous utilisons le terme "plage de clés" pour désigner une plage de clés contiguës d'un point de vue lexicographique.
Une base de données Cloud Firestore standard est trop volumineuse pour tenir sur une seule machine physique. Dans certains cas, la charge de travail sur les données est trop lourde pour être gérée par une seule machine. Pour gérer des charges de travail importantes, Cloud Firestore partitionne les données en plusieurs parties qui peuvent être stockées et diffusées à partir de plusieurs machines ou serveurs de stockage. Ces partitions sont effectuées sur les tables de base de données dans des blocs de plages de clés appelés "divisions".
Réplication synchrone
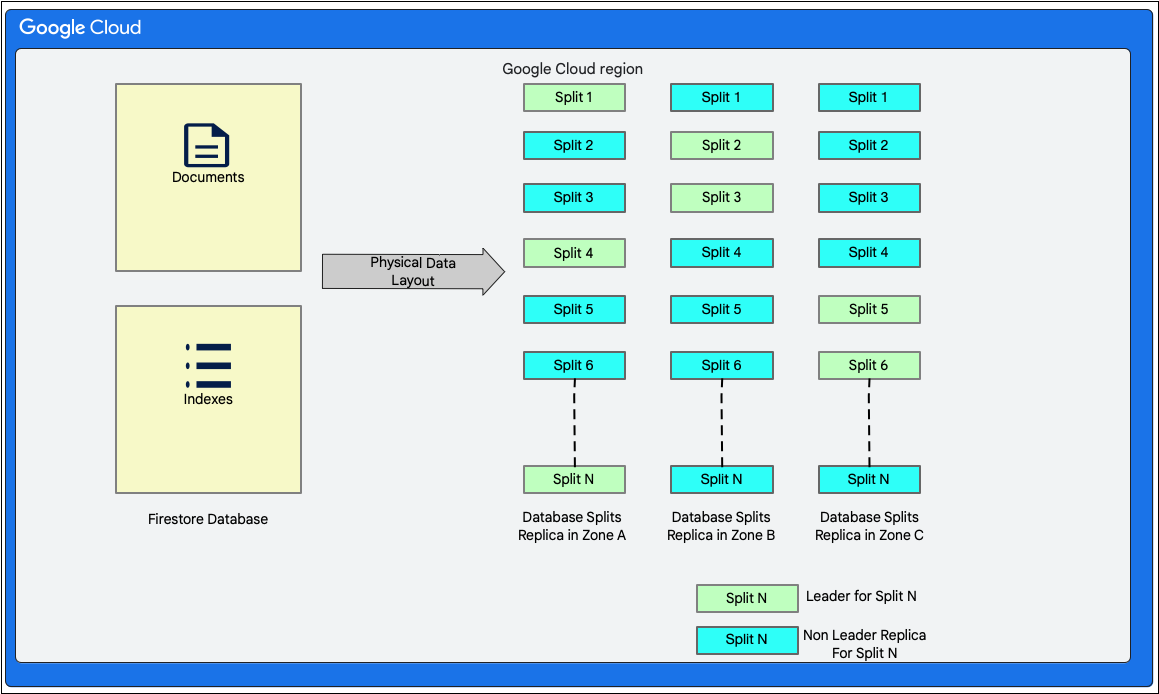
Il est important de noter que la base de données est toujours répliquée automatiquement et de manière synchrone. Les divisions de données ont des instances répliquées dans différentes zones pour rester disponibles même lorsqu'une zone devient inaccessible. La réplication cohérente vers les différentes copies de la division est gérée par l'algorithme de consensus Paxos. Une instance répliquée de chaque division est élue pour agir en tant qu'instance principale Paxos, qui est responsable de la gestion des écritures dans cette division. La réplication synchrone vous permet de toujours pouvoir lire la dernière version des données de Cloud Firestore.
Le résultat global est un système évolutif et hautement disponible qui offre de faibles latences pour les lectures et les écritures, indépendamment des charges de travail lourdes et à très grande échelle.
Mise en page des données
Cloud Firestore est une base de données de documents sans schéma. Cependant, en interne, il organise les données principalement dans deux tables de style base de données relationnelle dans sa couche de stockage, comme suit :
- Table Documents : les documents sont stockés dans cette table.
- Table Indexes : les entrées d'index qui permettent d'obtenir des résultats efficacement et triés par valeur d'index sont stockées dans cette table.
Le schéma suivant montre à quoi pourraient ressembler les tables d'une base de données Cloud Firestore avec les divisions. Les divisions sont répliquées dans trois zones différentes, et chacune d'elles est associée à une instance principale Paxos.
Région unique ou multirégional
Lorsque vous créez une base de données, vous devez sélectionner une région ou un emplacement multirégional.
Un emplacement régional unique est un emplacement géographique spécifique, comme us-west1. Les divisions de données d'une base de données Cloud Firestore ont des instances répliquées dans différentes zones de la région sélectionnée, comme expliqué précédemment.
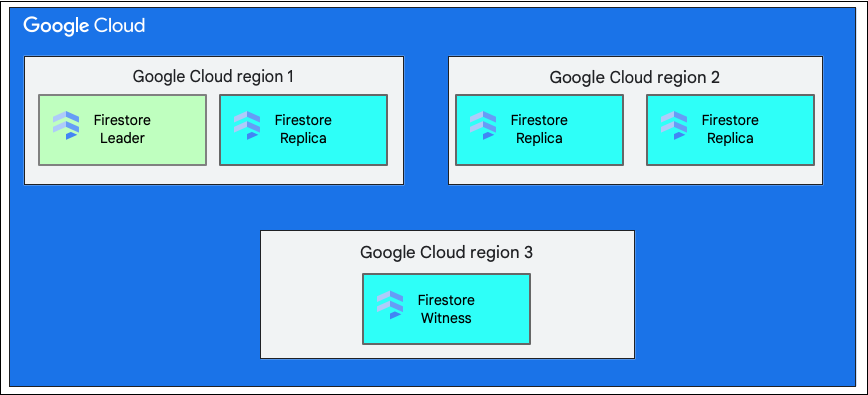
Un emplacement multirégional se compose d'un ensemble défini de régions dans lesquelles les instances répliquées de la base de données sont stockées. Dans un déploiement multirégional de Cloud Firestore, deux des régions disposent d'instances répliquées complètes de l'ensemble des données de la base de données. Une troisième région dispose d'une instance répliquée témoin qui ne conserve pas un ensemble complet de données, mais participe à la réplication. En répliquant les données entre plusieurs régions, elles peuvent être écrites et lues même en cas de perte d'une région entière.
Pour en savoir plus sur les emplacements d'une région, consultez Emplacements Cloud Firestore.
Comprendre le cycle de vie d'une écriture dans Cloud Firestore
Un client Cloud Firestore peut écrire des données en créant, en mettant à jour ou en supprimant un seul document. Une écriture dans un seul document nécessite de mettre à jour de manière atomique le document et ses entrées d'index associées dans la couche de stockage. Cloud Firestore accepte également les opérations atomiques consistant en plusieurs lectures et/ou écritures dans un ou plusieurs documents.
Pour tous les types d'écritures, Cloud Firestore fournit les propriétés ACID (atomicité, cohérence, isolation et durabilité) des bases de données relationnelles. Cloud Firestore fournit également la sérialisabilité, ce qui signifie que toutes les transactions apparaissent comme si elles étaient exécutées dans un ordre sériel.
Étapes majeures d'une transaction d'écriture
Lorsque le client Cloud Firestore émet une écriture ou valide une transaction, en utilisant l'une des méthodes mentionnées précédemment, celle-ci est exécutée en interne en tant que transaction de lecture-écriture de base de données dans la couche de stockage. La transaction permet à Cloud Firestore de fournir les propriétés ACID mentionnées précédemment.
Lors de la première étape d'une transaction, Cloud Firestore lit le document existant et détermine les mutations à apporter aux données de la table "Documents".
Cela inclut également d'apporter les modifications nécessaires à la table Indexes comme suit :
- Les champs ajoutés aux documents doivent être insérés dans la table des index.
- Les champs supprimés des documents doivent être supprimés de la table "Indexes".
- Les champs modifiés dans les documents nécessitent à la fois des suppressions (pour les anciennes valeurs) et des insertions (pour les nouvelles valeurs) dans la table "Indexes".
Pour calculer les mutations mentionnées précédemment, Cloud Firestore lit la configuration d'indexation de la base de données. La configuration d'indexation stocke des informations sur les index d'une base de données. Cloud Firestore utilise deux types d'index : les index à champ unique et les index composites. Pour en savoir plus sur les index créés dans Cloud Firestore, consultez Types d'index dans Cloud Firestore.
Une fois les mutations calculées, Cloud Firestore les collecte dans une transaction, puis les valide.
Comprendre une transaction d'écriture dans la couche de stockage
Comme indiqué précédemment, une écriture dans Cloud Firestore implique une transaction en lecture-écriture dans la couche de stockage. Selon la disposition des données, une écriture peut impliquer une ou plusieurs divisions, comme indiqué dans la disposition des données.
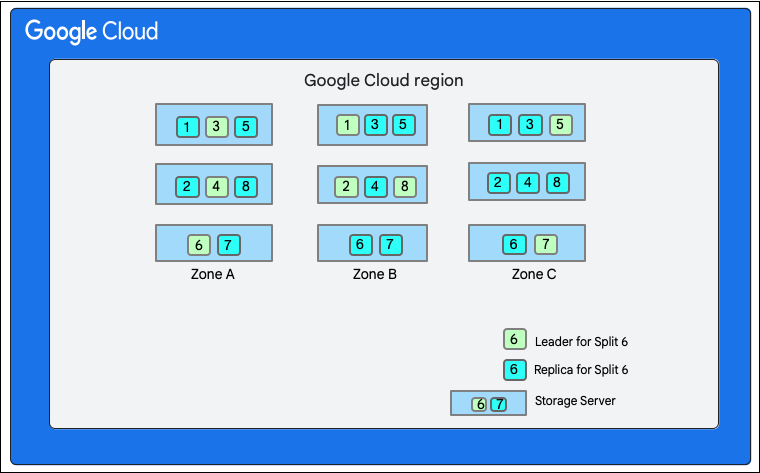
Dans le schéma suivant, la base de données Cloud Firestore comporte huit divisions (marquées de 1 à 8) hébergées sur trois serveurs de stockage différents dans une seule zone, et chaque division est répliquée dans trois zones différentes(ou plus). Chaque division possède un leader Paxos, qui peut se trouver dans une zone différente pour différentes divisions.
 Cloud Firestore database split">
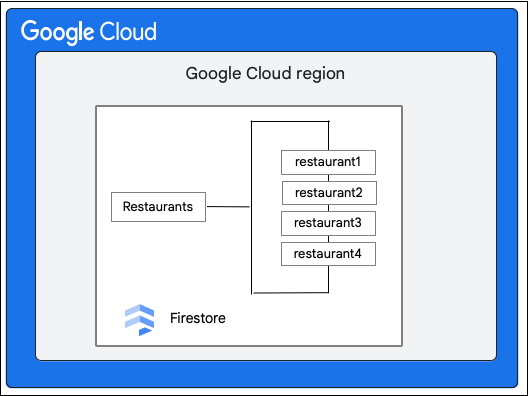
Prenons l'exemple d'une base de données Cloud Firestore contenant la collection Restaurants suivante :
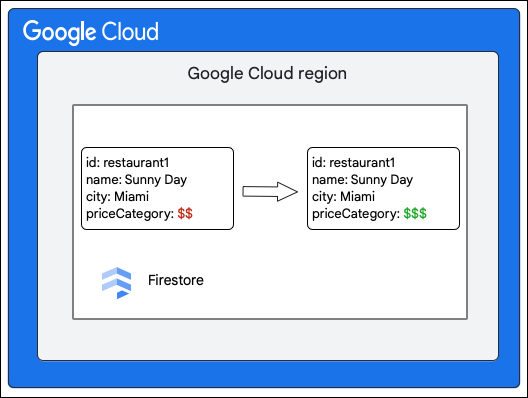
Le client Cloud Firestore demande la modification suivante d'un document de la collection Restaurant en mettant à jour la valeur du champ priceCategory.
Les étapes générales suivantes décrivent ce qui se passe lors de l'écriture :
- Créez une transaction en lecture-écriture.
- Lisez le document
restaurant1dans la collectionRestaurantsà partir de la table Documents de la couche de stockage. - Lisez les index du document à partir de la table Indexes.
- Calculer les mutations à apporter aux données. Dans ce cas, il existe cinq mutations :
- M1 : Mettez à jour la ligne pour
restaurant1dans la table Documents afin de refléter la modification de la valeur du champpriceCategory. - M2 et M3 : supprimez les lignes de l'ancienne valeur de
priceCategorydans la table Indexes pour les index décroissants et croissants. - M4 et M5 : insérez les lignes de la nouvelle valeur de
priceCategorydans la table Indexes pour les index décroissants et croissants.
- M1 : Mettez à jour la ligne pour
- Validez ces mutations.
Le client de stockage du service Cloud Firestore recherche les divisions qui possèdent les clés des lignes à modifier. Prenons un cas où la division 3 diffuse M1 et la division 6 diffuse M2-M5. Il existe une transaction distribuée, impliquant toutes ces divisions en tant que participants. Les divisions de participants peuvent également inclure toute autre division à partir de laquelle des données ont été lues précédemment dans le cadre de la transaction en lecture-écriture.
Les étapes suivantes décrivent ce qui se passe lors du commit :
- Le client de stockage émet un commit. Le commit contient les mutations M1 à M5.
- Les divisions 3 et 6 sont les participants à cette transaction. L'un des participants est choisi comme coordinateur, par exemple Split 3. Le rôle du coordinateur est de s'assurer que la transaction est validée ou annulée de manière atomique pour tous les participants.
- Les instances dupliquées principales de ces divisions sont responsables du travail effectué par les participants et les coordinateurs.
- Chaque participant et coordinateur exécute un algorithme Paxos avec ses instances répliquées respectives.
- L'instance principale exécute un algorithme Paxos avec les instances répliquées. Le quorum est atteint si la plupart des instances répliquées répondent par une réponse
ok to commitau leader. - Chaque participant informe ensuite le coordinateur lorsqu'il est prêt (première phase de la validation en deux phases). Si un participant ne peut pas valider la transaction, l'ensemble de la transaction
aborts.
- L'instance principale exécute un algorithme Paxos avec les instances répliquées. Le quorum est atteint si la plupart des instances répliquées répondent par une réponse
- Une fois que le coordinateur sait que tous les participants, y compris lui-même, sont prêts, il communique le résultat de la transaction
acceptà tous les participants (deuxième phase de la validation en deux phases). Au cours de cette phase, chaque participant enregistre la décision de commit dans un espace de stockage stable, et la transaction est validée. - Le coordinateur répond au client de stockage dans Cloud Firestore que la transaction a été validée. En parallèle, le coordinateur et tous les participants appliquent les mutations aux données.
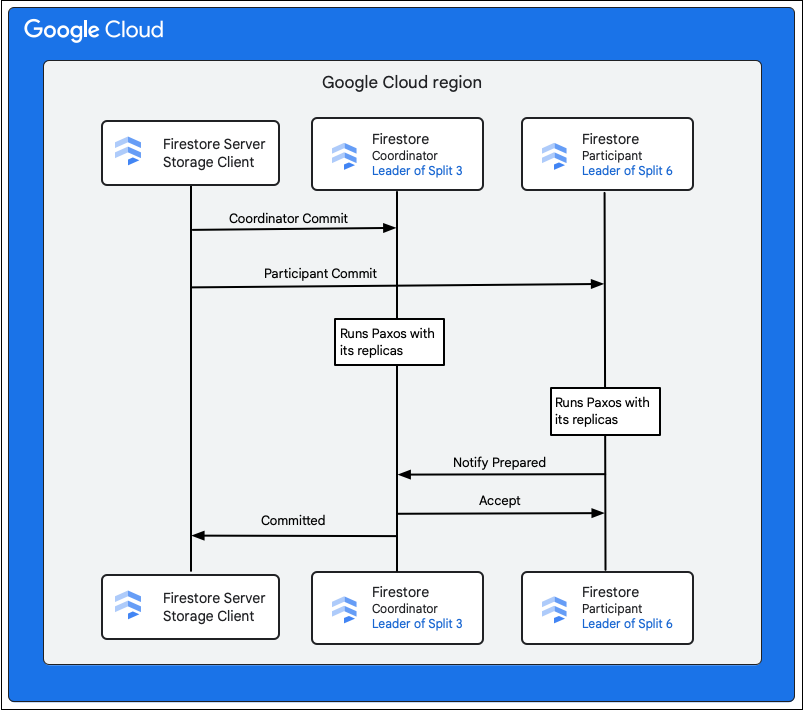
Lorsque la base de données Cloud Firestore est petite, il peut arriver qu'une seule division possède toutes les clés des modifications M1 à M5. Dans ce cas, il n'y a qu'un seul participant à la transaction et la validation en deux phases mentionnée précédemment n'est pas requise, ce qui accélère les écritures.
Écritures multirégionales
Dans un déploiement multirégional, la répartition des instances répliquées entre les régions augmente la disponibilité, mais a un coût en termes de performances. La communication entre les instances répliquées dans différentes régions prend plus de temps. Par conséquent, la latence de référence pour les opérations Cloud Firestore est légèrement supérieure à celle des déploiements dans une seule région.
Nous configurons les instances répliquées de manière à ce que le leadership des divisions reste toujours dans la région principale. La région principale est celle d'où provient le trafic entrant vers le serveur Cloud Firestore. Cette décision de leadership réduit le délai d'aller-retour dans la communication entre le client de stockage dans Cloud Firestore et le leader de l'instance répliquée (ou le coordinateur pour les transactions à plusieurs divisions).
Chaque écriture dans Cloud Firestore implique également une interaction avec le moteur en temps réel dans Cloud Firestore. Pour en savoir plus sur les requêtes en temps réel, consultez Comprendre les requêtes en temps réel à grande échelle.
Comprendre le cycle de vie d'une lecture dans Cloud Firestore
Cette section traite des lectures autonomes non en temps réel dans Cloud Firestore. En interne, le serveur Cloud Firestore gère la plupart de ces requêtes en deux étapes principales :
- Une seule analyse de plage sur la table Indexes
- Recherches ponctuelles dans la table Documents en fonction du résultat de l'analyse précédente
Les lectures de données à partir de la couche de stockage sont effectuées en interne à l'aide d'une transaction de base de données pour garantir des lectures cohérentes. Toutefois, contrairement aux transactions utilisées pour les écritures, ces transactions n'utilisent pas de verrous. Elles fonctionnent en choisissant un code temporel, puis en exécutant toutes les lectures à ce code temporel. Comme elles n'acquièrent pas de verrous, elles ne bloquent pas les transactions en lecture-écriture simultanées. Pour exécuter cette transaction, le client de stockage dans Cloud Firestore spécifie une limite de code temporel, qui indique à la couche de stockage comment choisir un code temporel de lecture. Le type de limite de code temporel choisi par le client de stockage dans Cloud Firestore est déterminé par les options de lecture de la requête de lecture.
Comprendre une transaction de lecture dans la couche de stockage
Cette section décrit les types de lectures et la façon dont elles sont traitées dans la couche de stockage de Cloud Firestore.
Lectures fortes
Par défaut, les lectures Cloud Firestore sont fortement cohérentes. Cette cohérence forte signifie qu'une lecture Cloud Firestore renvoie la dernière version des données, qui reflète toutes les écritures validées jusqu'au début de la lecture.
Lecture d'une seule division
Le client de stockage dans Cloud Firestore recherche les divisions qui possèdent les clés des lignes à lire. Supposons qu'il doive effectuer une lecture à partir de la division 3 de la section précédente. Le client envoie la requête de lecture à l'instance répliquée la plus proche pour réduire la latence des allers-retours.
À ce stade, les cas suivants peuvent se produire en fonction de l'instance répliquée choisie :
- La requête de lecture est transmise à une instance répliquée principale (zone A).
- Comme le leader est toujours à jour, la lecture peut se poursuivre directement.
- La requête de lecture est transmise à une instance répliquée non principale (par exemple, la zone B)
- La division 3 peut savoir, grâce à son état interne, qu'elle dispose de suffisamment d'informations pour diffuser la lecture, et elle le fait.
- Split 3 n'est pas sûr d'avoir vu les dernières données. Il envoie un message au nœud principal pour lui demander le code temporel de la dernière transaction qu'il doit appliquer pour diffuser la lecture. Une fois cette transaction appliquée, la lecture peut se poursuivre.
Cloud Firestore renvoie ensuite la réponse à son client.
Lecture sur plusieurs divisions
Si les lectures doivent être effectuées à partir de plusieurs divisions, le même mécanisme se produit sur toutes les divisions. Une fois que les données ont été renvoyées par toutes les divisions, le client de stockage dans Cloud Firestore combine les résultats. Cloud Firestore répond ensuite à son client avec ces données.
Lectures non actualisées
Les lectures fortes sont le mode par défaut dans Cloud Firestore. Cependant, cela peut entraîner une latence plus élevée en raison de la communication qui peut être requise avec le leader. Souvent, votre application Cloud Firestore n'a pas besoin de lire la dernière version des données, et la fonctionnalité fonctionne bien avec des données qui peuvent être obsolètes de quelques secondes.
Dans ce cas, le client peut choisir de recevoir des lectures non actualisées à l'aide des options de lecture read_time. Dans ce cas, les lectures sont effectuées telles que les données étaient à read_time, et l'instance répliquée la plus proche a très probablement déjà vérifié qu'elle disposait de données au read_time spécifié.
Pour obtenir des performances nettement meilleures, 15 secondes est une valeur d'obsolescence raisonnable. Même pour les lectures non actualisées, les lignes générées sont cohérentes entre elles.
Éviter les hotspots
Les divisions de Cloud Firestore sont automatiquement fractionnées en plus petits morceaux pour répartir le travail de diffusion du trafic sur davantage de serveurs de stockage si nécessaire ou lorsque l'espace de clés s'étend. Les divisions créées pour gérer l'excès de trafic sont conservées pendant environ 24 heures, même si le trafic diminue. Ainsi, en cas de pics de trafic récurrents, les divisions sont conservées et d'autres sont introduites chaque fois que nécessaire. Ces mécanismes permettent aux bases de données Cloud Firestore d'effectuer un autoscaling en cas d'augmentation de la charge de trafic ou de la taille de la base de données. Toutefois, il existe certaines limites à prendre en compte, comme expliqué ci-dessous.
La répartition du stockage et de la charge prend du temps. Si vous augmentez le trafic trop rapidement, vous risquez de rencontrer une latence élevée ou des erreurs de dépassement de délai, communément appelées points d'accès, pendant que le service s'ajuste. La bonne pratique consiste à répartir les opérations sur la plage de clés, tout en augmentant le trafic sur une collection d'une base de données avec 500 opérations par seconde. Après cette augmentation progressive, augmentez le trafic de 50% maximum toutes les cinq minutes. Ce processus est appelé la règle 500/50/5. Il permet de dimensionner la base de données de manière optimale pour répondre à votre charge de travail.
Bien que les divisions soient créées automatiquement avec une charge croissante, Cloud Firestore ne peut diviser une plage de clés que jusqu'à ce qu'elle diffuse un seul document à l'aide d'un ensemble dédié de serveurs de stockage répliqués. Par conséquent, des volumes élevés et soutenus d'opérations simultanées sur un même document peuvent entraîner un hotspot sur ce document. Si vous rencontrez des latences élevées et prolongées sur un seul document, vous devriez envisager de modifier votre modèle de données pour diviser ou répliquer les données sur plusieurs documents.
Les erreurs de conflit se produisent lorsque plusieurs opérations tentent de lire et/ou d'écrire simultanément dans le même document.
Un autre cas particulier de hotspotting se produit lorsqu'une clé séquentiellement croissante/décroissante est utilisée comme ID de document dans Cloud Firestore et qu'il existe un nombre considérablement élevé d'opérations par seconde. Créer d'autres divisions n'est pas utile ici, car l'augmentation du trafic se déplace simplement vers la division nouvellement créée. Étant donné que Cloud Firestore indexe automatiquement tous les champs du document par défaut, ces hotspots mobiles peuvent également être créés sur l'espace d'index d'un champ de document contenant une valeur qui augmente ou diminue de manière séquentielle, comme un code temporel.
Notez qu'en suivant les pratiques décrites ci-dessus, Cloud Firestore peut évoluer pour diffuser des charges de travail arbitrairement volumineuses sans que vous ayez à ajuster une configuration.
Dépannage
Cloud Firestore fournit Key Visualizer, un outil de diagnostic conçu pour analyser les schémas d'utilisation et résoudre les problèmes de hotspots.
Étape suivante
- En savoir plus sur les bonnes pratiques
- En savoir plus sur les requêtes en temps réel à grande échelle