

Lesen Sie dieses Dokument, um fundierte Entscheidungen zur Architektur Ihrer Anwendungen für hohe Leistung und Zuverlässigkeit zu treffen. Dieses Dokument enthält erweiterte Cloud Firestore-Themen. Wenn Sie gerade erst mit Cloud Firestore beginnen, lesen Sie stattdessen die Kurzanleitung.
Cloud Firestore ist eine flexible, skalierbare Datenbank für die Mobil-, Web- und Serverentwicklung über Firebase und Google Cloud. Der Einstieg in Cloud Firestore und das Schreiben leistungsstarker Anwendungen ist sehr einfach.
Damit Ihre Anwendungen auch bei zunehmender Datenbankgröße und steigendem Traffic weiterhin eine gute Leistung erbringen, ist es hilfreich, die Mechanismen von Lese- und Schreibvorgängen im Cloud Firestore-Backend zu verstehen. Sie müssen auch die Interaktion Ihrer Lese- und Schreibvorgänge mit der Speicherebene und die zugrunde liegenden Einschränkungen verstehen, die sich auf die Leistung auswirken können.
In den folgenden Abschnitten finden Sie Best Practices, die Sie vor dem Entwerfen Ihrer Anwendung beachten sollten.
Allgemeine Komponenten
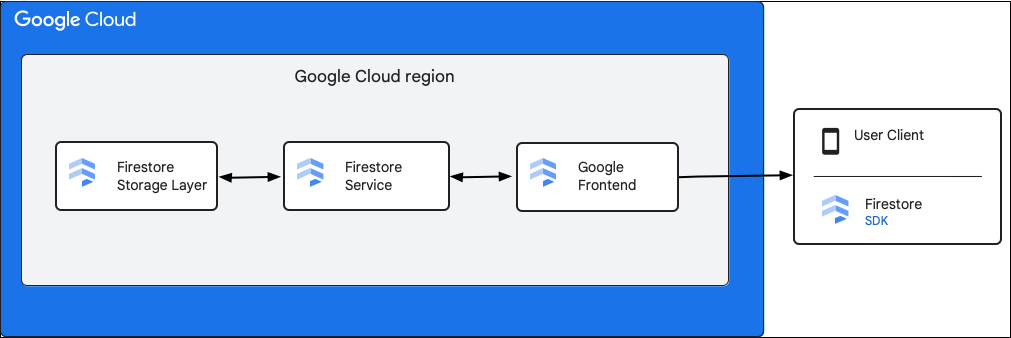
Das folgende Diagramm zeigt die allgemeinen Komponenten, die an einer Cloud Firestore-API-Anfrage beteiligt sind.
Cloud Firestore SDK und Clientbibliotheken
Cloud Firestore unterstützt SDKs und Clientbibliotheken für verschiedene Plattformen. Eine App kann zwar direkte HTTP- und RPC-Aufrufe an die Cloud Firestore API senden, die Clientbibliotheken bieten jedoch eine Abstraktionsebene, um die API-Nutzung zu vereinfachen und Best Practices zu implementieren. Möglicherweise bieten sie auch zusätzliche Funktionen wie Offlinezugriff, Caches usw.
Google Front End (GFE)
Dies ist ein Infrastrukturdienst, der allen Google Cloud-Diensten gemeinsam ist. Das GFE akzeptiert eingehende Anfragen und leitet sie an den entsprechenden Google-Dienst weiter (in diesem Kontext den Cloud Firestore-Dienst). Es bietet auch andere wichtige Funktionen, darunter Schutz vor Denial-of-Service-Angriffen.
Dienst Cloud Firestore
Der Cloud Firestore-Dienst führt Prüfungen der API-Anfrage durch, einschließlich Authentifizierung, Autorisierung, Kontingentprüfungen und Sicherheitsregeln, und verwaltet auch Transaktionen. Dieser Cloud Firestore-Dienst enthält einen Speicherclient, der mit der Speicherebene für die Lese- und Schreibvorgänge interagiert.
Cloud Firestore-Speicherebene
Die Speicherebene Cloud Firestore ist für das Speichern der Daten und Metadaten sowie für die zugehörigen Datenbankfunktionen von Cloud Firestore verantwortlich. In den folgenden Abschnitten wird beschrieben, wie Daten in der Cloud Firestore-Speicherebene organisiert sind und wie das System skaliert wird. Wenn Sie sich mit der Organisation von Daten vertraut machen, können Sie ein skalierbares Datenmodell entwerfen und die Best Practices in Cloud Firestore besser verstehen.
Schlüsselbereiche und Aufteilungen
Cloud Firestore ist eine dokumentenbasierte NoSQL-Datenbank. Sie speichern Daten in Dokumenten, die in Hierarchien von Sammlungen organisiert sind. Die Sammlungshierarchie und die Dokument-ID werden für jedes Dokument in einen einzelnen Schlüssel übersetzt. Dokumente werden logisch gespeichert und lexikografisch nach diesem einzelnen Schlüssel sortiert. Mit dem Begriff „Schlüsselbereich“ bezeichnen wir einen lexikografisch zusammenhängenden Bereich von Schlüsseln.
Eine typische Cloud Firestore-Datenbank ist zu groß, um auf einen einzelnen physischen Computer zu passen. Es gibt auch Szenarien, in denen die Arbeitslast für die Daten zu hoch ist, um von einem einzelnen Computer bewältigt zu werden. Zur Verarbeitung großer Arbeitslasten partitioniert Cloud Firestore die Daten in separate Teile, die auf mehreren Maschinen oder Speicherservern gespeichert und von diesen bereitgestellt werden können. Diese Partitionen werden in den Datenbanktabellen in Blöcken von Schlüsselbereichen erstellt, die als Splits bezeichnet werden.
Synchrone Replikation
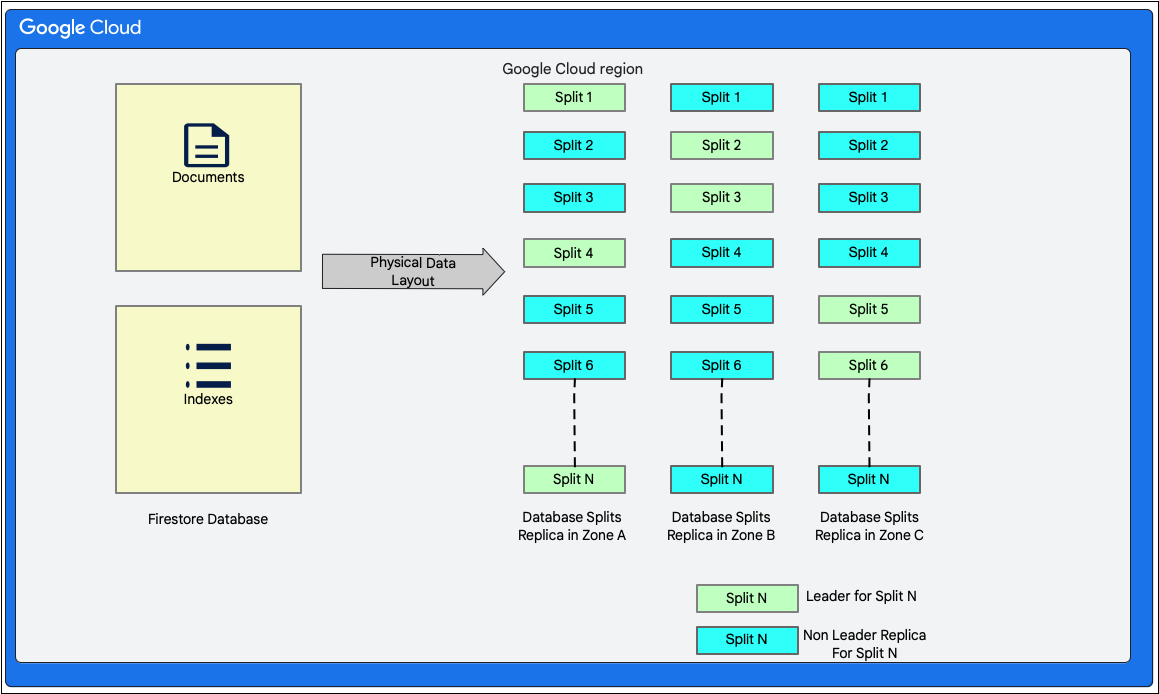
Die Datenbank wird immer automatisch und synchron repliziert. Die Datenaufteilungen haben Replikate in verschiedenen Zonen, damit sie auch dann verfügbar sind, wenn eine Zone nicht mehr zugänglich ist. Die konsistente Replikation auf die verschiedenen Kopien des Splits wird durch den Paxos-Algorithmus für den Konsens verwaltet. Ein Replikat jedes Splits wird als Paxos-Leader ausgewählt, der für die Verarbeitung von Schreibvorgängen in diesem Split verantwortlich ist. Durch die synchrone Replikation können Sie immer die aktuelle Version der Daten aus Cloud Firestore lesen.
Das Gesamtergebnis ist ein skalierbares und hochverfügbares System, das sowohl für Lese- als auch für Schreibvorgänge niedrige Latenzen bietet, unabhängig von hohen Arbeitslasten und bei sehr großem Umfang.
Datenlayout
Cloud Firestore ist eine schemalose Dokumentendatenbank. Intern werden die Daten jedoch hauptsächlich in zwei Tabellen im Stil einer relationalen Datenbank in der Speicherebene angeordnet:
- Tabelle Documents: In dieser Tabelle werden Dokumente gespeichert.
- Tabelle Indexes: In dieser Tabelle werden Indexeinträge gespeichert, mit denen Ergebnisse effizient und nach Indexwert sortiert abgerufen werden können.
Das folgende Diagramm zeigt, wie die Tabellen für eine Cloud Firestore-Datenbank mit den Aufteilungen aussehen könnten. Die Splits werden in drei verschiedenen Zonen repliziert und jedem Split ist ein Paxos-Leader zugewiesen.
Einzelne Region im Vergleich zu mehreren Regionen
Wenn Sie eine Datenbank erstellen, müssen Sie eine Region oder einen multiregionalen Standort auswählen.
Ein einzelner regionaler Standort ist ein bestimmter geografischer Standort, z. B. us-west1. Die Datenaufteilungen einer Cloud Firestore-Datenbank haben Replikate in verschiedenen Zonen innerhalb der ausgewählten Region, wie bereits erläutert.
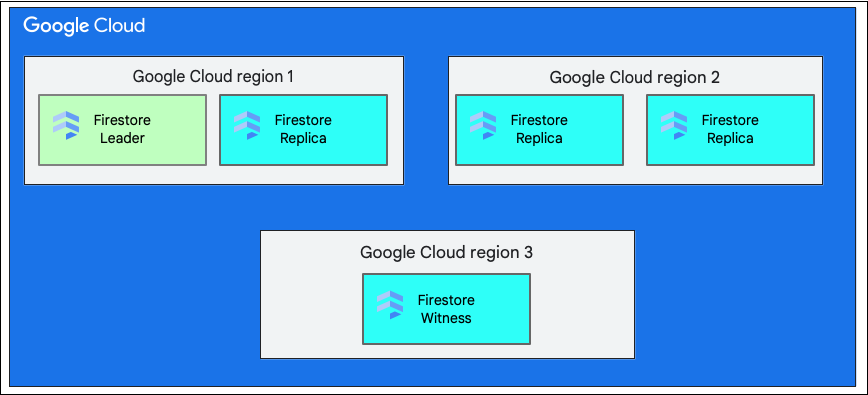
Ein multiregionaler Standort besteht aus einer definierten Gruppe von Regionen, in denen Replikate der Datenbank gespeichert werden. In einer multiregionalen Bereitstellung von Cloud Firestore haben zwei der Regionen vollständige Replikate aller Daten in der Datenbank. Eine dritte Region hat ein Witness-Replikat, das keinen vollständigen Datensatz enthält, aber an der Replikation beteiligt ist. Durch die Replikation der Daten zwischen mehreren Regionen können Daten auch dann geschrieben und gelesen werden, wenn eine gesamte Region ausfällt.
Weitere Informationen zu den Standorten einer Region finden Sie unter Cloud Firestore-Standorte.
Lebenszyklus eines Schreibvorgangs in Cloud Firestore verstehen
Ein Cloud Firestore-Client kann Daten schreiben, indem er ein einzelnes Dokument erstellt, aktualisiert oder löscht. Bei einem Schreibvorgang in ein einzelnes Dokument müssen sowohl das Dokument als auch die zugehörigen Indexeinträge atomar auf der Speicherebene aktualisiert werden. Cloud Firestore unterstützt auch atomare Vorgänge, die aus mehreren Lese- und/oder Schreibvorgängen in einem oder mehreren Dokumenten bestehen.
Für alle Arten von Schreibvorgängen bietet Cloud Firestore die ACID-Eigenschaften (Atomarität, Konsistenz, Isolation und Langlebigkeit) relationaler Datenbanken. Cloud Firestore bietet auch Serialisierbarkeit. Das bedeutet, dass alle Transaktionen so angezeigt werden, als wären sie in einer seriellen Reihenfolge ausgeführt worden.
Allgemeine Schritte in einer Schreibtransaktion
Wenn der Cloud Firestore-Client einen Schreibvorgang ausgibt oder eine Transaktion mit einer der oben genannten Methoden festschreibt, wird dies intern als Lese-/Schreibtransaktion der Datenbank in der Speicherebene ausgeführt. Die Transaktion ermöglicht es Cloud Firestore, die zuvor erwähnten ACID-Eigenschaften bereitzustellen.
Im ersten Schritt einer Transaktion liest Cloud Firestore das vorhandene Dokument und bestimmt die Mutationen, die an den Daten in der Tabelle „Documents“ vorgenommen werden sollen.
Dazu gehören auch die folgenden erforderlichen Aktualisierungen der Tabelle „Indexes“:
- Für Felder, die den Dokumenten hinzugefügt werden, sind entsprechende Einträge in der Tabelle „Indexes“ erforderlich.
- Felder, die aus den Dokumenten entfernt werden, müssen auch in der Tabelle „Indexes“ gelöscht werden.
- Für Felder, die in den Dokumenten geändert werden, sind sowohl Löschvorgänge (für alte Werte) als auch Einfügevorgänge (für neue Werte) in der Tabelle „Indexes“ erforderlich.
Um die oben genannten Mutationen zu berechnen, liest Cloud Firestore die Indexierungskonfiguration für die Datenbank. In der Indexierungskonfiguration werden Informationen zu den Indexen für eine Datenbank gespeichert. Cloud Firestore verwendet zwei Arten von Indexen: Einzelfeld- und zusammengesetzte Indexe. Ausführliche Informationen zu den in Cloud Firestore erstellten Indexen finden Sie unter Indextypen in Cloud Firestore.
Sobald die Mutationen berechnet wurden, werden sie von Cloud Firestore in einer Transaktion erfasst und dann per Commit übertragen.
Schreibtransaktion in der Speicherebene verstehen
Wie bereits erwähnt, umfasst ein Schreibvorgang in Cloud Firestore eine Lese-/Schreibtransaktion auf der Speicherebene. Je nach Datenlayout kann ein Schreibvorgang einen oder mehrere Splits umfassen, wie im Datenlayout zu sehen ist.
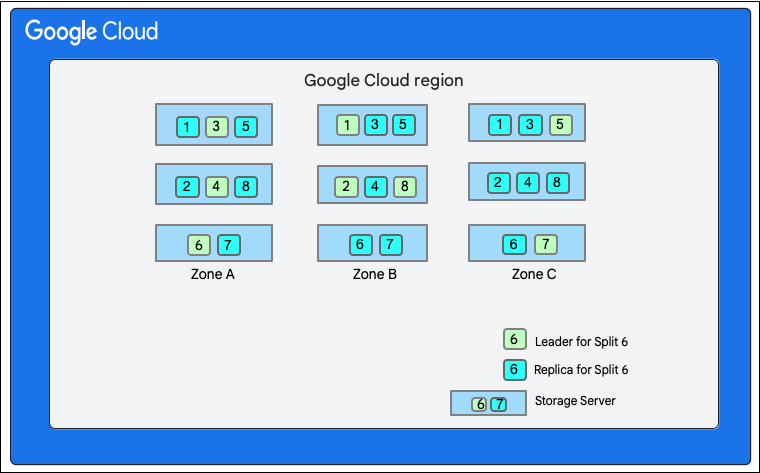
Im folgenden Diagramm hat die Datenbank Cloud Firestore acht Splits (mit 1–8 gekennzeichnet), die auf drei verschiedenen Speicherservern in einer einzelnen Zone gehostet werden. Jeder Split wird in drei(oder mehr) verschiedenen Zonen repliziert. Jeder Split hat einen Paxos-Leader, der sich für verschiedene Splits in einer anderen Zone befinden kann.
 Cloud Firestore-Datenbankaufteilung">
Angenommen, Sie haben eine Cloud Firestore-Datenbank mit der Sammlung Restaurants:
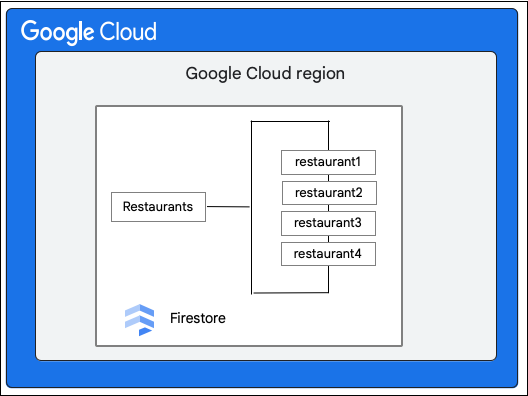
Der Cloud Firestore-Client fordert die folgende Änderung an einem Dokument in der Sammlung Restaurant an, indem er den Wert des Felds priceCategory aktualisiert.
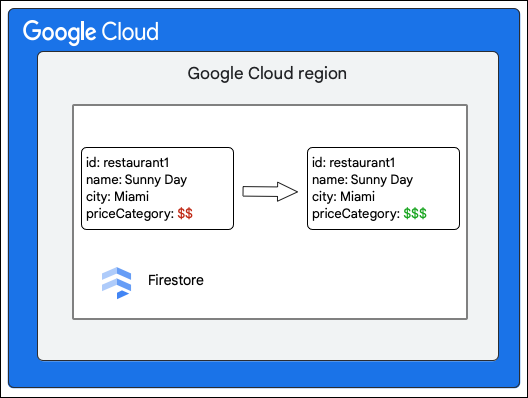
In den folgenden allgemeinen Schritten wird beschrieben, was beim Schreiben geschieht:
- Erstellen Sie eine Lese-/Schreibtransaktion.
- Lesen Sie das Dokument
restaurant1in der SammlungRestaurantsaus der Tabelle Dokumente aus der Speicherebene. - Lesen Sie die Indexe für das Dokument aus der Tabelle Indexes.
- Berechnen Sie die Mutationen, die an den Daten vorgenommen werden sollen. In diesem Fall gibt es fünf Mutationen:
- M1: Aktualisieren Sie die Zeile für
restaurant1in der Tabelle Documents, um die Änderung des Werts im FeldpriceCategorywiderzuspiegeln. - M2 und M3: Löschen Sie die Zeilen für den alten Wert von
priceCategoryin der Tabelle Indexes für absteigende und aufsteigende Indexe. - M4 und M5: Fügen Sie die Zeilen für den neuen Wert von
priceCategoryin die Tabelle Indexes für absteigende und aufsteigende Indexe ein.
- M1: Aktualisieren Sie die Zeile für
- Führen Sie einen Commit für diese Mutationen durch.
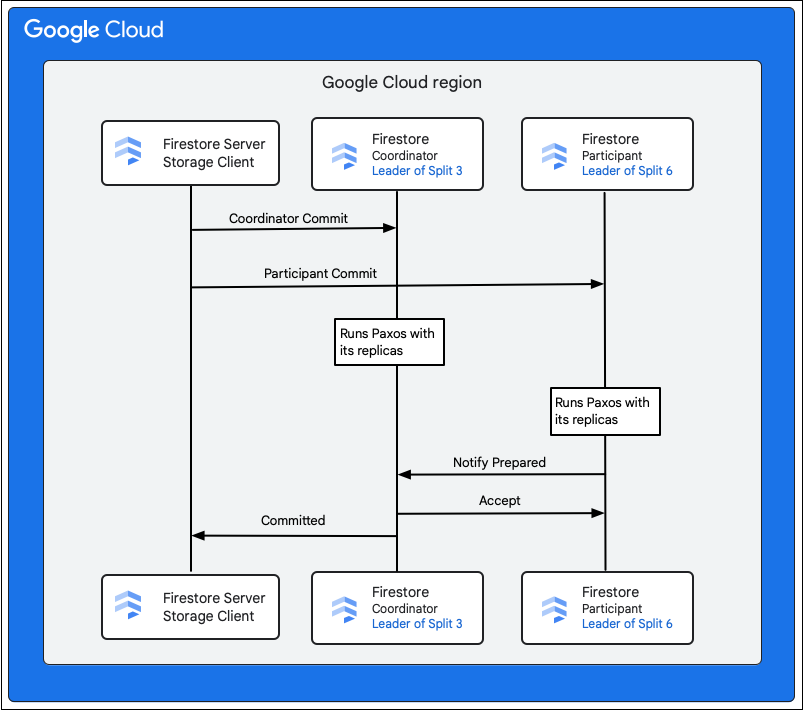
Der Speicherclient im Dienst Cloud Firestore sucht nach den Splits, die die Schlüssel der zu ändernden Zeilen enthalten. Sehen wir uns einen Fall an, in dem Split 3 M1 und Split 6 M2–M5 bedient. Es gibt eine verteilte Transaktion, an der alle diese Splits als Teilnehmer beteiligt sind. Die Teilnehmer-Splits können auch alle anderen Splits enthalten, aus denen zuvor im Rahmen der Lese-/Schreibtransaktion Daten gelesen wurden.
In den folgenden Schritten wird beschrieben, was im Rahmen des Commits geschieht:
- Der Speicherclient gibt einen Commit aus. Der Commit enthält die Mutationen M1–M5.
- Die Teilnehmer an dieser Transaktion sind die Splits 3 und 6. Einer der Teilnehmer wird als Koordinator ausgewählt, z. B. Split 3. Die Aufgabe des Koordinators besteht darin, dafür zu sorgen, dass die Transaktion entweder atomar für alle Teilnehmer festgeschrieben oder abgebrochen wird.
- Die Leader-Replikate dieser Splits sind für die Arbeit der Teilnehmer und Koordinatoren verantwortlich.
- Jeder Teilnehmer und Koordinator führt einen Paxos-Algorithmus mit seinen jeweiligen Replikaten aus.
- Der Leader führt einen Paxos-Algorithmus mit den Replikaten aus. Ein Quorum wird erreicht, wenn die meisten Replikate dem Leader mit einer
ok to commit-Antwort antworten. - Jeder Teilnehmer benachrichtigt dann den Koordinator, wenn er bereit ist (erste Phase des zweiphasigen Commits). Wenn ein Teilnehmer die Transaktion nicht festschreiben kann, wird die gesamte Transaktion
aborts.
- Der Leader führt einen Paxos-Algorithmus mit den Replikaten aus. Ein Quorum wird erreicht, wenn die meisten Replikate dem Leader mit einer
- Sobald der Koordinator weiß, dass alle Teilnehmer, einschließlich ihm selbst, bereit sind, teilt er allen Teilnehmern das Transaktionsergebnis
acceptmit (zweite Phase des Two-Phase-Commit). In dieser Phase zeichnet jeder Teilnehmer die Commit-Entscheidung im stabilen Speicher auf und die Transaktion wird festgeschrieben. - Der Koordinator antwortet dem Speicherclient in Cloud Firestore, dass die Transaktion festgeschrieben wurde. Parallel dazu wenden der Koordinator und alle Teilnehmer die Mutationen auf die Daten an.
Wenn die Datenbank Cloud Firestore klein ist, kann es vorkommen, dass ein einzelner Split alle Schlüssel in den Mutationen M1–M5 enthält. In einem solchen Fall gibt es nur einen Teilnehmer an der Transaktion und das zuvor erwähnte Two-Phase-Commit ist nicht erforderlich, was die Schreibvorgänge beschleunigt.
Schreibvorgänge in mehreren Regionen
Bei einer multiregionalen Bereitstellung erhöht die Verteilung von Replikaten über Regionen die Verfügbarkeit, führt aber zu Leistungseinbußen. Die Kommunikation zwischen Replikaten in verschiedenen Regionen dauert länger. Daher ist die Baseline-Latenz für Cloud Firestore-Vorgänge etwas höher als bei Bereitstellungen in einer einzelnen Region.
Wir konfigurieren die Replikate so, dass die Führung für Splits immer in der primären Region bleibt. Die primäre Region ist die Region, aus der Traffic beim Cloud Firestore-Server eingeht. Diese Entscheidung des Leaders reduziert die Roundtrip-Verzögerung bei der Kommunikation zwischen dem Speicherclient in Cloud Firestore und dem Replikat-Leader (oder Koordinator für Transaktionen mit mehreren Splits).
Jeder Schreibvorgang in Cloud Firestore beinhaltet auch eine Interaktion mit der Echtzeit-Engine in Cloud Firestore. Weitere Informationen zu Echtzeitabfragen finden Sie unter Echtzeitabfragen im großen Maßstab.
Lebenszyklus eines Lesevorgangs in Cloud Firestore
In diesem Abschnitt werden eigenständige, nicht echtzeitfähige Lesevorgänge in Cloud Firestore behandelt. Intern verarbeitet der Cloud Firestore-Server die meisten dieser Abfragen in zwei Hauptphasen:
- Ein einzelner Bereichsscan über die Tabelle Indexes
- Punktabfragen in der Tabelle Documents basierend auf dem Ergebnis des vorherigen Scans
Die Datenlesevorgänge aus der Speicherebene werden intern mithilfe einer Datenbanktransaktion ausgeführt, um konsistente Lesevorgänge zu gewährleisten. Im Gegensatz zu den für Schreibvorgänge verwendeten Transaktionen werden bei diesen Transaktionen jedoch keine Sperren verwendet. Stattdessen wird ein Zeitstempel ausgewählt und dann werden alle Lesevorgänge zu diesem Zeitstempel ausgeführt. Da sie keine Sperren erwerben, blockieren sie keine gleichzeitigen Lese-/Schreibtransaktionen. Um diese Transaktion auszuführen, gibt der Speicherclient in Cloud Firestore eine Zeitstempelgrenze an, die der Speicherebene mitteilt, wie ein Lesezeitstempel ausgewählt werden soll. Der Typ der Zeitstempelgrenze, die vom Speicherclient in Cloud Firestore ausgewählt wird, wird durch die Leseoptionen für die Leseanfrage bestimmt.
Lesetransaktion in der Speicherebene verstehen
In diesem Abschnitt werden die Arten von Lesevorgängen und ihre Verarbeitung in der Speicherebene in Cloud Firestore beschrieben.
Starke Lesevorgänge
Standardmäßig sind Cloud Firestore-Lesevorgänge strikt konsistent. Diese strikte Konsistenz bedeutet, dass ein Cloud Firestore-Lesevorgang die neueste Version der Daten zurückgibt, die alle Schreibvorgänge widerspiegelt, die bis zum Beginn des Lesevorgangs festgeschrieben wurden.
Lesevorgang für einen einzelnen Split
Der Speicherclient in Cloud Firestore sucht nach den Splits, die die Schlüssel der zu lesenden Zeilen enthalten. Angenommen, es muss ein Lesevorgang aus Split 3 aus dem vorherigen Abschnitt ausgeführt werden. Der Client sendet die Leseanfrage an das nächstgelegene Replikat, um die Roundtrip-Latenz zu reduzieren.
An dieser Stelle können je nach ausgewähltem Replikat die folgenden Fälle auftreten:
- Die Leseanfrage wird an ein Leader-Replikat (Zone A) gesendet.
- Da der Leader immer auf dem neuesten Stand ist, kann der Lesevorgang direkt fortgesetzt werden.
- Leseanfrage geht an ein Nicht-Leader-Replikat (z. B. Zone B)
- Split 3 weiß möglicherweise aufgrund seines internen Status, dass es genügend Informationen hat, um den Lesevorgang zu bedienen, und führt ihn aus.
- Split 3 ist sich nicht sicher, ob die neuesten Daten vorliegen. Es sendet eine Nachricht an den Leader, um den Zeitstempel der letzten Transaktion anzufordern, die es anwenden muss, um den Lesevorgang auszuführen. Sobald diese Transaktion angewendet wurde, kann der Lesevorgang fortgesetzt werden.
Cloud Firestore gibt die Antwort dann an den Client zurück.
Multi-Split-Lesevorgang
Wenn die Lesevorgänge aus mehreren Splits erfolgen müssen, wird derselbe Mechanismus für alle Splits verwendet. Sobald die Daten aus allen Aufteilungen zurückgegeben wurden, kombiniert der Speicherclient in Cloud Firestore die Ergebnisse. Cloud Firestore antwortet dann mit diesen Daten auf den Client.
Lesevorgänge veralteter Daten
Starke Lesevorgänge sind der Standardmodus in Cloud Firestore. Dies kann jedoch aufgrund der möglicherweise erforderlichen Kommunikation mit dem Leader zu einer höheren Latenz führen. Häufig muss Ihre Cloud Firestore-Anwendung nicht die aktuelle Version der Daten lesen und die Funktionalität funktioniert gut mit Daten, die möglicherweise einige Sekunden alt sind.
In einem solchen Fall kann der Client mit den Leseoptionen read_time festlegen, dass Lesevorgänge veralteter Daten empfangen werden. In diesem Fall werden Lesevorgänge so ausgeführt, wie die Daten um read_time waren. Das nächstgelegene Replikat hat höchstwahrscheinlich bereits bestätigt, dass es Daten zum angegebenen read_time hat.
Für eine spürbar bessere Leistung sind 15 Sekunden ein angemessener Wert für die Veraltung. Auch bei Lesevorgängen veralteter Daten sind die zurückgegebenen Zeilen konsistent.
Heißlaufen vermeiden
Die Splits in Cloud Firestore werden automatisch in kleinere Teile aufgeteilt, um die Arbeit der Traffic-Bereitstellung bei Bedarf oder bei einer Erweiterung des Schlüsselbereichs auf mehr Speicherserver zu verteilen. Splits, die zur Bewältigung von übermäßigem Traffic erstellt wurden, werden etwa 24 Stunden lang beibehalten, auch wenn der Traffic zurückgeht. Wenn es also wiederkehrende Traffic-Spitzen gibt, werden die Aufteilungen beibehalten und bei Bedarf weitere Aufteilungen eingeführt. Diese Mechanismen helfen Cloud Firestore-Datenbanken, bei zunehmender Trafficlast oder Datenbankgröße automatisch zu skalieren. Es gibt jedoch einige Einschränkungen, die Sie beachten sollten, wie unten erläutert.
Das Aufteilen von Speicher und Last nimmt Zeit in Anspruch. Wenn der Traffic zu schnell erhöht wird, kann es zu hoher Latenz oder Fehlern vom Typ „Frist überschritten“ kommen, die häufig als Hotspots bezeichnet werden, während der Dienst angepasst wird. Es empfiehlt sich, Vorgänge über den Schlüsselbereich zu verteilen und gleichzeitig den Traffic für eine Sammlung in einer Datenbank mit 500 Vorgängen pro Sekunde zu erhöhen. Nach dieser schrittweisen Erhöhung können Sie den Traffic alle fünf Minuten um bis zu 50% erhöhen. Dieser Prozess wird als 500/50/5-Regel bezeichnet und sorgt dafür, dass die Datenbank optimal skaliert werden kann, um Ihre Arbeitslast zu bewältigen.
Splits werden zwar automatisch erstellt, wenn die Last steigt, aber Cloud Firestore kann einen Schlüsselbereich nur so lange aufteilen, bis ein einzelnes Dokument über einen dedizierten Satz replizierter Speicherserver bereitgestellt wird. Daher kann eine hohe und anhaltende Anzahl gleichzeitiger Vorgänge für ein einzelnes Dokument zu einem Hotspot für dieses Dokument führen. Wenn bei einem einzelnen Dokument dauerhaft hohe Latenzen auftreten, sollten Sie Ihr Datenmodell so ändern, dass die Daten auf mehrere Dokumente aufgeteilt oder repliziert werden.
Konfliktfehler treten auf, wenn mehrere Vorgänge gleichzeitig versuchen, dasselbe Dokument zu lesen und/oder zu schreiben.
Ein weiterer Sonderfall von Hotspotting tritt auf, wenn ein sequenziell zunehmender/abnehmender Schlüssel als Dokument-ID in Cloud Firestore verwendet wird und eine sehr hohe Anzahl von Vorgängen pro Sekunde ausgeführt wird. Das Erstellen weiterer Splits hilft hier nicht, da der Traffic-Anstieg einfach auf den neu erstellten Split verschoben wird. Da Cloud Firestore standardmäßig alle Felder im Dokument automatisch indexiert, können solche Hotspots auch im Indexbereich für ein Dokumentfeld erstellt werden, das einen sequenziell steigenden/fallenden Wert wie einen Zeitstempel enthält.
Wenn Sie die oben beschriebenen Best Practices befolgen, kann Cloud Firestore beliebig große Arbeitslasten verarbeiten, ohne dass Sie die Konfiguration anpassen müssen.
Fehlerbehebung
Cloud Firestore bietet den Key Visualizer als Diagnosetool, mit dem Sie Nutzungsmuster analysieren und Hotspotting-Probleme beheben können.